
Агрегирование результатов автоматической классификации данных дистанционного зондирования природных объектов
Журнал: Сибирский аэрокосмический журнал @vestnik-sibsau
Рубрика: Информатика, вычислительная техника и управление
Статья в выпуске: 3 т.27, 2026 года.
Бесплатный доступ
Предлагаются методики агрегирования результатов автоматической классификации значений многомерных спектральных данных дистанционного зондирования. Для реализации этой задачи используются модифицированный алгоритм «Форель» и процедура проверки гипотезы об однородности законов распределения случайных величин, характеризующих обнаруженные классы. При ориентировании алгоритмов автоматической классификации на обнаружение множеств значений случайных величин, соответствующих одномодальным фрагментам их плотности вероятности, обоснованным является повторная группировка классов в пространстве их средних значений случайных величин. Для её реализации используется модификация алгоритма «Форель», параметры которого определяются по результатам вычислительного эксперимента. При наличии дополнительной информации о свойствах природного объекта появляется возможность её использования при агрегировании результатов автоматической классификации в пространстве спектральных признаков. В этих условиях агрегирование классов осуществляется на основе проверки гипотез об однородности законов распределения случайных величин, которые характеризуют дополнительную информацию. Для решения этой задачи используется непараметрический алгоритм распознавания образов, соответствующий критерию максимального правдоподобия. Выбор оптимальных коэффициентов размытости ядерных функций алгоритма классификации осуществляется из условия минимума оценки ошибки распознавания образов в режиме «скользящего экзамена». Полученные результаты обобщаются при построении информационного графа, вершины которого соответствуют классам. Между двумя вершинами графа имеется ребро, если ошибка распознавания образов рассматриваемой пары классов достоверно не отличается от 0,5. Для проверки гипотез используется модификация критерия Колмогорова – Смирнова. В макрокласс объединяются классы, соответствующие полному подграфу, которые достоверно не отличаются законами распределения признаков в дополнительной информации. Последовательная процедура формирования макроклассов начинается с обнаружения полного подграфа с максимальным количеством классов. Полученные результаты являются основой формирования решающего правила оценивания принадлежности значений спектральных признаков к сформированным макроклассам. Предложенная методика агрегирования результатов автоматической классификации является актуальной при системном анализе данных дистанционного зондирования.
Короткий адрес: https://sciup.org/148334400
IDS: 148334400 | УДК: 519.7+004.93 | DOI: 10.31772/2712-8970-2026-27-3-390-399
Aggregation of results of automatic classification of remote sensing data of natural objects
Methods for aggregating the results of automatic classification of multidimensional spectral remote sensing data are proposed. This task is accomplished using a modified «Forel» algorithm and a procedure for testing the hypothesis of the homogeneity of the distribution laws of random variables characterizing the detected classes. When automatic classification algorithms are designed to detect sets of random variable values corresponding to unimodal fragments of their probability density, it is reasonable to regroup classes within the space of their mean random variable values. This is implemented using a modification of the “Forel” algorithm, the parameters of which are determined based on the results of a computational experiment. If additional information about the properties of a natural object is available, it can be used to aggregate the results of automatic classification in the spectral feature space. Under these conditions, class aggregation is based on testing the hypothesis of the homogeneity of the distribution laws of the random variables that characterize the additional information. To solve this problem, a nonparametric pattern recognition algorithm that follows the maximum likelihood criterion is used. The optimal blur coefficients of the classification algorithm's kernel functions are selected based on the requirement to minimize the pattern recognition error estimate in the “sliding exam” mode. The obtained results are summarized in the construction of an information graph, the nodes of which correspond to classes. An edge is formed between two graph nodes if the pattern recognition error for a given pair of classes does not differ significantly from 0,5. A modification of the Kolmogorov–Smirnov test is used to test the hypotheses. A macroclass is formed by classes corresponding to a complete subgraph that do not reliably differ in the distribution patterns of features in the additional information. The sequential procedure for forming macroclasses begins with finding the complete subgraph with the maximum number of classes. The results obtained form the basis for developing a decision rule for assessing the membership of spectral feature values in the resulting macroclasses. The proposed method for aggregating the results of automatic classification is relevant for the system analysis of remote sensing data.
Текст научной статьи Агрегирование результатов автоматической классификации данных дистанционного зондирования природных объектов
Обнаружение компактных групп наблюдений в многомерном пространстве спектральных признаков является одной из основных задач системного анализа данных дистанционного зондирования природных объектов. Для её решения используются алгоритмы автоматической классификации [1–11].
Пусть в пространстве спектральных признаков x = ( x v , v = 1, k ) элементов земной поверхности a1 , i = 1, n по данным выборки V = ( x1 , i = 1, n ) с использованием алгоритма автоматической классификации обнаружены компактные группы наблюдений Vj , соответствующие классам Q j , j = 1, M .
Необходимо полученные массивы данных V j , j = 1, M объединить в группы V j , j = 1, M , M < M , которые принадлежат макроклассам Q j , j = 1, M .
Решение этой задачи будем рассматривать в двух направлениях:
-
1. Агрегирование компактных групп наблюдений V j , j = 1, M в массивы данных V j , j = 1, M в пространстве спектральных признаков x = ( xv , v = 1, k ) .
-
2. Агрегирование компактных групп наблюдений V j , j = 1, M при наличии априорных све
дений о свойствах z1, i е I с I = (i = 1, n) части элементов земной поверхности. Например, признак z отражает сведения о степени поражённости лесных массивов сибирским шелкопрядом [12–16].
Решение задачи агрегирования в рамках первого направления зависит от особенностей используемых алгоритмов автоматической классификации. Например, в алгоритме «Форель» количество классов определяется принятым значением параметра r -окрестности, который характеризует меру близости между элементами исходных статистических данных и часто задаётся исследователем [2]. Подобные условия характерны также для алгоритма автоматической классификации методом взаимного поглощения.
Проблема агрегирования результатов автоматической классификации возникает и при введении понятия класса как области значений спектральных признаков, соответствующих одномодальному фрагменту плотности вероятности [3; 4]. Перспективным направлением агрегирования результатов автоматической классификации являются теоретические исследования по обоснованию метода оптимальной дихотомии при решении многоальтернативной задачи распознавания образов.
Цель статьи состоит в разработке новых методов агрегирования результатов автоматической классификации в пространстве спектральных признаков в условиях большого количества классов и наличия априорных сведений о свойствах исследуемых объектов.
Метод повторной автоматической классификации
Пусть в результате применения непараметрического алгоритма автоматической классификации обнаружено M классов [3; 4]. Каждый класс соответствует одномодальному фрагменту плотности вероятности p ( x ) многомерной случайной величины x = ( x v , v = 1, k ) . Обозначим через x vj , v = 1, k оценки математических ожиданий компонент спектральных признаков x в классах Q j j = 1, M , которые близки к модам плотности вероятности p ( x ) .
Рассмотрим задачу повторной автоматической классификации многомерных спектральных признаков V = ( x j , v = 1, k , j = 1, M ) при больших значениях M . В качестве алгоритма автоматической классификации будем использовать модификацию алгоритма «Форель» [2]. Определим r -окрестность вокруг наблюдения x t , которое отнесём к первому макроклассу Q 1 . Тогда на первом этапе автоматической классификации к Q 1 будут отнесены элементы из массива данных V в соответствии с правилом [17; 18]
m 1 ( xj ) : xj eQ 1 , если d ( x t , xj ) < r , j = 1, M ,
где k2 d (xt, xj ) = ^l xt- xj)
V v = 1
-
- расстояние между наблюдениями x:‘ и xj , v = 1, k .
Пусть на первом этапе автоматической классификации к макроклассу Q1 будут отнесены элементы массива V с номерами, образующих множество I11 . В множество I11 включается номер t первого элемента xt, отнесённого к Q1. На втором этапе автоматической классификации к макроклассу Q1 будут отнесены элементы массива V , которые удовлетворяют правилу m2 (xj): xj еИ1,если d (x1, xj )< r , i e 111, j e I \ 111,
где I = ( l = 1, M ) . Пусть правилу (2) удовлетворяют элементы массива данных V с номерами 1 12 . На этом этапе макрокласс Q 1 дополняется элементами x j массива данных V с номерами I 2 ( 1 ) = ( 1 1 ^ 1 12 ) , которые исключаются из множества I .
По аналогии на этапе повторной автоматической классификации под номером q к Q1 относятся элементы массива данных V в соответствии с решающим правилом mq (xj): xj ЕО1,если d(xi, xj )< r, i e 11q 1, j e I \ Iq_1 (1).
Эта процедура автоматической классификации продолжается до тех пор, пока множество номеров элементов I \ Iq _ 1 ( 1 ) не будет равно нулю. Обозначим множество номеров элементов из массива данных V , отнесённых в соответствии с процедурами повторной автоматической классификации типа (1), (2), (3) к макроклассу Q 1 , через 1 1 .
Из оставшихся элементов массива V за исключением их номеров I 1 выбирается новый элемент x t , и приведённая выше процедура повторной автоматической классификации повторяется для обнаружения нового макрокласса Q 2 . В результате классы Q j , j = 1, M будут объединены в макроклассы Q j , j = 1, M , M < M .
Если значение параметра r алгоритма «Форель» близко к нулю, то M будет соизмеримо с количеством классов M . При увеличении r значения M уменьшаются и стремятся к единице. Организуем вычислительный эксперимент для определения вида зависимости M от параметра r . При этом возникают условия, когда при изменении параметра r в относительно большом интервале количество новых макроклассов M может не изменяться (рис. 1).
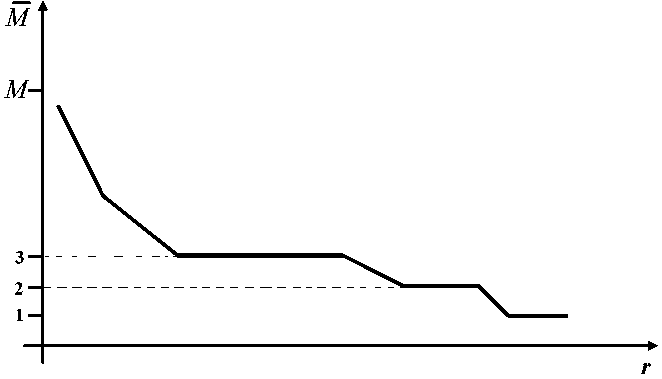
Рис. 1. Иллюстрация возможного варианта зависимости M от r
Fig. 1. Illustration of a possible variant of dependence M on r
Например, в условиях рис. 1 исходные классы могут быть объединены в две устойчивые группы при M = 3 и M = 2. Для обоснования этих групп необходимо привлекать дополнитель- ную информацию о свойствах элементов исследуемой земной поверхности, которая характеризуется исходными спектральными признаками.
Агрегирование классов на основе метода проверки гипотез об однородности законов распределения случайных величин
Пусть выборка V = ( x V , v = 1, k , i = 1, n ) многомерных спектральных признаков x = ( x v , v = 1, k ) дистанционного зондирования с использованием алгоритма автоматической классификации разбита на компактные множества наблюдений V j = ( x i , i е I j ) , j = 1, M , соответствующих M классам. Здесь Ij – множество номеров наблюдений из выборки V , принадлежащих j -му классу. Имеется дополнительная информация об объектах классификации, которая характеризует их свойства V j = ( у1 , i е I j ) , где I j с I j , j = 1, M . Например, при анализе данных дистанционного зондирования значения x = ( xv , v = 1, k ) соответствуют спектральным признакам, а y – степени повреждённости темнохвойных древостоев сибирским шелкопрядом.
Предлагаемый метод агрегирования результатов автоматической классификации основан на проверке гипотез об однородности законов распределения пар случайных величин P j ( у ) , Pt ( у ) , j , t = 1, M , j > t .
Проверка гипотезы об однородности законов распределения. Проверку гипотезы об однородности законов распределения случайной величины y [4; 6]
H0: Pj (y)E pt (y)
рассмотрим с позиций анализа результатов решения двухальтернативной задачи распознавания образов. Байесовское решающее правило, соответствующее критерию максимального правдоподобия, имеет вид mjt(y):
у eQ j ,ес ли P j ( у ) > pt ( у ) , _ у eQ t ,если Pj ( у ) < P t ( у ) .
Если области определения плотностей вероятности P j ( у ) и pt ( у ) классов Q j , Q t не пересекаются, то ошибка их распознавания р jt = 0. Максимальная ошибка распознавания классов р jt = 0,5 определяется совпадением областей определения P j ( у ) , pt ( у ) и их значений. На этой основе проверка гипотезы (4) заменяется на гипотезу о равенстве ошибки распознавания классов значению 0,5
H 0 : P jt = 0,5.
Для проверки гипотезы (6) по исходным данным Vj и Vt сформируем обучающую выборку
Vjt =(у1, ^(i) , iе Ijt), где «указания учителя»
^ ( i ) =
1, если i е I j ,
-1, если i е It , а множество Ijt = Ij J It . Обозначим через njt количество элементов множества Ijt . Тогда непараметрическую оценку уравнения разделяющей поверхности решающего правила (5) между классами Q j, Qt в пространстве признаков y = (yv, v = 1, m) дополнительной информации за- пишется в виде mi
f„ (y )=—m- X^№
nt П c..“ I" v “ 1 cv где
c( 1)=“
nj
, если n jt
n t , если njt
yi eQj, yi eQt,
n , n – количество элементов множеств I , I соответственно.
j t jt
Здесь ядерные функции Ф ( uv ) удовлетворяют условиям [19; 20]:
Ж да
Ф ( U v ) = Ф ( - U v ) , 0 <Ф ( u v ) <ж , J Ф ( U v ) dU v = 1, j u s Ф ( U v ) dU v <Ж , 0 < S <Ж .
-да -ж
Например, ступенчатая ядерная функция Ф ( Uv ) запишется в виде
Ф( U v ) =
0,5, если U v | < 1, 0, если | uv| > 1.
В этих условиях непараметрическое решающее правило (5) преобразуется как
mjt ( у ):
y e Q j , если f jt ( y ) > 0, y e Q t , если fjt ( y ) < 0.
Для упрощения оптимизации алгоритма (7) примем cv = cdv , где dv - оценка среднеквадратического отклонения случайной величины yv . Параметр c коэффициентов размытости cv , v = 1, m ядерных функций непараметрического алгоритма распознавания образов выбирается из условия минимума оценки вероятности ошибки распознавания классов
р j = ^ X 1И1), ст(М), njt 1e Ijt
где индикаторная функция
1 ( c ( X ) , a ( % ) ) =
0,если с(Х) = с(Х), 1,если o(X)^c(Z).
Здесь с ( Х ) - «решение» непараметрического алгоритма распознавания классов (7) в условиях y = у 1 и i ^ 1 при вычислении значения непараметрической оценки уравнения разделяющей поверхности f jt ( у ) между классами Q j , Q t .
Тогда гипотеза (6) подтверждается, если с заданным уровнем доверия β выполняется соотношение [6]
( 0.5 -р jt ) < D jt .
где пороговое значение
D jt = - ln
jt .
При выполнении условия (9) гипотеза (6) выполняется и риск её отвергнуть не превышает значения β.
Методика агрегирования классов:
-
1. Для каждой пары классов Q j , Q t проверить гипотезу об однородности законов распределения случайной величины P j ( y ) , p t ( у ) (4). Количество таких задач соответствует значению M ( M -1)/2.
-
2. На основании результатов решения задач первого этапа построить информационный граф G ( Q , B ) , где Q = ( Q j. , j = 1, M ) - обнаруженные классы в пространстве признаков х , а B -множество рёбер графа. В информационном графе присутствует ребро bjt е B , если законы распредления случайной величины P j ( у ) , pt ( у ) достоверно не отличаются.
-
3. Провести анализ информационного графа G ( Q , B ) и выделить полный подграф с максимальным количеством вершин. Полный подграф определяется классами, которые попарно достоверно не отличаются законами распределения случайных величин. Классы, соответствующие множеству вершин полного подграфа, образуют макрокласс с близкими свойствами законов распределения у = ( y v , v = 1, r ) .
-
4. Исключить из графа G ( Q , B ) обнаруженный полный подграф и повторить этап 3 в соответствующих ему условиях. Выполнение этого этапа позволяет определить новый макрокласс с достоверно отличающимися свойствами законов распределения у = ( y v , v = 1, r ) .
-
5. Последовательное выполнение действий этапов 3, 4 осуществляет агрегирование классов Q = ( Q j- , j = 1, M ) в макроклассы Q = ( q j , j = 1, M ) , где M < M .
Полученные результаты являются основой синтеза непараметрических алгоритмов распознавания образов для оценивания макроклассов Q = ( q j , j = 1, M ) в пространстве исходного набора спектральных признаков x v , v = 1, k .
Заключение
Агрегирование результатов автоматической классификации является одним из этапов системного анализа данных дистанционного зондирования с целью оценивания состояний природных объектов. Если под классом понимается область значений спектральных признаков, соответствующая одномодальному фрагменту их плотности вероятности, то для агрегирования классов обосновано использовать модификацию алгоритма «Форель». Его применение осуществляет повторную классификацию в пространстве средних значений спектральных признаков в классах. В более общих условиях распределение случайных величин в классах целесообразно использовать метод агрегирования, основанный на проверке гипотез об однородности законов распределения спектральных признаков, определяющих дополнительную информацию. Для реализации этого метода используется непараметрический алгоритм распознавания образов, соответствующий критерию максимального правдоподобия, и аппарат теории графов. В макроклассы объединяются классы, которые достоверно не отличаются характеризующих их законами распределения спектральных признаков.
Предложенные методы являются актуальными при системном анализе данных дистанционного зондирования природных объектов. В этих условиях классы соответствуют компактным множествам наблюдений спектральных признаков элементов земной поверхности, а дополнительная информация – частичные сведения об их свойствах.
