
Алгоритм определения численных индикаторов аномалий трафика на основе модели случайного леса
Журнал: Инфокоммуникационные технологии @ikt-psuti
Рубрика: Сети связи и мультисервисные услуги
Статья в выпуске: 1 (93) т.24, 2026 года.
Бесплатный доступ
В работе представлен алгоритм, позволяющий извлекать из модели случайного леса числовые пороговые значения для обнаружения аномалий, обусловленных различными видами сетевых атак. Он позволяет выделить как отдельные пороговые значения, так и диапазоны нормальных или аномальных значений, а также оценить их статистическую значимость. Представленный алгоритм был протестирован на наборе данных CIC-IDS2017 для выявления специфичных изменений статистических характеристик при определенных типах атак. Трафик рассматривается в виде последовательности интервалов между поступлениями пакетов, последовательности размеров пакетов, а также временных рядов, представляющих количество пакетов или суммарный объем байт в единицу времени. Трафик разбивается на неперекрывающиеся минутные интервалы, производится оценка коррелированности признаков, и для каждой категории атак обучаются отдельные модели классификации. Для моделей с наибольшим значением F1-меры разработанный алгоритм применяется для выявления наиболее значимых признаков атак, связанных с изменениями статистических характеристик. Результаты показывают, что для различных типов атак значимые пороговые значения определяются для признаков, соответствующих значениям автокорреляционной функции на разных лагах, что указывает на возможность использования изменения корреляции для обнаружения этих атак.
Короткий адрес: https://sciup.org/140316412
IDS: 140316412 | УДК: 004.85:004.75 | DOI: 10.18469/ikt.2026.24.1.03
Algorithm for identifying numerical indicators of network traffic anomalies based on a random forest model
This paper presents an algorithm that extracts numerical threshold values from a random forest model for detecting anomalies caused by various types of network attacks. It allows an identification of both individual threshold values and ranges of normal or anomalous values, as well as the assessment of their statistical significance. The proposed algorithm is evaluated using the CIC-IDS2017 dataset to identify specific changes in statistical characteristics during particular types of attacks. Traffic is analyzed as a sequence of packet inter-arrival times, a sequence of packet sizes, and time series representing packet counts or total byte volumes per unit of time. The traffic is split into nonoverlapping one-minute intervals, feature correlations are assessed, and separate classification models are trained for each attack category. For models with the highest F1-score, the proposed algorithm is applied to identify the most significant attack features related to changes in statistical characteristics. Results indicate that, across multiple attack groups, significant thresholds are identified for features corresponding to the autocorrelation function values at different lags, suggesting that changes in correlation can be used to detect these attacks.
Текст научной статьи Алгоритм определения численных индикаторов аномалий трафика на основе модели случайного леса
Распространение облачных сервисов, IoT-устройств и мобильных сетей приводит к значительному росту объемов трафика, что требует применения автоматизированных и масштабируемых методов анализа для обнаружения ранее неизвестных угроз. Алгоритмы машинного обучения, такие как Random Forest («случайный лес»), обеспечивают высокую точность классификации, устойчивость к шуму и выбросам, однако интерпретируемость их результатов может быть затруднена [1]. В данной работе представлен алгоритм, позволяющий извлекать из обученной модели «случайного леса» числовые пороговые значения для аномалий различных типов.
Для выделения характерных признаков различных видов сетевых атак необходимо использовать размеченные наборы данных, содержащие трафик обычной пользовательской активности и трафик атаки. В большинстве исследовательских работ используются разные трассы, полученные в разных точках разных сетей, на разных сценариях, в разные по длительности промежутки времени [2]. Для демонстрации алгоритма был выбран набор данных CICIDS2017 [3], он включает в себя как легитимный трафик HTTP, HTTPS, FTP, SSH и электронной почты, так и трафик различных видов атак: Bruteforce, DDoS, эксплуатация уязвимости Hearbleed, XSS, SQL инъекции, ботнет и сканирование портов.
Анализ трафика
Из «сырых» записей трафика можно выделить различные последовательности: интервалы времени между поступлениями пакетов, размеры пакетов, количество или суммарный объем трафика в единицу времени (временной ряд). На рисунке 1 представлен такой временной ряд, полученный агрегацией по интервалам в 1 мс.
BY
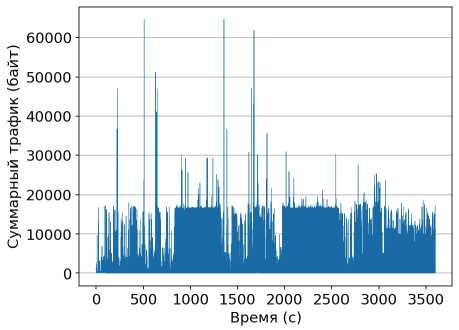
Рисунок 1. Случайный временной ряд
Визуальный анализ графиков позволяет выделить наиболее выраженные признаки атак. Для ряда атак известны признаки, основанные на изменении статистических характеристик трафика [4, 5]. Для более точного выделения признаков и установления пороговых значений перспективным подходом является применение методов машинного обучения. Для их применения из трафика необходимо извлечь набор признаков, соответствующих каждому классифицируемому объекту: потоку или временному окну.
Для извлечения признаков CIC-IDS2017 записи трафика были разделены на минутные интервалы (длительность самой короткой атаки в датасете равна 2 мин), первый и последний интервал отбрасываются, вычисляются их статистические характеристики: выборочное среднее и СКО, медиана, сумма, коэффициенты асимметрии и эксцесса, оценка показателя Хёрста, а также разница между значением характеристики с предыдущим интервалом и коэффициенты корреляции последовательности для первых 10 лагов. Поскольку коррелированные признаки создают избыточность и снижают точность моделей [6], для полученного набора данных была выполнена оценка их взаимной корреляции. На рисунке 2 представлена соответствующая матрица корреляции признаков для образцов трафика, представленного в виде межпакетных интервалов времени.
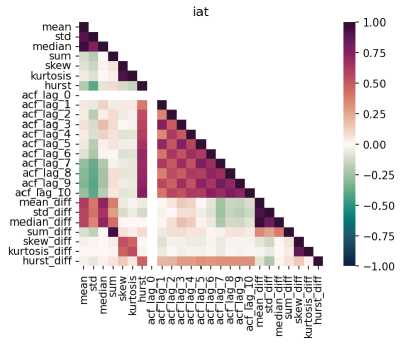
Рисунок 2. Матрица корреляции между признаками
Наиболее сильная корреляция присутствует между средним и СКО последовательности и их разницей с предыдущим интервалом, а также между признаками, соответствующими коэффициентам корреляции. Эти закономерности сохраняются и для других представлений трафика.
Описание алгоритма
Одним из наиболее популярных методов, применяемых в машинном обучении, является алго- ритм случайного леса [7]. Это ансамблевый метод, при котором множество решающих деревьев независимо друг от друга обучаются на случайных подвыборках обучающей выборки. Для получения итоговой оценки результаты классификации отдельных деревьев усредняются. Метод случайного леса позволяет работать с несбалансированными наборами данных, назначая «вес» каждому объекту пропорционально доле объектов данного класса в общей выборке. Данный метод позволяет достигать высоких показателей точности при классификации сетевого трафика [8, 9].
Для выявления наиболее характерных признаков атак целесообразно рассматривать каждую группу атак отдельно по сравнению с легитимным трафиком. В этом случае наибольший вес должны иметь признаки, отличающие не атаки разных видов друг от друга, а атаки конкретного вида от нормального трафика. Иными словами, задача распадается на n задач бинарной классификации, где n – число групп, для каждой группы обучается своя модель.
В узлах каждого дерева данные разбиваются на две части: левая ветка и правая. Разбиение происходит путем сравнения значения признака F v , который проверяется данным узлом, с пороговым значением 0 v . Для каждого узла можно определить, в какую из двух веток модель чаще направляет аномальные объекты. Пусть S i , j – множество объектов, попавших в узел j дерева i , тогда доля аномальных объектов:
pi , j
ai , j
,
ni , j
где n i , j – общее число объектов в S i , j ;
a i , j – число объектов, принадлежащих к аномальному классу.
Для каждого узла определяется соответствующий прирост доли аномальных объектов:
Д p , j = max ( p Lj , p^ .) - ph J , (2)
где piL, j – доля аномалий в левом дочернем узле; piR, j – доля аномалий в правом дочернем узле. Если Дp, j > 0 , то определяется условие, соответствующее дочернему узлу с большей долей аномалий. Если pLj > pRj, то значимым считается условие C,j : F,j < 0,,j, иначе C,,j : F,j > 0,,j. Для каждого такого условия сохраняется кортеж параметров (F,,j, 0,j, Дp,,j, C,,j). Чтобы минимизировать влияние шумовых разбиений, условия группируются по признаку F и типу условия C, и ранжируются по суммарному приросту доли аномальных объектов ∆pi,j. Полученный в результате набор пар (θi,j, ∆pi,j) можно рассматривать как выборку случайной величины θ с соответствующими весами ∆p , поскольку вклад каждого порога отличается. Для оценки плотности распределения этой случайной величины можно применить метод взвешенных гистограмм [10] или ядерной оценки плотности. Затем определяется наиболее вероятное значение (мода) случайной величины, в данном случае ее использование предпочтительнее математического ожидания или среднего, поскольку она не подвержена влиянию выбросов.
Таким образом, для каждого признака может быть получено от 0 до 2 наиболее часто используемых порогов разбиения. Для проверки статистической значимости выявленных порогов применяется критерий согласия Колмогорова-Смирнова. Порог считается значимым, если максимум статистики критерия находится в достаточной близости от данного порогового значения.
Данный алгоритм позволяет выделить численные индикаторы, наиболее информативные с точки зрения роста вероятности аномального поведения в анализируемых данных. Его схема представлена на рисунке 3.
Результаты
Для каждого представления трафика и группы атак была обучена своя модель, качество которой оценивалось по значению F1-меры для тренировочной и тестовой (OOB) выборок. На тренировочной выборке для большинства атак полученное значение F1-меры составляет 0,95–1,0. На тестовой выборке для DoS-атак Hulk и LOIT значение F1-меры составляет от 0,94 до 0,97. Достаточно высокие значения также получены для атак внедрения, эксплойтов, брутфорс-атак и DoS атаки GoldenEye. Атаки slowloris и Slowhttptest распознать с помощью статистических признаков удается плохо, как и атаку с SQL-инъекцией. Неожиданно высокий результат получен для модели, обученной распознавать XSS-атаки на основе статистических характеристик последовательности межпакетных интервалов, что может быть связано с особенностями реализации конкретной атаки. Для перечисленных видов атак возможно определение пороговых значений, обладающих наибольшей практической значимостью. Все значения F1-меры, полученные на тестовой выборке, представлены в таблице 1.
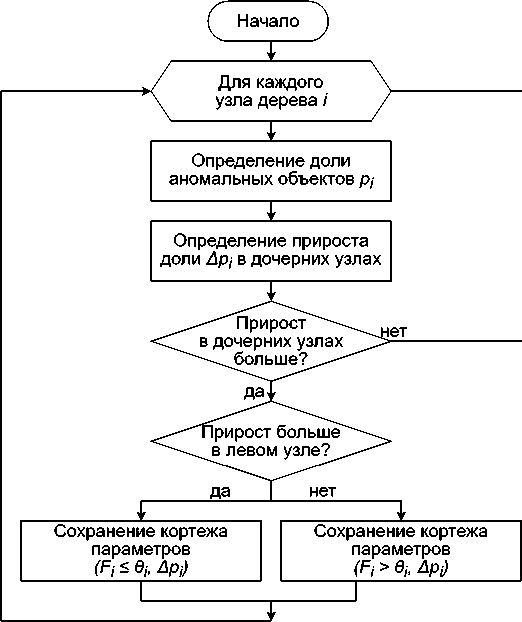
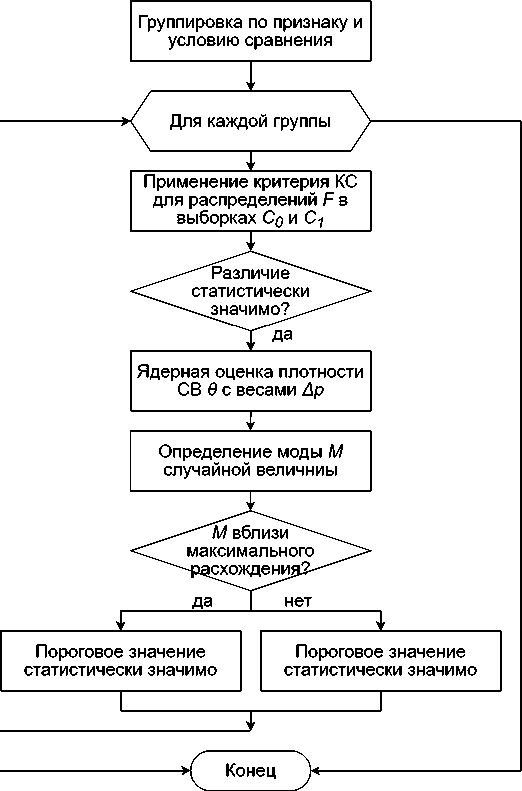
Рисунок 3. Алгоритм выделения пороговых значений
Таблица 1. Значения F1-меры для всех атак
|
Тип атаки |
F1 iat |
F1 buf |
F1 bytes |
F1 packets |
|
Botnet/ARES |
0,16 |
0,33 |
0,22 |
0,24 |
|
Bruteforce/FTP-Patator |
0,30 |
0,34 |
0,39 |
0,35 |
|
Bruteforce/SSH-Patator |
0,49 |
0,24 |
0,35 |
0,49 |
|
DoS/GoldenEye |
0,25 |
0,67 |
0,48 |
0,12 |
|
DoS/Hulk |
0,97 |
1,00 |
0,97 |
0,94 |
|
DoS/LOIT |
0,95 |
0,97 |
0,95 |
0,97 |
|
DoS/Slowhttptest |
0,09 |
0,21 |
0,03 |
0,21 |
|
DoS/slowloris |
0,34 |
0,08 |
0,08 |
0,37 |
|
Exploit/Heartbleed |
0,40 |
0,89 |
0,83 |
0,36 |
|
Infiltration/Dropbox download |
0,72 |
0,61 |
0,16 |
0,76 |
|
Port Scan/Firewall off |
0,14 |
0,17 |
0,10 |
0,38 |
|
Port Scan/Firewall on |
0,05 |
0,07 |
0,05 |
0,04 |
|
Web/Bruteforce |
0,31 |
0,05 |
0,07 |
0,07 |
|
Web/Sql injection |
0,00 |
0,00 |
0,00 |
0,00 |
|
Web/XSS |
0,60 |
0,06 |
0,02 |
0,04 |
Далее к полученным моделям был применен описанный ранее алгоритм. На рисунке 4 представлены оценки плотности распределения для признака коэффициента корреляции между соседними межпакетными интервалами, полученными из модели, обученной на трафике ботнет-атаки. Вертикальной линией отмечена оценка моды распределения.
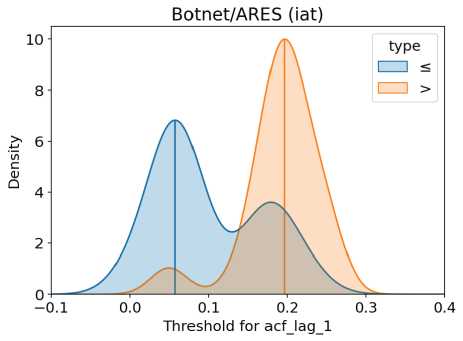
Рисунок 4. Ядерная оценка плотности
На рисунке 5 представлены эмпирические функции вероятности и значение статистики критерия согласия Колмогорова-Смирнова.
Наибольшее расхождение между двумя распределениями находится в точке, приблизительно соответствующей значению 0,2. Пороговое значение, выделенное моделью случайного леса, также находится в этой точке, отсюда можно сделать вывод, что данный порог является статистически значимым. Второе пороговое значение, для условия другого типа, находится в точке 0,05, где распределения также отличаются, но гораздо слабее.
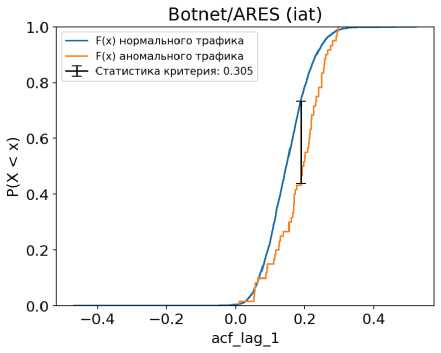
Рисунок 5. Статистика критерия согласия Колмогорова-Смирнова
Для трафика из набора данных CIC-IDS2017 алгоритм позволяет выделить следующие признаки атак:
– для атаки Bruteforce/FTP-Patator: снижение коэффициентов корреляции ниже 0,2‒0,3 для последовательности размеров пакетов и ниже 0,1 для последовательности интервалов между пакетами, а также «утяжеление» правого хвоста распределения.
– для атаки Bruteforce/SSH-Patator: снижение коэффициентов корреляции ниже 0,2 для последовательности размеров пакетов; увеличение коэффициентов корреляции выше 0,2 на 5 и последующих лагах, сдвиг влево пика распределения значений временного ряда, представляющего количество пакетов в единицу времени.
– для атаки DoS/Hulk: снижение среднего интервала между пакетами до значений менее 0,5 мс и снижение тяжести хвостов распределения этой последовательности по сравнению с предыдущим интервалом; превышение среднего размера пакетов значения 8048 байт; увеличение коррелиро-ванности значений временного ряда количества пакетов, и снижение коррелированности для временного ряда суммарного размера пакетов.
– для атаки Infiltration/Dropbox download: увеличение АКФ значений временных рядов и снижение коррелированности интервалов времени между пакетами; превышение показателем Херста значения 0,87 для временного ряда суммарного размера пакетов, 0,9 для последовательности размеров пакетов и 0,8 для интервалов между пакетами.
– для атаки Web/XSS: снижение коэффициента асимметрии до 6 и увеличение коррелирован-ности для последовательности интервалов между пакетами; увеличение дисперсии размеров пакетов более 881,1.
Выводы
В данной работе представлен алгоритм определения численных индикаторов аномалий для различных статистических характеристик трафика, основанный на методе «случайного леса», и отличающийся тем, что позволяет выделить как отдельные пороговые значения, так и диапазоны нормальных или аномальных значений и установить их статистическую значимость. Выделенные для трафика CIC-IDS2017 закономерности совпадают с интуитивным пониманием особенностей атак, а разработанный подход может применяться для трафика других сетей. У различных видов атак значимые пороги были выделены для признаков, соответствующих значениям АКФ на разных лагах, что говорит о том, что изменение коррелированности может быть использовано для их обнаружения.
Ограничениями данного алгоритма является то, что признаки рассматриваются отдельно и сравниваются только одномерные распределения. Если аномалия проявляется в совместном изменении значений нескольких признаков, использования в качестве признака превышения одного из порогов недостаточно. Перспективным может быть использование пар или троек порогов, выделенных в том же порядке, в котором они встречаются в решающих деревьях. Также здесь учитывается только один наиболее значимый порог, но, если для признака были выделены два порога 0 1 и 0 2 причем 0 1 < 0 2 , то может быть определен интервал аномальных значений, если же 0 1 > 0 2 , то интервал нормальных значений. Указанные ограничения могут стать предметом дальнейших исследований.
