
Автоматизированное управление бизнес-требованиями в экосистемах управления проектами на основе больших языковых моделей
Журнал: Петербургский экономический журнал @gukit-journal
Рубрика: Теория и практика управления организационно-экономическими системами
Статья в выпуске: 3 (53), 2026 года.
Бесплатный доступ
В статье рассмотрен подход к проектированию интеллектуальной надстройки над экосистемой Jira и Confluence, интегрирующей возможности больших языковых моделей (LLM) в контур управления требованиями программных проектов. Проведен критический анализ функциональных ограничений популярных платформ управления проектами – Jira и Confluence, а также выполнена сравнительная оценка специализированных Enterprise-решений (IBM Engineering Requirements Management, Polarion). Показано, что существующие инструменты обладают реактивным характером: они эффективно фиксируют и хранят данные, однако лишены механизмов глубокого семантического анализа текстов требований. На основе выявленных ограничений сформирована концепция гибридной интеллектуальной среды, реализующей принципы улучшенной V-модели и методологии Kanban с автоматизированным контуром верификации на базе LLM. Предложен алгоритм автоматизированной проверки качества требований по критериям SMART, переводящий субъективную оценку документации в объективные метрические показатели. Для описания проектируемой системы задействованы диаграммы компонентов и потоков данных, отражающие ключевые архитектурные блоки плагина: модуль сбора неструктурированных требований, семантический верификатор, генератор документации и интерфейс поддержки принятия решений. Практическая значимость работы заключается в сокращении трудозатрат системного аналитика на рутинные операции верификации и в повышении консистентности проектной документации на ранних стадиях жизненного цикла разработки.
Короткий адрес: https://sciup.org/140316645
IDS: 140316645 | УДК: 004.9:681.3.06 | DOI: 10.32603/2307-5368-2026-3-55-65
Automatized project management ecosystem for automated requirements management using language models
The article considers an approach to designing an intelligent add-on over the Jira and Confluence ecosystem, integrating the capabilities of large language models (LLM) into the requirements management contour of software projects. A critical analysis of the functional limitations of popular project management platforms – Jira and Confluence – was carried out, as well as a comparative assessment of specialized Enterprise solutions (IBM Engineering Requirements Management, Polarion). It is shown that the existing tools are reactive in nature: they effectively capture and store data, but lack mechanisms for deep semantic analysis of requirement texts. Based on the identified limitations, the concept of a hybrid intelligent environment has been formed that implements the principles of the improved V-model and Kanban methodology with an automated LLM-based verification loop. An algorithm for automated quality control of requirements according to SMART criteria is proposed, which translates the subjective assessment of documentation into objective metric indicators. To describe the designed system, diagrams of components and data flows are used, reflecting the key architectural blocks of the plugin: a module for collecting unstructured requirements, a semantic verifier, a documentation generator, and a decision support interface. The practical significance of the work lies in reducing the labor costs of a system analyst for routine verification operations and in improving the consistency of project documentation at the early stages of the development lifecycle.
Текст научной статьи Автоматизированное управление бизнес-требованиями в экосистемах управления проектами на основе больших языковых моделей
Введение, цель
Современная индустрия разработки программного обеспечения отличается постоянным ростом сложности информационных систем и динамичностью изменения биз-нес-требований. В условиях цифровизации классические методы управления проектной документацией сталкиваются с проблемой информационного перенасыщения: объем поступающих данных и скорость их модификации превышают человеческие возможности системного аналитика [1]. Это неизбежно ведет к возникновению логических противоречий в спецификациях и потере консистентности требований, что в конечном счете кратно увеличивает стоимость исправления архитектурных ошибок на поздних этапах жизненного цикла.
Одним из наиболее перспективных направлений преодоления указанных барьеров является внедрение технологий искусственного интеллекта и больших языковых моделей (LLM) в контур управления проектами. Интеграция таких инструментов в процессы системного анализа позволяет автоматизировать рутинные операции по структурированию, классификации и первичной верификации требований, трансформируя традиционные статические базы знаний в динамические интеллектуальные среды поддержки принятия решений [2; 3].
Цель настоящего исследования – разработка концепции и архитектуры интеллектуальной надстройки над экосистемой Atlassian (Jira и Confluence), интегрирующей возможности больших языковых моделей в контур управления требованиями программных проектов для автоматизации их верификации и генерации проектной документации.
В статье анализируются предметная область управления требованиями, актуальные проблемы существующих инструментов, концепция и архитектура проектируемого плагина, а также алгоритмы автоматизированной проверки качества требований. Перспективой дальнейших исследований является реализация прототипа и его экспериментальная проверка в реальных проектных условиях.
Жизненный цикл разработки программного обеспечения (SDLC) представляет собой процесс, в котором этап анализа требований играет связующую роль между потребностями бизнеса и технической реализацией. Как показано в исследованиях, ошибки, допущенные на этапе формирования требований, имеют тенденцию к лавинообразному росту стоимости их исправления на более поздних стадиях [4]: по различным оценкам, дефект, выявленный в фазе тестирования, обходится в 10–100 раз дороже, чем выявленный на этапе проектирования.
В рамках предлагаемого подхода анализ требований рассматривается не как изолированная фаза, а как непрерывный процесс, интегрированный во все стадии жизненного цикла – от предпроектного обследования до сопровождения. Методологической базой служит гибридный подход, сочетающий структурную надежность V-модели, итеративность фреймворка Scrum и визуальный контроль потока задач по методологии Kanban [5].
Традиционный каскадный подход (Waterfall) демонстрирует максимальную эффективность в проектах с расплывчатыми границами, где требования могут быть зафиксированы в виде иерархических спецификаций до начала активной фазы разработки. В такой модели управление изменениями является формализованным процессом, что минимизирует риски «расползания» функционала, однако создает значительные задержки при необходимости адаптации к меняющимся рыночным условиям [6].
В современных мобильных и высоконагру-женных проектах Agile-методологии, в частности фреймворк Scrum, обеспечивают более высокую скорость поставки продукта (Time-to-Market) за счет итеративного уточнения бэклога. Scrum предполагает непрерывную актуализацию требований в рамках каждого спринта, что позволяет команде оперативно реагировать на изменения [7]. Использование карт пользовательских историй (User Story Mapping) дополнительно обеспечивает прозрачную связь между высокоуровневыми бизнес-процессами и конкретными функциональными требованиями [8].
На сегодняшний день стандартом организации совместной работы и ведения проектной документации являются программные продукты компании Atlassian. Система Jira [9] широко применяется для управления задачами и отслеживания прогресса разработки, предо- ставляя гибкие возможности для настройки рабочих процессов.
Отличительной чертой Jira с точки зрения автоматизации является встроенный движок Jira Automation: он берет на себя создание подзадач при переводе истории в статус «In Progress», рассылку уведомлений при изменениях состава спринта и прочие операции, не требующие участия человека. Confluence [10] в этой связке выполняет роль корпоративной базы знаний – спецификации хранятся в формате Wiki-страниц с поддержкой версионности и одновременного редактирования несколькими участниками.
Однако при объединении этих инструментов в единую экосистему возникает принципиальное ограничение. Они хорошо справляются с фиксацией и хранением данных, но не способны интерпретировать смысл зафиксированных требований. Автоматизация здесь построена на жестких триггерах и заранее прописанных правилах, оценки полноты спецификации или анализа последствий изменений в инструментах попросту нет.
Чтобы картина была полной, стоит обратиться к тяжелым Enterprise-платформам, созданным именно для строгой верификации в крупных инженерных проектах. IBM Engineering Requirements Management DOORS Next [11] решает задачу управления масштабными спецификациями: каждое требование существует как самостоятельный объект с собственным набором атрибутов, историей изменений и механизмом сквозной прослеживаемости.
Polarion [12] придерживается иной концепции – спецификация воспринимается как обычный текстовый документ, но каждое предложение в нем получает статус полноценного системного объекта со своим жизненным циклом. Тем не менее, несмотря на развитые механизмы структурирования, обе платформы остаются инструментами пассивного контроля – смысловую проверку и оценку качества текстов аналитики по-прежнему выполняют вручную. Сравнение рассмотренных решений с проектируемым подходом представлено в табл. 1.
Табл. 1. Сравнительный анализ систем управления требованиями Tab. 1. Comparative analysis of requirements management systems
|
Критерий / Criterion |
Jira / Confluence |
IBM DOORS / Polarion |
Проектируемое решение (Jira + LLM) / Proposed Solution (Jira + LLM) |
|
Гибкость внедрения / Deployment flexibility |
Высокая / High |
Низкая / Low |
Высокая / High |
|
Стоимость / Cost |
Средняя / Medium |
Высокая / High |
Средняя / Medium |
|
Трассировка требований / Requirements traceability |
Базовая / Basic |
Полная / Full |
Полная / Full |
|
Семантический анализ текста / Semantic text analysis |
Нет / No |
Нет / No |
Да (LLM) / Yes (LLM) |
|
Автопроверка по SMART / SMART auto-check |
Нет / No |
Нет / No |
Да / Yes |
|
Генерация обратной связи / Feedback generation |
Нет / No |
Нет / No |
Да / Yes |
Источник: составлено авторами.
Source: compiled by the authors.
Ни один из рассмотренных инструментов не умеет читать требования – он умеет лишь их хранить. Jira с Confluence дают гибкость и скорость, Enterprise-платформы – строгий контроль структуры, но и те, и другие останавливаются там, где начинается смысловой анализ текста. Именно на этом уровне аналитик тратит большую часть времени: ищет противоречия, проверяет полноту формулировок, классифицирует требования по типам. Закрыть этот пробел могла бы надстройка, работающая как полноценный ассистент – не просто фиксирующая проблему, а предлагающая конкретные правки [3].
Острее всего эта особенность проявляется в мобильных и облачных проектах: там пользовательские истории обновляются постоянно, и с каждой итерацией растет риск того, что новые требования вступят в противоречие с уже реализованной логикой. Ручной контроль в таком темпе перестает справляться – на этом этапе интеграция языковых моделей в рабочий инструментальный стек необходима.
Методы исследования
Архитектура проектируемой системы строится на модульном принципе, что гарантирует ее масштабируемость и интеграцию в облачные инфраструктуры. В основу концепции заложено использование языковых моделей как интеллектуального ядра для обработки информации в реальном времени. Принципиальное отличие проектируемой среды заключается в переходе от пассивного хранения текста к активному управлению смыслами: LLM выступает не вспомогательным инструментом, а интегрированным звеном, обеспечивающим автоматическую верификацию и генерацию проектных артефактов.
Архитектура плагина включает четыре функциональных блока. Модуль интеллектуального сбора интерпретирует неструктурированные входящие данные от стейкхолдеров, преобразуя их в четкие требования с помощью LLM. Семантический верификатор сопоставляет новые данные с существующей базой знаний для автоматического выявления логических противоречий и дубликатов. Блок генерации документации транслирует бизнес-цели в технические спецификации и критерии приемки. Интерфейс поддержки принятия решений предоставляет аналитикам экспертные рекомендации по приоритизации задач и оценке влияния изменений на всю систему.
Для обеспечения качества разрабатываемых программных систем в рамках предлагаемого подхода формируется контур верификации, объединяющий классические методы контроля и гибкие инструменты визуализации потока работ. Основой контура верификации служит усовершенствованная V-модель [13]. Каждому этапу формирования требований соответствует своя стадия тестирования. Подключение LLM дает возможность частично автоматизировать левую ветвь: модель сопоставляет бизнес-требования с техническими заданиями и на выходе формирует материал,
пригодный для последующей генерации тестовых сценариев.
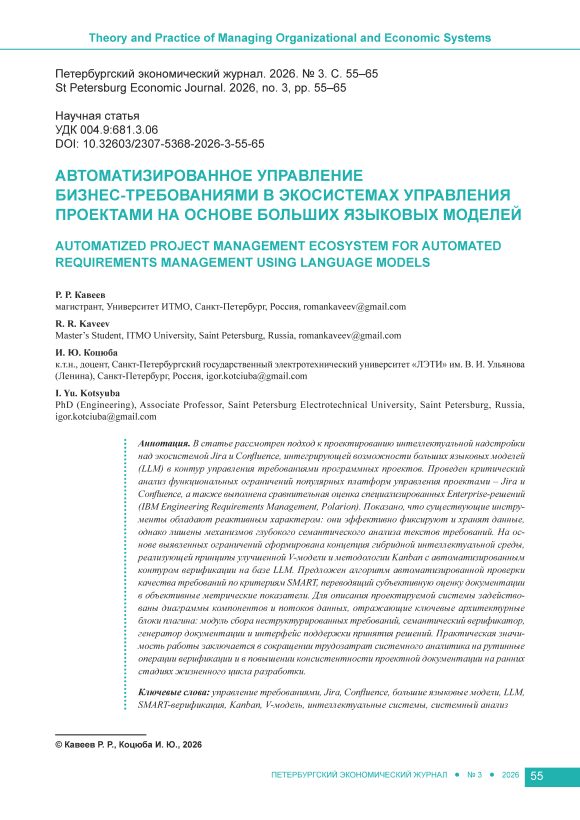
Параллельно в контур закладываются принципы Kanban [14]. Визуализация потока требований через интеллектуальные фильтры позволяет в любой момент видеть, на каком этапе скапливается незавершенная работа и на каком шаге аналитический цикл начинает «проседать». Порядок взаимодействия компонентов при верификации требований представлен на рис. 1.
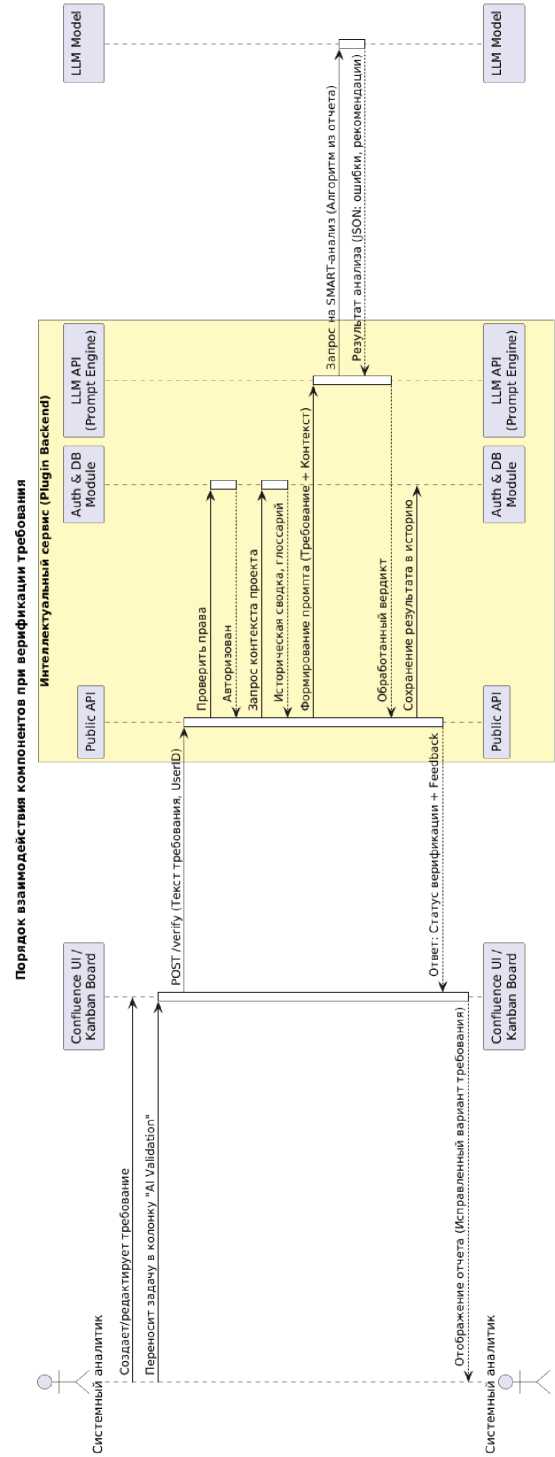
Проектирование архитектуры плагина включает разработку диаграмм компонентов и развертывания (рис. 2). Диаграмма компо-
Рис. 2. Диаграмма компонентов интеллектуальной системы управления требованиями Fig. 2. Component diagram of the intelligent requirements management system
Источник: составлено авторами.
Source: compiled by the authors.
нентов отражает взаимодействие ключевых модулей: клиентского расширения Jira (Среда Confluence / Jira), API-шлюза для взаимодействия с LLM, модуля семантического анализа, базы данных на основе векторного хранилища, а также интеграционных коннекторов к Confluence API. Архитектура предполагает развертывание в облачной инфраструктуре с горизонтальным масштабированием LLM-сервиса при пиковых нагрузках.
Завершающим этапом проектирования интеллектуальной среды является формализация алгоритма, переводящего качественные характеристики требований в количественные метрики. Предлагаемый алгоритм базируется на классической методологии SMART [15], адаптированной для автоматизированного анализа с помощью языковых моделей: требование оценивается по пяти критериям – конкретность (Specific), измеримость (Measurable), достижимость (Achievable), актуальность (Relevant) и ограниченность во времени (Time-bound).
По своей логике алгоритм представляет собой последовательный конвейер проверок, встроенный в Kanban-систему, задача проходит через него поэтапно, не продвигаясь дальше до прохождения текущего шага.
Шаг 1: инициализация. Перевод задачи в статус «AI Validation» служит триггером. В этот момент система забирает из Jira содержимое двух полей – «Описание» и «Критерии приемки» и отправляет их в LLM-модуль вместе с системным промптом, в котором заранее закреплены правила SMART-валидации.
Шаг 2: конкретность (Specific). Модель проверяет, можно ли из формулировки однозначно установить: кто является субъектом, что выступает объектом и какое именно действие должно быть выполнено. Размытые конструкции вроде «система должна работать лучше» на этом шаге не проходят.
Шаг 3: измеримость (Measurable). Алгоритм ищет в тексте числовые параметры либо явно сформулированные условия успеха – «время отклика не превышает 200 мс». Требование без измеримого критерия считается неполным.
Шаг 4: достижимость и релевантность (Achievable / Relevant). Наиболее контек- стно-зависимый шаг: модель обращается к накопленной базе знаний в Confluence и сопоставляет новое требование с текущей архитектурой системы и задекларированными биз-нес-целями релиза. На этом шаге выявляются технически нереализуемые формулировки и требования, выходящие за рамки итерации.
Шаг 5: временные рамки (Time-bound). Финальная проверка: требование должно быть либо привязано к конкретному спринту, либо содержать явный срок реализации. Отсутствие временного ориентира фиксируется как замечание.
Результатом работы алгоритма является аналитический отчет, в котором каждому требованию присваивается один из трех статусов: Passed (зеленый флаг) – требование полностью соответствует критериям SMART; Warning (желтый флаг) – требование допустимо, но нуждается в уточнении деталей; Failed (красный флаг) – требование отклоняется. При статусе «Failed» задача автоматически возвращается аналитику с детализированным отчетом об ошибках, блокируя возможность ее передачи разработчикам.
Результаты, дискуссия
В табл. 2 приведены примеры верификации требований по критериям SMART, демонстрирующие разницу между некачественными формулировками и исправленными версиями.
Практическая значимость внедрения автоматизированной SMART-верификации заключается в сокращении циклов согласования между аналитиками и разработчиками: в производство попадают только требования, лишенные двусмысленности и технически верифицированные. Автоматизация позволяет аналитику переключиться с рутинной проверки документации на оценку полноты и логической связности предложенной структуры.
В ходе исследования была реализована серия глубинных интервью с экспертами ИТ-отрасли – системными аналитиками и архитекторами программных систем – с целью выявления реальных сценариев использования и барьеров внедрения LLM в работу с требованиями. Систематизация практических данных показала, что успех внедрения интеллектуальных помощников напрямую зависит
Табл. 2. Примеры применения SMART-алгоритма верификации требований
Tab. 2. Examples of SMART requirements verification algorithm application
|
Критерий / Criterion |
Не подходит / Not acceptable |
Проблема / Problem |
Подходит / Acceptable |
|
S (Specific) |
«Интерфейс должен быть удобным» / «The interface should be user-friendly» |
Отсутствует конкретный объект и действие / No specific object and action |
«Время перехода между экранами ≤ 200 мс» / «Screen transition time ≤ 200 ms» |
|
M (Measurable) |
«Система должна загружать данные быстро» / «The system should load data quickly» |
Нет метрики / No metric |
«Формирование PDF ≤ 5 с при объеме данных до 100 МБ» / «PDF generation ≤ 5 s for data up to 100 MB» |
|
A/R (Achievable/ Relevant) |
«Мгновенная синхронизация без Интернета» / «Instant sync without internet» |
Физически невозможно / Physically impossible |
«Локальное сохранение + отправка при Ping < 100 мс» / «Local save + send when Ping < 100 ms» |
|
T (Timebound) |
«Реализовать когда-нибудь» / «Implement someday» |
Нет условий триггера / No trigger conditions |
«Доступно в версии 2.0, спринт 8» / «Available in version 2.0, sprint 8» |
Источник: составлено авторами.
Source: compiled by the authors.
от зрелости текущих процессов управления требованиями в организации.
Однако интервью выявили две проблемы, которые нельзя игнорировать: первая – корпоративные данные нельзя просто так отправлять во внешние сервисы, особенно в крупных компаниях с жесткими требованиями к безопасности; вторая – языковые модели иногда «галлюцинируют»: уверенно выдают неверный результат, что при работе с техническими параметрами недопустимо.
Оба ограничения напрямую повлияли на требования к проектируемой системе. Во-первых, она должна поддерживать развертывание на собственной инфраструктуре заказчика, без передачи данных наружу. Во-вторых, нужны механизмы, которые не дают модели выходить за пределы заданного контекста и проверяют корректность ее ответов перед тем, как они попадут к аналитику.
Заключение
В ходе исследования был спроектирован подход к созданию плагина, который встраивает языковые модели в привычный рабочий процесс управления требованиями над Jira и Confluence. Анализ существующих инструментов показал, что проблема у всех одна, независимо от масштаба: ни Atlassian-платформы, ни тяжелые Enterprise-системы не умеют работать со смыслом текста – только с его структурой.
В рамках исследования описана модульная архитектура системы и разработан алгоритм SMART-верификации, который переводит размытые формулировки в конкретные метрики качества. Kanban-поток с LLM-контуром обратной связи позволяет отлавливать противоречия в спецификациях на ранних стадиях, до того как они дойдут до разработчиков и превратятся в дорогостоящие ошибки.
К числу нерешенных задач относятся программная реализация прототипа плагина, сравнительная оценка точности языковых моделей на выборке реальной проектной документации и выработка подхода к формированию экспертных промптов и контролю качества генерируемых артефактов. Отдельного рассмотрения требует проблематика эргономики и когнитивной нагрузки аналитика при работе с интеллектуальной средой, поскольку именно эти факторы обусловливают реальную востребованность системы. В этом контексте перспективным направлением является оценка квалификационного потенциала специалистов, вовлеченных в процессы управления требованиями: применение комплексных метрик на основе принципов квалиметрии [16], что позволит формализовать требования к компетенциям аналитиков и обосновать готовность команды к переходу на интеллектуализирован-ный контур верификации.
