
Балансировка сетевого трафика многомашинных вычислительных систем с учетом его прогноза вейвлет-регрессионным методом
Рубрика: Информатика и вычислительная техника
Статья в выпуске: 3, 2026 года.
Бесплатный доступ
Актуальность исследования обусловлена необходимостью повышения устойчивости распределения сетевой нагрузки в многомашинных вычислительных системах при нестационарном и пульсирующем характере входящего потока запросов. Цель исследования заключается в разработке и экспериментальной проверке модифицированного вейвлет-регрессионного метода, обеспечивающего учет прогнозируемого состояния вычислительных узлов при распределении нагрузки и управлении вычислительным резервом. Предложенный метод предусматривает выделение регулярной составляющей сетевого трафика, оценку отклонения текущего состояния узла от его характерного режима, вероятностное оценивание перегрузочного состояния, формирование интегрального показателя риска и его использование при выборе вычислительного узла. Экспериментальное исследование выполнено в имитационной среде для девяти сценариев изменения нагрузки и шести методов управления. Результаты экспериментального исследования показали, что применение предложенного метода способствует повышению доли экспериментальных запусков, удовлетворяющих установленным требованиям к качеству обслуживания, снижению длительности их нарушений и уменьшению хвостовых значений времени отклика по сравнению с исследованными методами управления.
Короткий адрес: https://sciup.org/148334279
IDS: 148334279 | УДК: 004.75 | DOI: 10.18137/RNU.V9187.26.03.P.115
Network Traffic Balancing in Multi-Machine Computing Systems Based on Forecasting Using the Wavelet Regression Method
The relevance of this research stems from the need to improve the stability of network load distribution in multi-machine computing systems under non-stationary and pulsating conditions of the incoming request flow. The objective of this work is to develop and experimentally validate a modified wavelet regression method that accounts for the predicted state of computing nodes during load distribution and computing reserve management. The proposed method involves identifying the regular component of network traffic, assessing the deviation of a node’s current state from its characteristic operating mode, probabilistically evaluating the overload state, deriving an integral risk indicator, and using it to select a computing node. An experimental study was conducted in a simulation environment for nine load variation scenarios and six control methods. The results of the experimental study showed that the application of the proposed method contributes to an increase in the proportion of experimental runs that meet the established service quality requirements, a reduction in the duration of service disruptions, and a decrease in the tail values of response times compared to the control methods studied.
Текст научной статьи Балансировка сетевого трафика многомашинных вычислительных систем с учетом его прогноза вейвлет-регрессионным методом
Современные многомашинные вычислительные системы функционируют в условиях изменяющейся интенсивности входящего потока, неоднородности вычислительных узлов и возникновения кратковременных перегрузок. Поэтому задача балансировки нагрузки включает не только распределение запросов, но и учет ожидаемого состояния узлов до роста очереди и времени отклика.
Традиционные алгоритмы Round Robin и Least Connections отличаются простотой реализации и небольшими вычислительными затратами, однако принимают решения преимущественно по текущему состоянию системы. При нестационарной нагрузке это ограничивает возможность заблаговременного выявления формирующегося перегрузочного состояния.
Балансировка сетевого трафика многомашинных вычислительных систем с учетом его прогноза вейвлет-регрессионным методом
Одним из направлений развития методов управления распределенными вычислительными системами является применение прогнозирования нагрузки. В работе [ 1 ] рассматриваются методы искусственного интеллекта для анализа и прогнозирования трафика телекоммуникационных систем, отмечается взаимосвязь прогнозирования с обеспечением качества обслуживания, планированием ресурсов и автоматической реконфигурацией оборудования. В [ 2 ] прогноз поведения пользователей используется при распределении вычислительной нагрузки. Указанные исследования подтверждают целесообразность перехода от исключительно реактивного управления (при котором управляющее воздействие формируется только после регистрации изменения текущего состояния системы) к методам, учитывающим ожидаемую динамику нагрузки.
В современных исследованиях данная задача рассматривается с различных позиций. В [ 3 ] предложена модель SWT-CLSTM, объединяющая сглаживание, стационарное вейвлет-преобразование, сверточную нейронную сеть, сеть долгой краткосрочной памяти и контрастивное обучение (Contrastive Learning). Основное назначение указанного метода состоит в повышении точности прогнозирования нагрузки облачной вычислительной системы. Вопросы непосредственного формирования правила распределения потока запросов между вычислительными узлами и управления фиксированным резервом в указанной работе не рассматриваются.
В работе [ 4 ] предложен метод прогнозного автоматического масштабирования вычислительных ресурсов, учитывающий ожидаемую нагрузку. На основе прогноза определяются момент изменения числа выделенных ресурсов и их требуемое количество с целью поддержания заданного уровня загрузки. В отличие от [ 4 ] в настоящей работе прогноз используется не только при изменении состава активных вычислительных узлов, но и непосредственно при распределении входящего потока между уже активными узлами.
В обзоре [ 5 ] систематизированы методы автоматического масштабирования облачных приложений. Показано, что при построении систем управления необходимо совместно учитывать характер нагрузки, требования к качеству обслуживания и эффективность использования вычислительных ресурсов. Управляющие воздействия могут формироваться по текущим показателям, прогнозируемым значениям либо на основе их совместного использования.
В работе [ 6 ] предложен метод QEdgeProxy, предназначенный для балансировки нагрузки сервисов интернета вещей с учетом требований QoS в распределенной вычислительной среде. Метод адаптирует маршрутизацию запросов к изменению состояния сервисных экземпляров и сетевой инфраструктуры. В отличие от рассматриваемого подхода предлагаемый в настоящей работе метод дополнительно использует оценку прогнозируемого перегрузочного риска, формируемую на основе анализа регулярной составляющей нагрузки.
Сочетание прогнозирования, маршрутизации и изменения выделенной вычислительной мощности рассматривается также в [ 7 ; 8 ]. В [ 7 ] используется иерархическое прогнозирование совокупного спроса и характеристик отдельных запросов для управления масштабированием и распределением запросов в системах предоставления больших языковых моделей как сервиса. Данный подход ориентирован на специализированную инфраструктуру с графическими процессорами и учитывает объем вычислений, связанный с обработкой отдельных запросов к большим языковым моделям.
Вестник Российского нового университета
Серия «Сложные системы: модели, анализ и управление». 2026. № 3
Метод LA-IMR [ 8 ] предназначен для распределенных облачно-периферийных систем и объединяет аналитическую модель задержки, маршрутизацию, определение числа экземпляров приложения и упреждающее масштабирование. Управляющие решения формируются на основе зависимости времени обработки от загрузки вычислительных ресурсов. В настоящей работе вместо специализированной аналитической модели задержки применяется многокритериальная робастная оценка отклонения состояния каждого вычислительного узла от его собственного нормального режима, дополненная вероятностной оценкой перегрузочного состояния и вейвлет-регрессионным прогнозированием нагрузки.
Ранее авторами был предложен вейвлет-регрессионный метод анализа и имитационного моделирования сетевого трафика [ 9 ], предназначенный для выделения регулярной составляющей временного ряда в условиях выраженной нестационарности и наличия случайных колебаний. Исходный временной ряд декомпозируется по масштабам с использованием вейвлет-преобразования, после чего к полученным компонентам применяется регрессионная обработка. Восстановленный временной ряд отражает регулярную динамику трафика при уменьшенном влиянии случайных колебаний. Устойчивость указанного метода исследована в [ 10 ].
В работах [ 9 ; 10 ] результат вейвлет-регрессионной обработки использовался преимущественно для анализа и моделирования временного ряда. Задача преобразования выделенной регулярной составляющей в управляющее воздействие, непосредственно влияющее на распределение входящего потока между вычислительными узлами, отдельно не рассматривалась.
Целью настоящей статьи является разработка и экспериментальная проверка модифицированного вейвлет-регрессионного метода применительно к задаче прогнозной балансировки пульсирующего сетевого трафика в многомашинной вычислительной системе.
Модификация вейвлет-регрессионного метода для задачи прогнозной балансировки нагрузки
Предлагаемая модификация вейвлет-регрессионного метода предназначена для использования результатов анализа временных рядов сетевой нагрузки при формировании управляющих воздействий в многомашинной вычислительной системе. В отличие от ранее разработанного варианта метода, ориентированного преимущественно на выделение регулярной составляющей сетевого трафика, в настоящей работе результаты обработки используются для оценки вероятности формирования перегрузочного состояния вычислительного узла и последующего распределения входящего потока запросов.
Для каждого вычислительного узла i базовая оценка его текущего состояния определяется выражением
Sibase ( t ) = α C Ci ( t ) + α L Li ( t ) + α E Ei ( t ) + α Q Qi ( t ), (1) где Ci ( t ) – нормированная оценка интенсивности запросов; Li ( t ) – нормированная задержка обработки; Ei ( t ) – нормированная доля ошибочно обработанных запросов; Qi ( t ) – нормированная оценка очереди; α C , α L , α E , α Q – коэффициенты значимости соответствующих составляющих.
Значение Sibase ( t ) характеризует текущее состояние вычислительного узла, однако не содержит информации о характере изменения нагрузки и не позволяет установить нали-
Балансировка сетевого трафика многомашинных вычислительных систем с учетом его прогноза вейвлет-регрессионным методом чие развивающегося перегрузочного процесса. Для решения этой задачи дополнительно анализируется временная динамика характеристик каждого вычислительного узла.
В качестве исходных признаков используются: интенсивность поступления запросов, число активных соединений, время отклика и доля запросов, завершившихся ошибкой. Перед выполнением дальнейшей обработки исключаются признаки, временные ряды которых имеют недостаточную длину, практически отсутствующую изменчивость либо недостаточную долю ненулевых наблюдений. Предварительная проверка исключает использование признаков, не содержащих достаточной информации об изменении состояния вычислительного узла.
К признакам, непосредственно характеризующим нагрузку, применяется ранее разработанный вейвлет-регрессионный метод. В результате обработки выделяется регулярная составляющая временного ряда, отражающая устойчивую динамику исследуемого признака при уменьшении влияния кратковременных случайных колебаний.
Поскольку вычислительные узлы могут различаться по производительности и характерному уровню нагрузки, оценивание выполняется относительно собственного режима работы каждого узла. Для этого определяется нормированное положительное отклонение регулярной составляющей признака:
7 fn Tk (t) - Med T) 1m
Z,(tt) = max 0,-ik^------- ,
[ IQR (Tk)
где Tik ( t ) – регулярная составляющая k -го признака i -го вычислительного узла; Med ( Tik ) – медиана значений данной составляющей в анализируемом временном окне; IQR ( Tik ) – межквартильный размах.
Использование медианы и межквартильного размаха позволяет уменьшить влияние единичных выбросов и кратковременных изменений высокой амплитуды, характерных для сетевого трафика. Полученное значение дополнительно преобразуется в безразмерный диапазон от 0 до 1 на основе эмпирического распределения соответствующего признака. Результат такого преобразования обозначается Rik ( t ). Значение, близкое к нулю, соответствует характерному состоянию признака, а его увеличение свидетельствует о возрастании отклонения от ранее наблюдаемого режима.
Нормированные оценки отдельных признаков объединяются в индекс отклонения состояния вычислительного узла:
mi
It t ) = 1 - П (1 - R k ( t )) , (3)
kel где Ii(t) – интегральный индекс отклонения состояния i-го вычислительного узла; Rik(t) – нормированная оценка отклонения k-го признака; mi – количество признаков, допущенных к обработке для данного узла.
Применяемый способ объединения обеспечивает увеличение Ii ( t ) как при существенном изменении одного признака, так и при одновременном отклонении нескольких характеристик. При значениях отдельных признаков, соответствующих характерному режиму работы узла, значение итогового индекса остается малым.
Вместе с тем единичное высокое значение Ii ( t ) не является достаточным основанием для отнесения вычислительного узла к перегрузочному состоянию, поскольку оно может
Вестник Российского нового университета
Серия «Сложные системы: модели, анализ и управление». 2026. № 3
быть следствием кратковременного случайного всплеска. Для учета последовательности наблюдаемых состояний используется вероятностное реле.
Состояние вычислительного узла рассматривается как один из двух возможных режимов: нормальный или перегрузочный. На каждом шаге обработки определяется апостериорная вероятность перегрузочного состояния:
V (t)=_вШ1 , (4) 1 + (Р;( t) — 1)V (I )
где Vi ( t ) – апостериорная вероятность нахождения i -го вычислительного узла в перегрузочном состоянии; Vi– ( t ) – предварительная вероятность данного состояния, рассчитываемая с учетом вероятностей перехода между нормальным и перегрузочным режимами; β i ( t ) – коэффициент чувствительности, определяемый текущим значением индекса Ii ( t ).
Таким образом, оценка перегрузочного состояния формируется с учетом текущего отклонения наблюдаемых признаков и предшествующего состояния вычислительного узла. Использование вероятностного реле снижает влияние отдельных кратковременных отклонений на формирование управляющего воздействия.
Для дополнительного учета изменчивости наблюдаемых характеристик определяется показатель вариативности rV ( I , t ). Он рассчитывается на основе отношения межквартильного размаха каждого допустимого признака к его характерному медианному уровню с последующим приведением полученных значений к диапазону от 0 до 1. Увеличение rV ( I , t ) соответствует повышению изменчивости характеристик вычислительного узла на рассматриваемом временном интервале.
На основе апостериорной вероятности перегрузочного состояния, индекса текущего отклонения и показателя вариативности формируется составляющая риска Rioverload ( t ), характеризующая текущее перегрузочное состояние вычислительного узла.
При распределении входящего потока необходимо учитывать не только текущее состояние узлов, но и предполагаемое изменение нагрузки на ближайшем временном интервале. Для этого по накопленной истории интенсивности запросов строится прогноз на заданном горизонте прогнозирования h с использованием вейвлет-регрессионного метода (либо иного метода прогнозирования, обеспечивающего оценку будущей интенсивности входящего потока).
По прогнозной последовательности определяется ожидаемый верхний уровень интенсивности входящего потока. Он сопоставляется с характерным верхним уровнем нагрузки вычислительного узла. На основании данного отношения оценивается степень приближения прогнозируемой интенсивности к области повышенной загрузки.
Дополнительно определяется относительное увеличение прогнозируемой интенсивности по сравнению с текущим регулярным уровнем нагрузки. Тем самым прогнозная оценка учитывает два фактора: ожидаемый абсолютный уровень нагрузки относительно характерных возможностей вычислительного узла и интенсивность ее увеличения.
Указанные характеристики после нормирования используются для формирования прогнозной составляющей риска Ripred ( t ). В исследуемой реализации больший вес придается показателю ожидаемого уровня загрузки, поскольку приближение прогнозируемой интенсивности к характерному верхнему уровню непосредственно связано с повышением вероятности формирования очереди и увеличения времени отклика.
Балансировка сетевого трафика многомашинных вычислительных систем с учетом его прогноза вейвлет-регрессионным методом
Наряду с текущим и прогнозируемым состояниями учитывается качество обслуживания (QoS). Для этого формируется составляющая Riqos ( t ), определяемая по времени отклика и доле запросов, завершившихся ошибкой. Ее увеличение соответствует ухудшению характеристик обслуживания при одновременном отклонении состояния вычислительного узла от характерного режима.
Текущая, прогнозная и связанная с качеством обслуживания составляющая объединяются в интегральный показатель риска:
Riski ( t ) = 1 – (1 – Rioverload ( t ))(1 – Ripred ( t ))(1 – Riqos ( t )), (5) где Riski ( t ) – интегральный риск для i -го вычислительного узла; Rioverload ( t ) – составляющая, характеризующая текущее перегрузочное состояние; Ripred ( t ) – составляющая, учитывающая прогнозируемую динамику нагрузки; Riqos ( t ) – составляющая, характеризующая ухудшение качества обслуживания.
Значение Riski ( t ) находится в диапазоне от 0 до 1. При отсутствии выраженных отклонений всех рассматриваемых составляющих значение интегрального риска остается малым. Его увеличение свидетельствует о формировании совокупности признаков, соответствующих повышенной вероятности неблагоприятного состояния вычислительного узла.
Интегральный риск непосредственно учитывается при распределении поступающих запросов. Итоговая оценка вычислительного узла определяется выражением
Simod ( t ) = Sibase ( t ) + λ R max(0, Riski ( t ) – R 0 ), (6) где Simod ( t ) – итоговая оценка состояния i -го вычислительного узла, используемая при распределении запросов; Sibase ( t ) – базовая оценка текущего состояния, определяемая по выражению (1); Riski ( t ) – интегральный риск; R 0 – порог, после превышения которого интегральный риск начинает влиять на управляющее решение; λ R – коэффициент, определяющий степень влияния риска на итоговую оценку.
Если Riski ( t ) < R 0 , дополнительная составляющая выражения (6) равна нулю и решение о распределении нагрузки определяется текущими характеристиками вычислительного узла. При превышении порога R 0 итоговая оценка соответствующего узла увеличивается. Поскольку предпочтение отдается узлам с меньшей итоговой оценкой, повышение интегрального риска приводит к снижению приоритета данного узла при распределении новых запросов.
При распределении входящего потока дополнительно учитывается остаточная безопасная производительность вычислительных узлов. Она определяется на основе номинальной производительности узла, установленного целевого уровня загрузки и накопленной очереди запросов. Если суммарная остаточная производительность активных узлов достаточна для обслуживания поступающего потока, нагрузка распределяется преимущественно между узлами с меньшими значениями Simod ( t ) без превышения их безопасной производительности.
Если суммарная безопасная производительность активных вычислительных узлов оказывается недостаточной, доступная производительность используется полностью, а оставшаяся часть входящего потока распределяется с учетом номинальной производительности узлов. Такой механизм предотвращает чрезмерную концентрацию запросов на вычислительном узле, характеризующемся низкой текущей оценкой, но не располагающем достаточным вычислительным резервом.
Вестник Российского нового университета
Серия «Сложные системы: модели, анализ и управление». 2026. № 3
Предложенный метод используется также при управлении фиксированным вычислительным резервом. В рассматриваемой структуре часть вычислительных узлов образует постоянно доступную базовую группу, а остальные узлы составляют резерв и подключаются при возникновении соответствующей потребности.
Решение о подключении резервного вычислительного узла формируется с учетом прогнозируемой интенсивности входящего потока, доступной безопасной производительности активной группы и текущего состояния вычислительных узлов. Подключение резерва инициируется при прогнозируемой недостаточности безопасной производительности либо при формировании признаков повышенного перегрузочного риска. При этом учитывается время, необходимое для перехода резервного узла в рабочее состояние.
Отключение резервного вычислительного узла допускается после устойчивого восстановления установленных показателей качества обслуживания и при условии, что оставшейся вычислительной мощности достаточно для обработки прогнозируемого входящего потока.
Таким образом, предлагаемая модификация связывает ранее разработанный вейвлет-регрессионный анализ сетевого трафика с задачей прогнозной балансировки нагрузки. Результат анализа используется теперь не только для визуализации и выделения тренда, но и для формирования вероятностного перегрузочного признака, влияющего на маршрутизацию транзакций.
Экспериментальное исследование
Экспериментальная проверка предложенного метода выполнена с использованием дискретно-временной имитационной модели многомашинной вычислительной системы, реализованной в среде MATLAB. Продолжительность одного запуска составляла 3600 с при шаге моделирования 1 с.
В состав моделируемой системы входили шесть вычислительных узлов. Три узла образовывали базовую группу, остальные три составляли фиксированный вычислительный резерв и подключались при возникновении соответствующего управляющего воздействия. В однородной конфигурации производительность каждого узла принималась равной 120 запросам/с. Для исследования неоднородной вычислительной среды использовались значения производительности 100, 120, 140, 90, 160 и 110 запросов/с. Суммарная производительность базовой и резервной групп в данной конфигурации составляла по 360 запросов/с.
Продолжительность подключения резервного вычислительного узла устанавливалась равной 45 с, продолжительность отключения – 20 с. Целевой уровень использования вычислительной мощности составлял 0,8. Таким образом, управляющий алгоритм должен был учитывать не только текущее состояние системы, но и задержку между принятием решения о подключении резервного узла и фактическим вводом его вычислительной мощности в эксплуатацию.
Качество обслуживания (QoS) оценивалось по времени отклика, доле ошибочно обработанных запросов и относительному показателю пропускной способности.
Показатель P95 представляет собой 95-й процентиль времени отклика, то есть значение, которое не превышается для 95 % обработанных запросов. Аналогично P99 соответствует 99-му процентилю времени отклика и характеризует верхнюю часть распределения задержки для 99 % обработанных запросов.
Балансировка сетевого трафика многомашинных вычислительных систем с учетом его прогноза вейвлет-регрессионным методом
Доля ошибочно обработанных запросов (Error Rate) определяется как отношение общего числа запросов, завершившихся ошибкой, к общему числу поступивших запросов. При этом учитываются ошибки, обусловленные невозможностью маршрутизации запроса и отказом вычислительного узла.
Относительный показатель пропускной способности (Throughput Ratio) определяется как отношение числа успешно обработанных запросов к общему числу поступивших запросов.
В экспериментальной модели устанавливались следующие ограничения QoS: Р95 ≤ 120 мс, Р99 ≤ 180 мс, Error Rate ≤ 0,02, Throughput Ratio ≥ 0,02.
Агрегированный критерий QoS считался выполненным при одновременном соблюдении всех условий по результатам полного запуска. Дополнительно использовался строгий критерий QoS, предусматривающий отсутствие локальных временных интервалов, на которых нарушалось хотя бы одно из установленных ограничений. Такое разделение позволяет учитывать случаи, когда интегральные показатели по завершении эксперимента соответствуют заданным требованиям, однако в отдельные моменты времени система находилась в состоянии кратковременной перегрузки.
Прогнозирование интенсивности входящего потока выполнялось вейвлет-регресси-онным методом. Максимальная длина используемого исторического участка составляла 768 отсчетов, а горизонт прогнозирования – 45 с.
Для оценки точности прогнозирования применялась средняя абсолютная ошибка (Mean Absolute Error, MAE).
Систематическое смещение ошибки прогнозирования (Bias) определяется как среднее арифметическое разностей между прогнозируемыми и соответствующими фактическими значениями уровня нагрузки. Отрицательное значение Bias соответствует систематическому занижению прогноза, положительное – его завышению.
Для проверки работоспособности методов сформировано девять вариантов экспериментальной нагрузки. Uniform соответствует приблизительно постоянной интенсивности входящего потока со случайными колебаниями; progressive – ее постепенному увеличению; decreasing – снижению; periodic – периодическому изменению. Вариант burst моделирует кратковременный резкий всплеск нагрузки, а rampburst – ее постепенное увеличение до максимального уровня с последующим снижением. Mixed сочетает периодические изменения и кратковременный всплеск. В варианте heterogeneous периодически изменяющийся поток обслуживается неоднородными по производительности и времени отклика вычислительными узлами. Failover предусматривает отказ одного узла на 240-й и последующее перераспределение запросов между оставшимися доступными узлами.
Сравнительное экспериментальное исследование проводилось для шести вариантов управления, различающихся правилами распределения входящего потока и управления резервными вычислительными узлами:
-
• Round Robin с реактивным управлением резервом – циклическое распределение поступающих запросов между доступными вычислительными узлами;
-
• Least Connections с реактивным управлением резервом – выбор вычислительного узла с меньшей текущей нагрузкой;
-
• учет QoS с реактивным управлением резервом – распределение запросов на основе текущей загрузки, времени отклика, доли ошибочно обработанных запросов и состояния очереди;
Вестник Российского нового университета
Серия «Сложные системы: модели, анализ и управление». 2026. № 3
-
• учет QoS с прогнозным управлением резервом – аналогичный принцип распределения запросов с подключением резервных узлов на основе прогнозируемой интенсивности входящего потока;
-
• учет задержки с прогнозным управлением резервом – адаптированный вариант подхода LA-IMR [8], учитывающий текущее время отклика, загрузку узла и дополнительное время ожидания, обусловленное накопленной очередью;
-
• предложенный метод – распределение входящего потока с учетом многокритериальной оценки состояния узла, интегрального риска перегрузки и остаточной безопасной производительности; управление резервом выполняется с учетом прогнозируемой нагрузки и перегрузочного риска.
На Рисунке 1 приведены доли экспериментальных запусков, удовлетворяющих агрегированному и строгому критериям QoS.
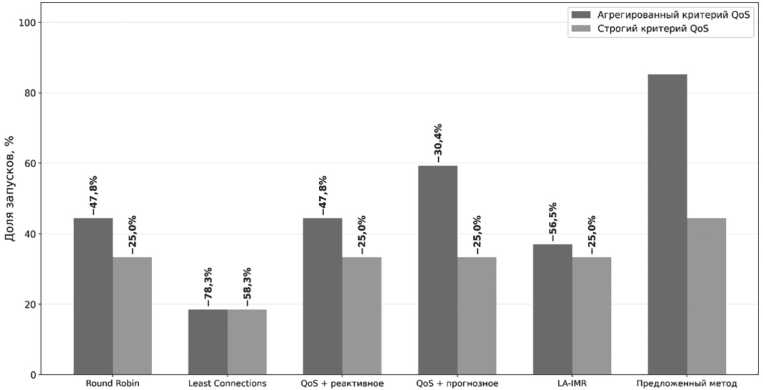
Рисунок 1. Сравнение методов управления по доле запусков с выполнением требований QoS Источник: здесь и далее рисунки выполнены авторами по результатам экспериментального исследования
При применении предложенного метода агрегированный критерий был выполнен в 85,2 % запусков. Полученные результаты свидетельствуют о том, что в условиях рассматриваемой имитационной модели совместный учет интегрального риска, остаточной безопасной производительности и прогнозируемой нагрузки сопровождался увеличением доли запусков, завершившихся с выполнением установленных агрегированных ограничений QoS.
Значения 95-го и 99-го процентилей времени отклика для исследуемых методов представлены на Рисунке 2.
Как следует из Рисунка 2, среднее по всем вариантам нагрузки значение P99 при применении предложенного метода составило 1233,9 мс. Для метода с учетом QoS и прогнозным управлением резервом получено 1333,0 мс, что соответствует снижению на 7,4 %. При использовании учета QoS совместно с реактивным управлением среднее значение P99 составило 2155,5 мс, при преимущественном учете задержки и прогнозном управлении – 2187,9 мс, для Least Connections – 2960,7 мс, для Round Robin – 3365,3 мс.
Балансировка сетевого трафика многомашинных вычислительных систем с учетом его прогноза вейвлет-регрессионным методом
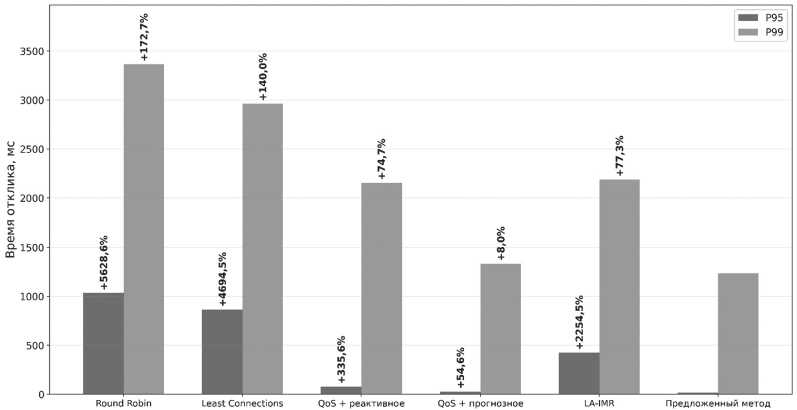
Рисунок 2. Сравнение методов управления по 95-му и 99-му процентилям времени отклика
Среднее значение P95 для предложенного метода составило 18,0 мс, а для метода с учетом QoS и прогнозным управлением – 27,9 мс. При интерпретации усредненных значений процентилей необходимо учитывать неоднородность экспериментальных вариантов нагрузки. Кратковременные тяжелые перегрузки в большей степени влияют на верхнюю часть распределения времени отклика и, соответственно, на значение P99.
Сравнение методов по средней длительности интервалов нарушения требований QoS представлено на Рисунке 3.
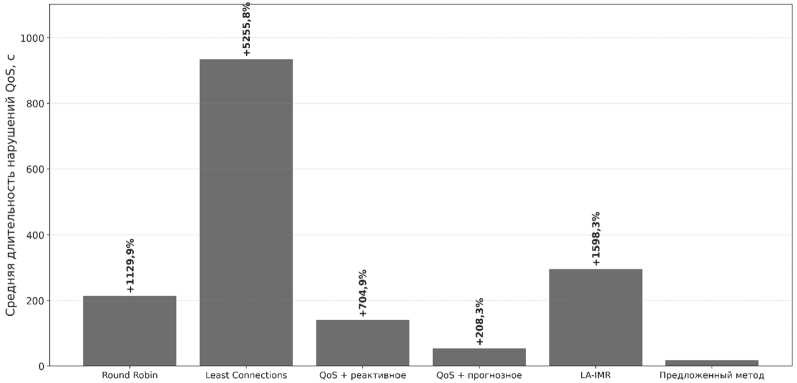
Рисунок 3. Сравнение методов управления по длительности нарушений требований QoS
Вестник Российского нового университета
Серия «Сложные системы: модели, анализ и управление». 2026. № 3
Согласно Рисунку 3 средняя длительность интервалов нарушения QoS для предложенного метода составила 17,4 с. за один запуск. Для метода с учетом QoS и прогнозным управлением резервом соответствующее значение составило 53,8 с. Снижение составило 36,3 с., или 67,6 %.
Для метода с учетом текущих показателей QoS и реактивным управлением средняя длительность нарушений составила 140,4 с, для Round Robin – 214,6 с, для метода с учетом задержки и прогнозным управлением – 296,3 с, для Least Connections – 934,3 с.
Анализ результатов по отдельным вариантам нагрузки показывает зависимость эффективности управляющих решений от характера изменения входящего потока. При периодической нагрузке (periodic) значение P99 уменьшилось с 83,3 мс для метода с учетом QoS и прогнозным управлением до 64,6 мс при применении предложенного метода. Средняя длительность нарушения требований QoS снизилась с 39 до 27 с.
Для rampburst значения P99 составили, соответственно, 357,6 и 141,4 мс, что соответствует снижению на 60,5 %. Длительность нарушения QoS уменьшилась с 51 до 31 с.
При смешанном характере нагрузки (mixed) значение P99 уменьшилось с 64,8 до 56,8 мс, а средняя длительность нарушения требований QoS – с 13,3 до 2,7 с.
Наиболее существенное различие получено для heterogeneous. При использовании метода с учетом QoS и прогнозным управлением значение P99 составило 471,9 мс, тогда как для предложенного метода – 58,4 мс. Средняя длительность нарушения QoS снизилась с 277,3 до 20,3 с. Полученный результат указывает на существенное влияние учета индивидуальных характеристик вычислительных узлов при неоднородном составе системы.
В условиях временного отказа вычислительного узла (failover) значение P99 уменьшилось с 621,0 до 385,2 мс, а средняя длительность нарушения QoS – с 41 до 16 с.
Отдельного рассмотрения требует вариант burst. Ни один из исследованных методов в данном случае не обеспечил выполнение агрегированного критерия QoS. Значение P99 превышало 10 с, а различие между прогнозными вариантами по данному показателю практически отсутствовало. Причиной является резкое изменение интенсивности без предшествующего участка роста, который мог бы быть использован для формирования заблаговременного управляющего воздействия. Кроме того, физическое подключение резервного вычислительного узла занимает 45 с. Следовательно, в рассматриваемой конфигурации прогнозное управление не обеспечивает предотвращение перегрузки при внезапном возмущении, не имеющем наблюдаемых предварительных признаков.
Доля использования резервной вычислительной мощности для исследуемых методов приведена на Рисунке 4.
Как следует из Рисунка 4, для предложенного метода средняя доля используемой резервной мощности составила 40,5 %. Для метода с учетом QoS и прогнозным управлением резервом получено 32,6 %, аналогичное значение наблюдалось для варианта с преимущественным учетом задержки.
Особенно отчетливо данная особенность проявилась при равномерной нагрузке (uniform). Все исследуемые методы в данном случае обеспечивали выполнение агрегированных требований QoS. При этом предложенный метод использовал в среднем 22,9 % доступной резервной мощности, тогда как для двух других вариантов с прогнозным управлением соответствующая величина составляла около 4 %.
Балансировка сетевого трафика многомашинных вычислительных систем с учетом его прогноза вейвлет-регрессионным методом
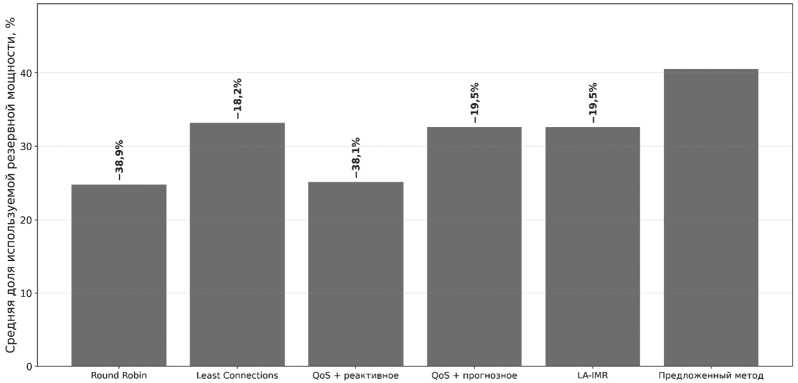
Рисунок 4. Сравнение методов управления по использованию резервной вычислительной мощности
Дополнительно оценивалось число ложных, запоздалых и аварийных подключений резервных вычислительных узлов. Для предложенного метода среднее число запоздалых подключений составляло 1,26 за один запуск, тогда как для метода с учетом QoS и прогнозным управлением – 2,22. Среднее число аварийных подключений составило, соответственно, 0,70 и 1,04, а число ложных подключений – 2,96 и 4,22 соответственно.
Полученные результаты указывают на наличие компромисса между соблюдением ограничений качества обслуживания и объемом используемых резервных вычислительных ресурсов. При применении предложенного метода снижение длительности нарушений QoS и числа запоздалых подключений сопровождалось увеличением общего времени использования резервной вычислительной мощности. Поэтому параметры управляющего контура должны определяться с учетом допустимого для конкретной вычислительной системы соотношения между требованиями QoS и затратами вычислительных ресурсов.
Проведенное экспериментальное исследование показывает, что результат применения метода существенно зависит от характера изменения входящего потока. Наибольшее снижение длительности нарушений QoS относительно рассмотренного метода с прогнозным управлением и учетом показателей QoS получено при смешанной и неоднородной нагрузке, а также при временном отказе вычислительного узла.
Заключение
В работе предложена модификация вейвлет-регрессионного метода анализа сетевого трафика применительно к задаче прогнозной балансировки нагрузки в многомашинной вычислительной системе. Результат обработки временного ряда используется для формирования робастного индекса отклонения состояния вычислительного узла, апостериорной вероятности перегрузочного состояния и интегрального показателя риска.
Интегральный риск учитывается при распределении входящего потока совместно с остаточной безопасной производительностью вычислительных узлов, а прогноз нагрузки используется при управлении фиксированным вычислительным резервом.
Вестник Российского нового университета
Серия «Сложные системы: модели, анализ и управление». 2026. № 3
Экспериментальное исследование выполнено для девяти сценариев изменения нагрузки и шести методов управления. Во всех методах с прогнозным управлением использовался одинаковый прогнозный блок, что позволило сопоставить особенности управляющих правил при неизменном способе прогнозирования нагрузки.
В проведенной серии экспериментов агрегированный критерий QoS при применении предложенного метода выполнялся в 85,2 % запусков против 59,3 % для метода с учетом QoS и прогнозным управлением. Среднее значение P99 снизилось с 1333,0 до 1233,9 мс, а длительность нарушений QoS – с 53,8 до 17,4 с.
Наиболее выраженные различия наблюдались при периодической, смешанной и неоднородной нагрузке, а также при отказе вычислительного узла. При внезапном всплеске нагрузки выполнение ограничений QoS не было обеспечено ни одним методом.
Улучшение показателей QoS сопровождалось увеличением времени использования резервных узлов на 25,3 %, что отражает компромисс между качеством обслуживания и объемом задействованного вычислительного резерва.
Полученные результаты подтверждают возможность применения разработанного метода для управления распределением сетевой нагрузки в условиях рассматриваемой имитационной модели. Распространение полученных выводов на другие многомашинные вычислительные системы требует дополнительной экспериментальной проверки.
Дальнейшее исследование целесообразно направить на определение параметров управляющего контура, обеспечивающих требуемое соотношение между соблюдением ограничений QoS и использованием вычислительного резерва, увеличение числа повторных запусков для проведения статистической проверки различий, исследование чувствительности к горизонту прогнозирования и времени подключения резервных узлов, а также экспериментальную проверку метода на реальной распределенной вычислительной инфраструктуре.
