
Двухступенчатая архитектура системы интеллектуального анализа финансовых документов на основе CNN и больших языковых моделей
Журнал: Известия Самарского научного центра Российской академии наук @izvestiya-ssc
Рубрика: Информатика, вычислительная техника и управление
Статья в выпуске: 4 т.28, 2026 года.
Бесплатный доступ
В условиях цифровизации экономики и роста объёмов финансовой документации возрастает актуальность автоматизации анализа исполнения финансового плана предприятий малого и среднего бизнеса (МСП). Традиционная ручная обработка разнородных документов: договоров, актов выполненных работ, счетов-фактур и расчётных листов в форматах PDF, DOCX и растровых изображений – требует значительных временных затрат и сопровождается высокой вероятностью ошибок, обусловленных человеческим фактором. В работе предложена двухступенчатая архитектура системы интеллектуального анализа финансовых документов, объединяющая свёрточную нейронную сеть (CNN) на базе MobileNetV2 для извлечения структурированных реквизитов и большую языковую модель (LLM) для выполнения план-факт анализа и формирования интерпретируемых аналитических рекомендаций. Первая ступень выполняет извлечение и нормализацию структурированных реквизитов на основе анализа пространственной структуры документа, классификации его типа, распознавания текста средствами Tesseract OCR и последующей обработки полученных данных. Вторая ступень выполняет сопоставление извлечённых фактов с табличными данными финансового плана, вычисляет отклонения по статьям и периодам, формирует интегральную оценку качества исполнения плана и генерирует текстовые пояснения и управленческие рекомендации. Отличительной особенностью предлагаемой архитектуры является использование структурированных фактов, сформированных на первой ступени, в качестве документального основания выводов второй ступени. Таким образом проверяются аналитические заключения и выявляются расхождения между финансовым планом и первичным документооборотом. Экспериментальная апробация проведена на выборке из 100 реальных финансовых документов предприятия ООО «СПЕЦПРОМСТРОЙ» за период 2023-2025 гг. и 400 синтетически сгенерированных документов. Точность распознавания текста составила 92%, точность анализа разметки документа – 94%, а точность нормализации извлечённых полей – 85%. Применение разработанной системы сокращает время обработки на 42% (с 10 до 5,8 ч при обработке 30 документов) и снижает количество ошибок на 24% по сравнению с ручной обработкой аналогичного объёма данных. Полученные результаты доказывают эффективность предложенного архитектурного решения для автоматизации анализа финансовых документов предприятий МСП в условиях ограниченных вычислительных и кадровых ресурсов.
Короткий адрес: https://sciup.org/148334345
IDS: 148334345 | УДК: 004.891.2 | DOI: 10.37313/1990-5378-2026-28-4-202-211
A Two-Stage Architecture for a Financial Document Mining System Based on CNN and Large Language Models
With the digitalization of the economy and the growth of financial documentation, the need to automate the analysis of financial plan execution in small and medium-sized enterprises (SMEs) is growing. Traditional manual processing of disparate documents—contracts, certificates of completion, invoices, and payslips in PDF, DOCX, and rasterimage formats—is time-consuming and is prone to human error. This paper proposes a two-stage architecture for a financial document mining system. It combines a MobileNetV2-based convolutional neural network (CNN) for extracting structured attributes and a large language model (LLM) for performing plan-fact analysis and generating interpretable analytical recommendations. The first stage extracts and normalizes structured attributes based on an analysis of the document’s spatial structure, document type classification, text recognition using Tesseract OCR, and subsequent processing of the resulting data. The second stage compares the extracted facts with the financial plan’s tabular data, calculates variances by item and period, generates an integrated assessment of the plan’s performance quality, and generates text explanations and management recommendations. A distinctive feature of the proposed architecture is the use of structured facts generated in the first stage as a documentary basis for the conclusions of the second stage. This verifies analytical conclusions and identifies discrepancies between the financial plan and the primary document flow. The pilot was conducted on a sample of 100 real financial documents of SPETSPROMSTROY LLC for the period 2023- 2025 and 400 synthetically generated documents. The text recognition accuracy was 92%, the document markup analysis accuracy was 94%, and the normalization accuracy of extracted fields was 85%. The developed system reduced processing time by 42% (from 10 to 5.8 hours when processing 30 documents) and reduced errors by 24% compared to manual processing of a similar volume of data. The obtained results demonstrate the effectiveness of the proposed architectural solution for automating the analysis of financial documents of SMEs with limited computing and human resources.
Текст научной статьи Двухступенчатая архитектура системы интеллектуального анализа финансовых документов на основе CNN и больших языковых моделей
Анализ исполнения финансового плана является одной из основных задач управления предприятием, заключающейся в сопоставлении плановых показателей бюджета с фактическими данными о доходах и расходах, выявлении причин отклонений и выработке корректирующих управленческих решений [1]. На предприятиях малого и среднего бизнеса (МСП) организация данного процесса имеет ряд особенностей: анализ выполняется небольшим числом сотрудников (как правило, бухгалтером или финансовым менеджером) без выделенной аналитической службы; специализированные корпоративные системы бюджетирования зачастую недоступны из-за высокой стоимости внедрения и сопровождения; ограничены вычислительные ресурсы [2].
Исходными данными для анализа служит первичный документооборот: договоры, счета-фактуры, акты выполненных работ, расчётные листы, представленные в различных форматах (PDF, DOCX, Excel, сканированные изображения) и не имеющие унифицированной структуры [3]. Сопоставление плановых и фактических показателей в ручном режиме требует последовательного решения двух взаимосвязанных задач: сначала извлечения реквизитов из неструктурированных
документов, затем проведения собственно финансового анализа. По экспертным оценкам, ручная обработка сопровождается ошибками в 10–15 % документов и занимает около 8 часов на обработку 100 документов.
Методы машинного обучения демонстрируют высокую эффективность при решении обеих указанных задач [4, 5]. Свёрточные нейронные сети (CNN) успешно применяются для анализа визуальной структуры документов и классификации их типов [6-8], а большие языковые модели (LLM) – для интерпретации числовых показателей и генерации аналитических текстов [9].
Однако существующие решения, как правило, автоматизируют лишь отдельные этапы обработки: либо извлечение информации из документов, либо аналитическую обработку уже структурированных данных, не обеспечивая сквозного процесса «от документа до рекомендации». Кроме того, большинство систем интеллектуальной обработки документов разрабатывается для крупных организаций и не учитывает специфику предприятий МСП, связанную с ограниченными вычислительными ресурсами, отсутствием стандартизации документооборота и небольшими объёмами обучающих данных.
Двухэтапная организация процесса анализа, включающая первоначальную сверку документов и последующую интерпретацию выявленных отклонений, обусловливает построение двухступенчатой архитектуры системы, в которой первая ступень воспроизводит функции оператора по извлечению реквизитов, а вторая — функции аналитика по объяснению отклонений. Целью настоящей работы является разработка и экспериментальная оценка эффективности двухступенчатой архитектуры на основе свёрточных нейронных сетей и больших языковых моделей для автоматизации анализа исполнения финансового плана предприятий малого и среднего бизнеса.
Для достижения поставленной цели решаются следующие задачи:
-
1. Разработка архитектуры двухступенчатого конвейера обработки, обеспечивающего модульность и раздельную оценку качества каждой ступени.
-
2. Реализация CNN-модуля извлечения структурированных реквизитов из неструктурированных финансовых документов.
-
3. Реализация LLM-модуля план-факт анализа с генерацией интерпретируемых аналитических рекомендаций.
-
4. Экспериментальная оценка эффективности системы на реальных данных предприятия МСП.
-
5. Количественное сравнение двухступенчатой архитектуры с одноступенчатой архитектурой обработки.
Научная новизна работы заключается в способе интеграции свёрточной нейронной сети и большой языковой модели, при котором структурированные факты, извлечённые первой ступенью, передаются второй ступени в качестве документального основания формируемых выводов. Предложенный подход обеспечивает ряд преимуществ по сравнению с одноступенчатой обработкой: во-первых, каждое аналитическое утверждение связывается с подтверждающим документом, что снижает вероятность формирования необоснованных выводов языковой моделью; во-вторых, появляется возможность выявления расхождений между финансовым планом и документооборотом, включая бюджетные статьи без подтверждающих документов и договоры, не отражённые в плане; в-третьих, качество работы каждой ступени оценивается независимо, что упрощает локализацию и исправление ошибок.
ОБЗОР СУЩЕСТВУЮЩИХ ПОДХОДОВ
Задача извлечения структурированных данных из неструктурированных документов активно развивается в последние годы [10]. Современные подходы объединяют методы оптического распознавания символов [11] и глубокого обучения, учитывающие пространственную структуру (разметку) документа.
Наиболее близкими к настоящей работе являются архитектуры, объединяющие визуальный и текстовый анализ документа. Семейство моделей LayoutLM [12, 13] выполняет совместное предо-бучение на тексте, координатах и изображении страницы и стало одним из наиболее распространённых решений для понимания структуры деловых документов. Модель Donut [14] реализует сквозное извлечение структурированных данных непосредственно из изображения документа без отдельного этапа распознавания символов. Модель DocLLM [15], ориентированная на обработку корпоративных и финансовых документов, дополняет большую языковую модель информацией о пространственной структуре страницы. Общим ограничением перечисленных моделей являются высокая вычислительная сложность, значительное число параметров и необходимость использования графических ускорителей, что затрудняет их практическое применение на предприятиях малого и среднего бизнеса.
В финансовой сфере большие языковые модели используются для анализа тональности финансовой отчётности (FinBERT [16]), решения задач числового анализа финансовых таблиц (FinQA [17]) и комплексной финансовой аналитики (BloombergGPT [9]). Однако перечисленные подходы ориентированы преимущественно на обработку уже структурированных или текстовых данных и не решают задачу извлечения реквизитов из первичных финансовых документов. Работы, объединяющие извлечение реквизитов и план-факт анализ в рамках единого сквозного процесса применительно к документообороту предприятий МСП, авторам неизвестны. Предлагаемая архитектура направлена на устранение данного ограничения.
Для реализации первой ступени выбрана компактная архитектура MobileNetV2 [18], обеспечивающая рациональное соотношение точности классификации и вычислительной эффективности благодаря использованию инвертированных остаточных блоков. По сравнению с исходной архитектурой MobileNet [19] она требует меньшего объёма вычислений при сопоставимой точности, что особенно важно при развёртывании системы в условиях ограниченных вычислительных ресурсов предприятий МСП.
Практическая эффективность применения больших языковых моделей в финансовых процессах подтверждается отраслевыми исследованиями [20]. Во второй ступени используется русскоязычная модель семейства GPT-2 (RuGPT-2), выбор которой обусловлен возможностью локального развёртывания и последующего дообучения без применения специализированного вычислительного оборудования.
Модульные архитектуры, в которых извлечение информации и её последующий анализ реализуются раздельными компонентами, получили широкое распространение в системах интеллектуальной обработки данных [10]. Их основными преимуществами являются возможность независимой оценки качества и модернизации отдельных модулей, а также повышение интерпретируемости результатов за счёт явного разделения этапов обработки.
АРХИТЕКТУРА СИСТЕМЫ
Общая архитектура двухступенчатого конвейера обработки
Предлагаемая система реализована в виде двух последовательно связанных ступеней (рис. 1): извлечения структурированных фактов из финансовых документов и план-факт анализа с формированием интерпретируемых аналитических выводов. Отличительной особенностью архитектуры является передача структурированных фактов, сформированных на первой ступени, второй ступени в качестве документального основания аналитических выводов, а также реализация механизмов контроля дубликатов и привязки извлечённых фактов к статьям финансового плана. Тем самым повышается проверяемость результатов анализа и обеспечивается выявление расхождений между финансовым планом и первичным документооборотом. Модульная организация архитектуры обеспечивает раздельную оценку точности извлечения реквизитов и качества аналитики отклонений.
Система включает следующие функциональные компоненты:
-
- модуль аутентификации и разграничения доступа (токены JWT, ролевая модель «администра-тор/сотрудник», журнал безопасности);
-
- CNN-модуль извлечения реквизитов с возможностью дообучения на новых типах документов [7];
-
- LLM-модуль формирования аналитических рекомендаций [9, 15].
Ступень 1 – Извлечение реквизитов на основе CNN и распознавания текста
Первая ступень предназначена для преобразования неструктурированного документа в набор структурированных полей, необходимых для идентификации финансового события и его привязки к статьям бюджета. На вход подаётся файл документа (договор, акт, счёт-фактура), на выходе формируется карточка документа в формате JSON, содержащая нормализованные значения реквизитов и ссылку на исходный файл.
Из каждого документа извлекаются следующие реквизиты:
-
- контрагент (наименование организации или стороны договора);
-
- даты (начало и окончание действия, дата заключения);
-
- сумма обязательства;
-
- тип договора (доходы или расходы) для отнесения к соответствующему финансовому потоку.
CNN применяется для анализа визуального представления документа на уровне страницы и выделения областей, содержащих основные реквизиты.
Алгоритм обработки включает следующие этапы:
-
1. Конвертация документа в растровое изображение размером 224×224 пикселя.
-
2. Классификация и выделение основных полей с помощью CNN на основе архитектуры MobileNetV2 (TensorFlow/Keras): классификация типа документа (доход/расход), регрессия для извлечения числовых полей (сумма, даты) [18].
-
3. Распознавание текста посредством Tesseract OCR [11] с последующей нормализацией: даты приводятся к формату ISO 8601, числовые значения – к формату с плавающей точкой, наименования контрагентов сопоставляются со справочником методом нечёткого сравнения строк.
-
4. Проверка дубликатов по комбинации «номер, сумма, дата».
-
5. Формирование результирующей записи – карточки документа в формате JSON, передаваемой второй ступени.
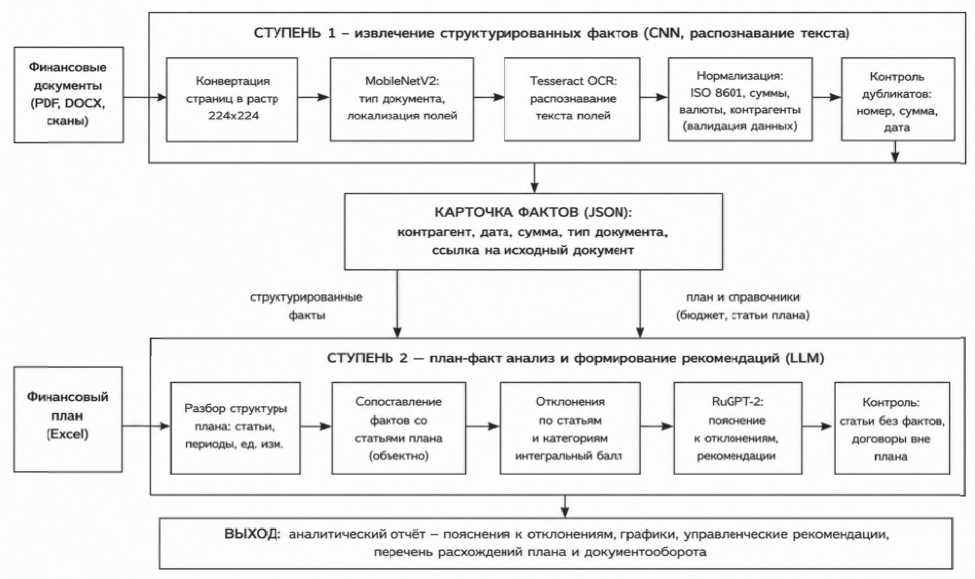
Рис. 1 – Архитектура двухступенчатого конвейера обработки финансовых документов
Ступень 2 – План-факт анализ и формирование рекомендаций на основе LLM
Вторая ступень ориентирована на обработку табличного финансового плана и фактических значений, а также на формирование аналитического вывода. На данном этапе система выполняет:
-
- разбор структуры Excel-таблицы (статьи бюджета, периоды, единицы измерения);
-
- нормализацию наименований статей;
-
- сопоставление «план–факт» по идентификатору статьи и периоду;
-
- вычисление отклонений по каждой паре «статья–период».
LLM-модуль реализован на базе русскоязычной модели семейства GPT-2 (RuGPT-2) и формирует текстовые пояснения на основе рассчитанных отклонений и контекста, полученного из извлечённых фактов первой ступени (контрагент, сумма, тип обязательства, временной интервал). Использование фактов из документов обеспечивает:
-
- сопоставление значений по сумме, периоду и типу с документальными основаниями;
-
- выявление бюджетных статей без подтверждающих документов и договоров, не отражённых в плане или факте;
-
- группировку отклонений по контрагентам и типам обязательств для формирования приоритетов проверки.
Дополнительно реализована адаптивная группировка по периоду: при горизонте свыше 90 дней – помесячная агрегация, от 15 до 90 дней – понедельная, менее 14 дней – подневная.
Показатели качества исполнения финансового плана
Для количественной оценки исполнения финансового плана используются классические показатели финансового анализа, включая коэффициенты ликвидности, рентабельности и покрытия долга, рассчитываемые по стандартным методикам [21]. В отличие от традиционного подхода предлагаемая методика дополнена показателем доли аномальных операций, единой процедурой нормировки показателей и интегральным баллом качества исполнения плана, используемым при формировании аналитических рекомендаций.
Доля аномальных операций:
I [ip |^-/г|> 2ff] | где и – среднее и стандартное отклонение сумм по статьям.
Каждый показатель нормализуется в оценку , где 0 соответствует критическому со стоянию, 1 – норме. Интегральный балл качества вычисляется как:
Q = £wk-sk'^wk = 1- к к
Рекомендации формируются для статей, корректировка которых повышает интегральный балл более чем на пороговое значение .
Отклонение по доходной части:
^revenue
Факт..,,вп,в — План„в,,вП!.в
План f C C Z 1Л C
Положительное значение свидетельствует о перевыполнении плана. Отклонение по расходной части:
План - Факт
^expense
вл в в л визе X 100%.
Положительное значение свидетельствует об экономии средств.
Привязка фактов к плановым записям осуществляется по атрибуту linked_planned_contract, обеспечивая обработку исключительно документально подтверждённых статей.
ЭКСПЕРИМЕНТАЛЬНАЯ ОЦЕНКА
Условия эксперимента
Экспериментальная апробация проведена на базе ООО «СПЕЦПРОМСТРОЙ». Для оценки использована выборка из 100 реальных и 400 синтетически сгенерированных финансовых документов за период 2023-2025 гг., включающий договоры, акты выполненных работ, счета-фактуры в форматах PDF, DOCX и сканированные изображения.
Результаты извлечения реквизитов (ступень 1)
Точность работы первой ступени оценивалась по компонентам конвейера (таблица 1).
Таблица 1 – Точность извлечения реквизитов на выборке из 500 документов
|
Этап обработки |
Точность |
Комментарий |
|
Распознавание текста (OCR) |
92% |
500 документов |
|
CNN: классификация типа документа и элементов разметки |
94% |
входное изображение 224*224 |
|
Нормализация дат |
98% |
приведение к формату ISO 8601 |
|
Нормализация полей в целом |
85% |
даты, суммы, контрагенты |
Наибольшая точность достигнута при нормализации дат (98%), тогда как общая точность нормализации полей составила 85%, что обусловлено разнообразием форматов записи сумм и наименований контрагентов. Общая точность распознавания текста составила 92%, а классификации типа документа и элементов разметки – 94%.
Динамика обучения CNN-модуля (MobileNetV2) представлена на рисунке 2. График отражает зависимость функции потерь и точности на обучающей и валидационной выборках от числа эпох.
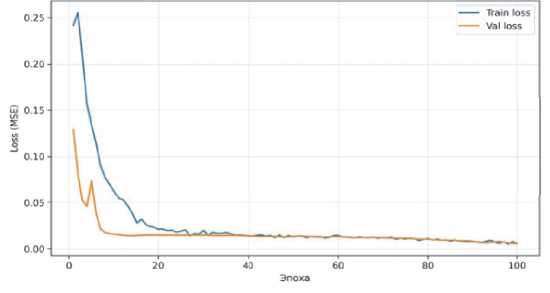
Рис. 2 – Кривые обучения CNN-модуля
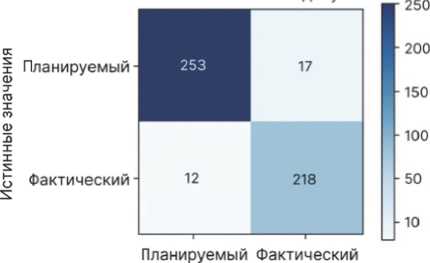
Матрица ошибок классификации типов документов (доход/расход) представлена на рисунке 3.
v.^^^-m^
Рис. 3 – Матрица ошибок классификации типов документов
На рисунке 4 представлено сравнение качества извлечения отдельных типов реквизитов (контрагент, дата, сумма, тип договора). Для оценки качества классификации элементов разметки использовались метрики Accuracy, Precision, Recall и F1. Предложенная модель на базе MobileNetV2 достигла общей точности классификации (Accuracy) 94%, при средних по классам значениях Precision = 0,91, Recall = 0,88 и F1 = 0,89 (классы «Контент», «Таблица», «Сумма», «Текст»). Наилучший результат получен для детекции табличных блоков «Сумма» (F1 = 0,93), что особенно важно при обработке финансовых документов предприятий малого и среднего бизнеса. Полученные результаты доказывают пригодность предложенной модели для последующего распознавания текста и извлечения
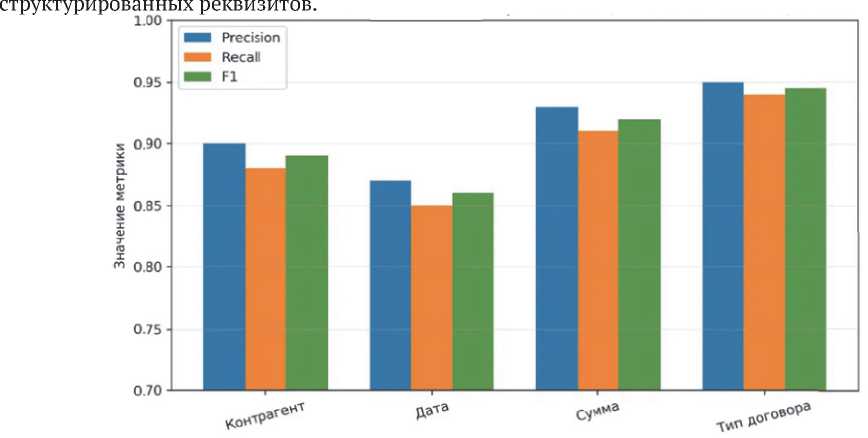
Рис. 4 – Точность извлечения по типам реквизитов (Precision, Recall, F1)
Сравнение двухступенчатой и одноступенчатой архитектур
Для количественной оценки эффективности двухступенчатой архитектуры проведено сравнение с одноступенчатой архитектурой, в которой текст, распознанный средствами Tesseract OCR, передаётся языковой модели непосредственно, без формирования промежуточного структурированного представления в виде карточек фактов. Обе архитектуры оценивались на одной и той же выборке из 500 документов, включавшем 100 реальных и 400 синтетически сгенерированных документов, по трём критериям: качеству извлечения основных реквизитов (F1-мера), доле аналитических утверждений, не имеющих документального подтверждения, и числу выявленных расхождений между финансовым планом и первичным документооборотом (таблица 2).
Использование промежуточного структурированного представления повышает качество извлечения реквизитов (F1: 0,89 вместо 0,74), существенно снижает долю аналитических утверждений без документального подтверждения и обеспечивает выявление расхождений между финансовым планом и первичным документооборотом, недоступных при одноступенчатой обработке.
Результаты план-факт анализа и практическая значимость (ступень 2)
Практическая значимость системы оценивалась сравнением автоматизированного режима с ручным по двум критериям (табл. 3):
Таблица 2 – Сравнение одноступенчатой и двухступенчатой архитектур
|
Критерий |
Одноступенчатая архитектура |
Двухступенчатая архитектура |
Примечание |
|
Точность извлечения реквизитов (F1) |
0,74 |
0,89 |
500 документов |
|
Доля утверждений без документального основания |
18% |
2-4% |
экспертная оценка выборки пояснений |
|
Выявленные расхождения «план-документооборот» |
1-3 |
7 |
за период 2023-2025 гг. |
-
- время обработки: обработка 30 документов сократилась с 10 часов (ручной режим) до 4,6 часов (автоматизированный режим), что составляет снижение на 42%;
-
- качество анализа: количество ошибок и неточностей сократилось на 24% по сравнению с ручным режимом.
Таблица 3 – Сравнение ручного и автоматизированного режимов обработки
|
Критерий |
Ручной режим |
Автоматизированный режим |
Улучшение (%) |
|
Время обработки 30 док. |
10 часов |
5,8 часа |
42% |
|
Количество ошибок |
1 в каждом 10 док. |
1 в каждом 13.2 док. |
24% |
ОБСУЖДЕНИЕ РЕЗУЛЬТАТОВ
Полученные результаты подтверждают выдвинутую гипотезу исследования: двухступенчатый конвейер сокращает время сверки финансового плана на 42% (при пороговом значении 40%), а качество извлечения реквизитов (F1 = 0,89) превышает установленный порог 0,85. Общая точность классификации элементов разметки составила 94%, а распознавания текста – 92%, что подтверждает применимость выбранных архитектур к обработке финансовых документов предприятий малого и среднего бизнеса. Наименьшая точность достигнута на этапе нормализации реквизитов (85%), это связано с вариативностью форматов записи дат, денежных сумм и наименований контрагентов в документах различных организаций.
Сравнение с одноступенчатой архитектурой показало, что использование промежуточного структурированного представления повышает качество извлечения реквизитов (F1: 0,89 вместо 0,74) и обеспечивает документальную обоснованность формируемых аналитических выводов. Кроме того, предложенная архитектура способствует выявлению расхождений между финансовым планом и первичным документооборотом, которые не обнаруживаются при непосредственной передаче распознанного текста языковой модели.
Модульная организация конвейера создаёт возможность независимого развития отдельных компонентов системы. Замена MobileNetV2 на более современную архитектуру (например, EfficientNet) или обновление используемой языковой модели не требуют модификации остальных модулей, что упрощает сопровождение и последующую модернизацию системы.
ЗАКЛЮЧЕНИЕ
В работе предложена и реализована двухступенчатая архитектура системы интеллектуального анализа финансовых документов для автоматизации анализа исполнения финансового плана предприятий малого и среднего бизнеса. Архитектура объединяет свёрточную нейронную сеть для извлечения структурированных реквизитов из неструктурированных документов и большую языковую модель для выполнения план-факт анализа и формирования интерпретируемых аналитических рекомендаций.
Основные результаты работы:
-
1. Разработана модульная архитектура системы, обеспечивающая последовательную обработку финансовых документов и раздельную оценку качества каждого этапа обработки.
-
2. Разработан модуль извлечения реквизитов на основе MobileNetV2 и Tesseract OCR, обеспечивающий общую точность классификации элементов разметки 94% и точность распознавания текста 92%.
-
3. Разработан модуль план-факт анализа на основе большой языковой модели, реализующий расчёт финансовых показателей, формирование аналитических выводов и генерацию рекомендаций.
-
4. Проведено количественное сравнение двухступенчатой и одноступенчатой архитектур, показавшее повышение качества извлечения реквизитов (F1: 0,89 вместо 0,74), документальную обо-
- снованность аналитических выводов и возможность выявления расхождений между финансовым планом и первичным документооборотом.
Экспериментальная апробация на выборке из 500 документов, включавшем 100 реальных и 400 синтетически сгенерированных документов, подтвердила сокращение времени обработки на 42% и снижение количества ошибок на 24%.
Полученные результаты подтверждают эффективность предложенной двухступенчатой архитектуры для автоматизации анализа финансовых документов предприятий малого и среднего бизнеса в условиях ограниченных вычислительных и кадровых ресурсов.
Направления дальнейших исследований связаны с расширением перечня обрабатываемых документов, увеличением объёма обучающей выборки для повышения качества нормализации реквизитов, а также интеграцией механизмов обратной связи, обеспечивающих адаптацию языковой модели к особенностям документооборота конкретного предприятия.
