
Гибридная интеллектуальная система поддержки принятия решений на основе CatBoost, SHAP-анализа и нечёткой логики для оценки риска болезни Альцгеймера по клиническим данным
Рубрика: Информатика и вычислительная техника
Статья в выпуске: 3, 2026 года.
Бесплатный доступ
Растущая распространённость болезни Альцгеймера и ограниченная пропускная способность специализированной нейропсихологической диагностики делают востребованными автоматизированные инструменты предварительной оценки риска, пригодные для применения на этапе первичного амбулаторного скрининга. В работе предложена трёхэтапная гибридная модель, объединяющая градиентный бустинг CatBoost, метод объяснимого искусственного интеллекта SHAP и систему нечёткого вывода типа Мамдани. Классификатор обучен на структурированном наборе клинических, демографических, поведенческих и когнитивных показателей 2149 пациентов (32 признака после исключения идентификаторов) и на независимой тестовой выборке демонстрирует точность (accuracy) 0,9535, полноту 0,9276, F1-меру 0,9338 и площадь под ROC-кривой 0,9444. SHAP-анализ выявил выраженное доминирование показателей функциональной и когнитивной состоятельности (Functional Assessment, ADL, Memory Complaints, MMSE, Behavioral Problems) при пренебрежимо малом вкладе части клинико-лабораторных и поведенческих признаков, что в целом согласуется с клинической логикой формирования диагноза. На основе выходной вероятности классификатора и двух наиболее информативных функциональных признаков построен блок нечёткой поддержки решений, преобразующий точечную вероятностную оценку в трёхуровневую шкалу риска (низкий/средний/ высокий) с площадью под ROC-кривой 0,943, что обеспечивает интерпретируемость результата для врача при сохранении дискриминационной способности исходной модели. Показано, что сочетание точного, но малопрозрачного бустинга с прозрачным нечётким слоем формирует работоспособный компромисс между точностью и интерпретируемостью систем поддержки клинических решений.
Короткий адрес: https://sciup.org/148334285
IDS: 148334285 | УДК: 004.85:616.892.3 | DOI: 10.18137/RNU.V9187.26.03.P.183
A hybrid decision support system based on CatBoost, SHAP analysis, and fuzzy logic for Alzheimer’s disease risk assessment from clinical data
The growing prevalence of Alzheimer’s disease and the limited throughput of specialised neuropsychological diagnostics call for automated risk-screening tools suitable for primary outpatient use. This paper proposes a three-stage hybrid model combining Cat Boost gradient boosting, the SHAP explainable- AI method, and a Mamdani-type fuzzy inference system. The classifier was trained on a structured set of clinical, demographic, behavioural, and cognitive indicators for 2,149 patients (32 predictors after identifier removal) and, on an independent test set, achieves an accuracy of 0.9535, a recall of 0.9276, an F1-score of 0.9338, and a ROC-AUC of 0.9444. SHAP analysis revealed a pronounced dominance of functional and cognitive indicators (Functional Assessment, ADL, Memory Complaints, MMSE, Behavioral Problems), while several clinical-laboratory and lifestyle features contributed negligibly, which is broadly consistent with the clinical logic underlying the diagnosis. Using the classifier’s output probability together with the two most informative functional features, a fuzzy decision-support block was built that converts a point probability estimate into a three-level risk scale (low/medium/high) with a ROC-AUC of 0.943, providing an interpretable output for the clinician while preserving the discriminative power of the underlying model. The results show that combining an accurate but opaque boosting model with a transparent fuzzy layer offers a workable trade-off between accuracy and interpretability for clinical decision-support systems.
Текст научной статьи Гибридная интеллектуальная система поддержки принятия решений на основе CatBoost, SHAP-анализа и нечёткой логики для оценки риска болезни Альцгеймера по клиническим данным
Болезнь Альцгеймера остаётся ведущей причиной деменции у лиц старшего возраста и одной из наиболее ресурсоёмких проблем современного здравоохранения. Обновлённый доклад комиссии Lancet по профилактике, вмешательству и уходу при деменции подтверждает устойчивый рост числа пациентов на фоне старения населения и одновременно указывает на существенный потенциал ранней профилактики и своевременного вме-
Гибридная интеллектуальная система поддержки принятия решений на основе CatBoost, SHAP-анализа и нечёткой логики для оценки риска болезни Альцгеймера шательства при условии выявления риска на доклинических и ранних клинических стадиях [1]. Ключевым узким местом на этом пути остаётся ограниченная доступность специализированной нейропсихологической и нейровизуализационной диагностики, что делает востребованными недорогие, масштабируемые инструменты предварительной оценки риска, работающие на основе рутинно собираемых клинических, демографических и поведенческих данных.
В последние годы методы машинного обучения на структурированных (табличных) клинических данных заняли заметное место среди подходов к скринингу нейродегенера-тивных заболеваний как более доступная альтернатива моделям, требующим магнитнорезонансной томографии. Наряду с классическими инструментами когнитивной и функциональной оценки – краткой шкалой оценки психического статуса (MMSE) [3] и индексом повседневной активности (ADL) [4] – такие данные всё чаще дополняются десятками демографических, поведенческих и клинико-лабораторных признаков и используются для построения предиктивных моделей на подобных структурированных выборках [2].
Ансамблевые методы градиентного бустинга по деревьям решений, в частности XGBoost [7] и CatBoost [8], систематически демонстрируют на подобных задачах точность, сопоставимую или превосходящую классические линейные модели и случайный лес [6] за счёт эффективной обработки категориальных признаков и устойчивости к пропускам и разнородности данных. Вместе с тем высокая точность таких моделей достигается ценой снижения прозрачности: решение классификатора представляет собой результат агрегирования сотен неглубоких деревьев, что затрудняет его клиническую интерпретацию и, как следствие, доверие практикующего врача к автоматической рекомендации. Данное ограничение – одна из основных причин, по которым точные, но «чёрные» модели медленно внедряются в реальную клиническую практику, несмотря на убедительные результаты на бенчмарках.
Одним из наиболее распространённых способов преодоления этого ограничения является пост-хок-объяснение решений модели методом SHAP (SHapley Additive exPlanations), основанным на теоретико-игровом разложении вклада каждого признака в итоговый прогноз [9], либо локальными суррогатными объяснениями типа LIME [10]. SHAP-анализ уже применялся в ряде работ по диагностике и стадированию болезни Альцгеймера в сочетании с многослойными и мультимодальными моделями [13; 16]. Однако получаемое объяснение, как правило, остаётся вспомогательным аналитическим инструментом для разработчика модели и не всегда напрямую формирует клинически понятную шкалу риска для конечного пользователя.
Второе существенное ограничение классификаторов, обучаемых методом максимального правдоподобия, состоит в том, что их выход – точечная вероятность класса – плохо соответствует привычной для клинициста трёхуровневой логике триажа («низкий риск – требует наблюдения – требует немедленного дообследования»). Единственный порог отсечения (обычно 0,5) не учитывает степень уверенности модели вблизи границы решения и не позволяет явно выделить «серую зону» пациентов, нуждающихся в дополнительном внимании. Аппарат нечётких множеств [11] и систем нечёткого логического вывода типа Мамдани [12] исторически применяется в медицинских системах поддержки решений именно для того, чтобы формализовать подобные качественные градации и одновременно сгладить резкость порогового решения за счёт функций принадлежности с перекрытием.
Вестник Российского нового университета
Серия «Сложные системы: модели, анализ и управление». 2026. № 3
Ряд опубликованных работ уже сочетает объяснимый искусственный интеллект с моделями поддержки решений при болезни Альцгеймера: многослойная мультимодальная модель El-Sappagh с соавторами объединяет глубокое обучение с объяснением вклада признаков для диагностики и оценки прогрессирования заболевания [13]; систематический обзор Sarica с соавторами обобщает опыт применения случайного леса для анализа нейровизуализационных данных [14]; сравнительный анализ Bari Antor с соавторами сопоставляет классические алгоритмы машинного обучения на выборке OASIS [15], а работа Rahim с соавторами предлагает визуальное объяснение временной динамики прогрессирования заболевания для интеллектуальных систем здравоохранения [16]. Тем не менее в известных нам публикациях сочетание точного табличного градиентного бустин-га, глобального и локального SHAP-объяснения и последующего нечёткого блока, преобразующего вероятность и наиболее значимые функциональные признаки в клинически интерпретируемую трёхуровневую шкалу риска, применительно к структурированным (нетомографическим) клиническим данным болезни Альцгеймера остаётся малоизученным направлением.
Целью настоящего исследования является разработка и экспериментальная проверка гибридной интеллектуальной системы, объединяющей три взаимодополняющих компонента:
-
1) классификатор CatBoost для точного прогнозирования диагноза по структурированным клиническим данным;
-
2) SHAP-анализ для установления вклада отдельных признаков и содержательной интерпретации модели;
-
3) систему нечёткого вывода типа Мамдани, преобразующую выход классификатора и два наиболее значимых функциональных признака в трёхуровневую шкалу риска, пригодную для использования в качестве вспомогательного инструмента клинициста.
Для достижения цели решены следующие задачи:
-
• подготовлен и охарактеризован набор клинических данных;
-
• обучен и валидирован классификатор с настройкой гиперпараметров и ранней остановкой;
-
• выполнен глобальный SHAP-анализ значимости признаков;
-
• спроектирована и реализована система нечёткого вывода с резервным (fallback) механизмом, гарантирующим определённость выхода для любой комбинации входных значений;
-
• проведена комплексная оценка качества классификации и согласованности нечёткой шкалы риска с исходной вероятностной оценкой.
Материалы и методы
Характеристика набора данных . В исследовании использован открытый структурированный набор клинических данных по болезни Альцгеймера, включающий 2149 пациентов [2]. Из исходных 35 столбцов исключены неинформативные идентификаторы (PatientID, DoctorInCharge), что дало 32 предиктора и целевую переменную Diagnosis (0 – диагноз отсутствует, 1 – установлен диагноз болезни Альцгеймера). Распределение классов умеренно не сбалансировано: 1389 наблюдений (64,63 %) относятся к классу 0 и 760 наблюдений (35,37 %) – к классу 1.
Гибридная интеллектуальная система поддержки принятия решений на основе CatBoost, SHAP-анализа и нечёткой логики для оценки риска болезни Альцгеймера
Признаковое пространство образуют две группы.
Первая – 17 категориальных (преимущественно бинарных) признаков: демографические (Gender, Ethnicity, Education Level), факторы риска и коморбидность (Smoking, Family History Alzheimers, Cardiovascular Disease, Diabetes, Depression, HeadInjury, Hypertension), а также клинические симптомы когнитивного и поведенческого снижения (Memory Complaints, Behavioral Problems, Confusion, Disorientation, Personality Changes, Difficulty Completing Tasks, Forgetfulness).
Вторая – 15 числовых признаков: возраст, индекс массы тела, показатели образа жизни (Alcohol Consumption, Physical Activity, Diet Quality, Sleep Quality), гемодинамические и биохимические показатели (Systolic BP, Diastolic BP, Cholesterol Total, Cholesterol LDL, Cholesterol HDL, Cholesterol Triglycerides), а также три показателя, напрямую отражающих когнитивный и функциональный статус пациента: результат краткой шкалы оценки психического статуса MMSE [3], интегральная оценка функциональной состоятельности Functional Assessment и индекс повседневной активности ADL, методологически восходящий к классическому индексу Katz [4].
Необходимо отметить методологическое ограничение используемого набора данных. Он представляет собой структурированный клинический датасет, подготовленный для задач машинного обучения, а не проспективно собранную когорту многоцентрового наблюдения (в отличие, например, от визуализационной выборки OASIS [5], также применяемой авторами в смежных исследованиях). Это обстоятельство учтено при интерпретации результатов SHAP-анализа в разделе «Результаты исследования» и обозначено как направление последующей внешней валидации в разделе «Обсуждение результатов исследования».
Архитектура гибридной модели . Предлагаемая система реализована в виде последовательности из трёх этапов.
Этап 1. Обучение классификатора CatBoost. Выборка разделена на обучающую, вали-дационную и тестовую части в стратифицированном по целевой переменной соотношении 1375 / 344 / 430 наблюдений (64 / 16 / 20 %). Классификатор CatBoost Classifier обучен с параметрами: iterations = 2000, learning_rate = 0,03, depth = 6, loss_function = Logloss, eval_metric = AUC, class_weights = [1,0; 1,5] (компенсация дисбаланса классов), random_seed = 42, early_stopping_rounds = 100. Выбор Cat Boost обусловлен реализованным в нём механизмом упорядоченного бустинга (ordered boosting), снижающим целевую утечку (target leakage) при обработке категориальных признаков без их явного кодирования [8], что отличает его от более традиционного XG Boost [7]. Обучение остановлено детектором переобучения на 28-й итерации из 2000 запланированных при значении AUC на валидационной выборке 0,9552, что свидетельствует о быстрой сходимости модели и отсутствии необходимости в глубоком ансамбле для данной задачи.
Этап 2. Объяснение модели методом SHAP. Для обученного классификатора построен объяснитель Tree Explainer библиотеки SHAP [9], вычисляющий значения Шепли для каждого наблюдения тестовой выборки (430 наблюдений × 32 признака). На основе абсолютных средних значений SHAP (mean |SHAP value|) сформирован глобальный рейтинг значимости признаков, дополненный локальной диаграммой распределения вкладов (summary plot), позволяющей одновременно оценить знак и величину влияния каждого признака. Такой подход, в отличие от локальных суррогатных объяснений LIME [10], обеспечивает согласованное на уровне всей выборки (глобальное) и одновременно интерпретируемое на уровне отдельного пациента (локальное) объяснение прогноза.
Вестник Российского нового университета
Серия «Сложные системы: модели, анализ и управление». 2026. № 3
Этап 3. Нечёткий блок поддержки решений. По результатам SHAP-анализа два признака – Functional Assessment и ADL – определены как наиболее информативные функциональные показатели (после доминирующего вклада которых значимость резко падает – см. раздел «Результаты исследования»). На их основе совместно с выходной вероятностью классификатора CatBoost (P) построена система нечёткого логического вывода типа Мам-дани [12] средствами библиотеки scikit-fuzzy. Для входной переменной P заданы трапециевидные функции принадлежности термов «низкая», «средняя» и «высокая» с опорными точками [0; 0; 0,20; 0,45], [0,30; 0,45; 0,55; 0,70] и [0,55; 0,80; 1,00; 1,00] соответственно. Для входных переменных Functional Assessment и ADL границы термов заданы адаптивно, по 20, 50 и 80-му процентилям их эмпирического распределения на тестовой выборке, что делает функции принадлежности устойчивыми к масштабу конкретной выборки. Выходная переменная RISK построена симметрично переменной P. База правил включает десять продукционных правил Мамдани: основные правила связывают сочетания высокой/средней/ низкой вероятности P с состоянием функциональных признаков (например, «если P высокая и хотя бы один из FA, ADL низкий, то риск высокий»), а три резервных (fallback) правила однозначно определяют выход RISK по одной лишь переменной P в случаях, когда сочетание входных термов не покрывается основными правилами. Такой резервный механизм – практически значимая деталь инженерной реализации, гарантирующая определённость дефаззифицированного выхода для любой допустимой комбинации входов и повышающая устойчивость системы при развёртывании на новых данных. По результатам дефаззифика-ции каждому пациенту присваивается непрерывная оценка риска risk_score ∈ [0; 1] и категориальный уровень риска: «низкий» при risk_score < 0,4, «средний» при 0,4 ≤ risk_score < 0,7 и «высокий» при risk_score ≥ 0,7; дополнительно вычислена мера уверенности confidence = |risk_score - 0,5| × 2.
Качество классификации на тестовой выборке оценивалось стандартным набором метрик: accuracy, precision, recall, F1-мера, площадь под ROC-кривой (AUC) и матрица ошибок; согласованность нечёткой шкалы риска с исходной вероятностной оценкой Cat Boost оценивалась путём сопоставления значений AUC для обеих величин относительно истинной метки диагноза.
Результаты исследования
Итоговое качество классификатора CatBoost на независимой тестовой выборке (430 наблюдений) представлено в Таблице 1. ROC-кривая классификатора CatBoost на тестовой выборке AUC = 0,944 представлена на Рисунке 1.
Таблица 1
Метрики качества классификации CatBoost на тестовой выборке
|
Метрика |
Значение |
|
Accuracy |
0,9535 |
|
Precision |
0,9400 |
|
Recall |
0,9276 |
|
F1-мера |
0,9338 |
|
ROC-AUC |
0,9444 |
Источник: здесь и далее таблицы составлены авторами по результатам исследования
Гибридная интеллектуальная система поддержки принятия решений на основе CatBoost, SHAP-анализа и нечёткой логики для оценки риска болезни Альцгеймера
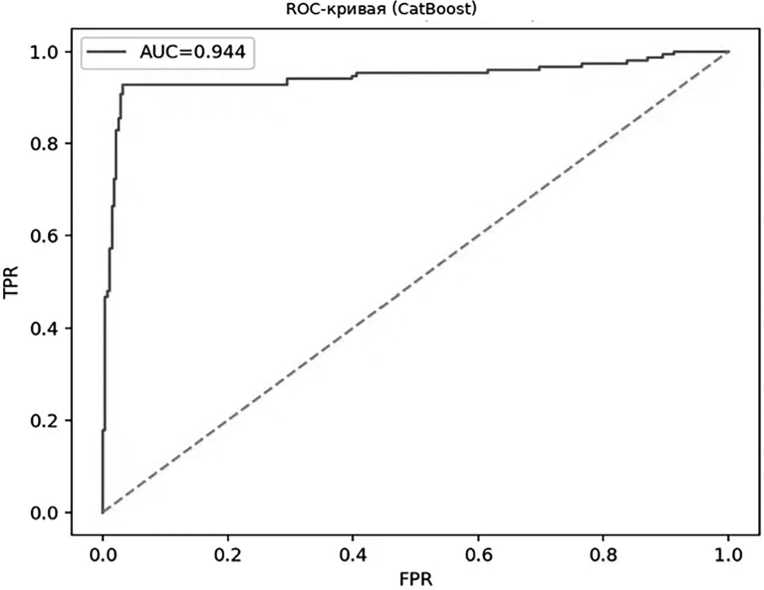
Рисунок 1. ROC-кривая классификатора CatBoost на тестовой выборке ( AUC = 0,944) Источник: здесь и далее рисунки выполнены авторами по результатам исследования
Матрица ошибок (Рисунок 2) подтверждает высокую сбалансированность результата по обоим классам: из 278 пациентов класса 0 верно классифицированы 269 (ложноположительных 9), из 152 пациентов класса 1 верно классифицированы 141 (ложноотрицательных 11). Детализация по классам приведена в Таблице 2.
Матрица ошибок (CatBoost)
о 1
Предсказанный класс
Рисунок 2. Матрица ошибок классификатора CatBoost на тестовой выборке
Вестник Российского нового университета
Серия «Сложные системы: модели, анализ и управление». 2026. № 3
Таблица 2
Метрики классификации по классам (CatBoost, тестовая выборка)
|
Класс |
Precision |
Recall |
F1-мера |
Число наблюдений |
|
0 (диагноз отсутствует) |
0,9607 |
0,9676 |
0,9642 |
278 |
|
1 (болезнь Альцгеймера) |
0,9400 |
0,9276 |
0,9338 |
152 |
|
Macro avg |
0,9504 |
0,9476 |
0,9490 |
430 |
|
Weighted avg |
0,9534 |
0,9535 |
0,9534 |
430 |
Обучение было остановлено детектором переобучения на 28-й итерации из 2000 запланированных, при этом значение AUC на валидационной выборке (0,9552) практически совпадает со значением AUC на независимой тестовой выборке (0,9444). Близость валидационной и тестовой метрик указывает на отсутствие переобучения модели и на устойчивость выбранной конфигурации гиперпараметров.
Глобальный SHAP-анализ выявил чёткую иерархию значимости признаков (Таблица 3, Рисунки 3, 4): пять первых по значимости признаков – Functional Assessment, ADL, Memory Complaints, MMSE и Behavioral Problems – суммарно определяют подавляющую часть вклада в решение модели, тогда как вклад следующих по рейтингу признаков (Cholesterol LDL, Systolic BP, Education Level, Diet Quality, Physical Activity) на один-два порядка меньше.
Таблица 3
Топ-10 признаков по среднему абсолютному значению SHAP (mean |SHAP value|)
|
№ |
Признак |
mean |SHAP value| |
|
1 |
Functional Assessment |
0,6233 |
|
2 |
ADL |
0,6080 |
|
3 |
Memory Complaints |
0,4628 |
|
4 |
MMSE |
0,4481 |
|
5 |
Behavioral Problems |
0,3079 |
|
6 |
Cholesterol LDL |
0,0151 |
|
7 |
Systolic BP |
0,0116 |
|
8 |
Education Level |
0,0072 |
|
9 |
Diet Quality |
0,0064 |
|
10 |
Physical Activity |
0,0064 |
Диаграмма распределения значений SHAP (Рисунок 3) показывает, что низкие значения Functional Assessment и ADL, а также высокие значения Memory Complaints и Behavioral Problems систематически смещают прогноз модели в сторону положительного диагноза, что содержательно ожидаемо: перечисленные признаки напрямую отражают функциональную независимость и выраженность когнитивно-поведенческих нарушений и по сути формализуют клинические критерии, на которые опирается сама постановка диагноза. Данное наблюдение следует интерпретировать с осторожностью: выраженное доминирование именно этих признаков может частично отражать не только их подлинную клиническую значимость, но и особенности формирования целевой переменной в структурированном наборе данных, что обозначено как ограничение исследования и требует проверки на независимой проспективной выборке.
Гибридная интеллектуальная система поддержки принятия решений на основе CatBoost, SHAP-анализа и нечёткой логики для оценки риска болезни Альцгеймера
Диаграмма SHAP (топ-10 признаков)
FunctionalAssessment
ADL
MemoryComplaints
MMSE
BehavioralProblems
CholesterolLDL
SystolicBP
EducationLevel
DietQuality
Physica (Activity
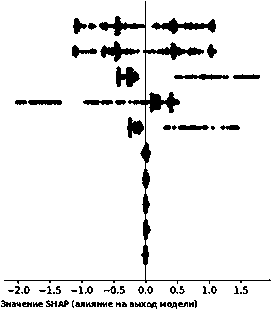
Рисунок 3. Диаграмма SHAP – распределение вкладов топ-10 признаков
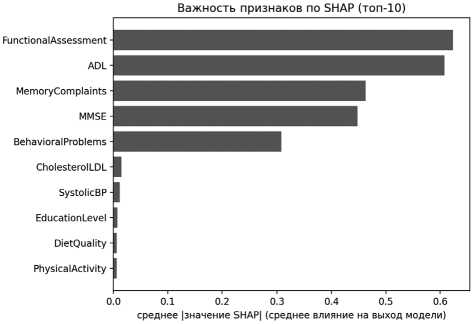
Рисунок 4. Важность признаков по SHAP – среднее |значение SHAP| для топ-10 признаков
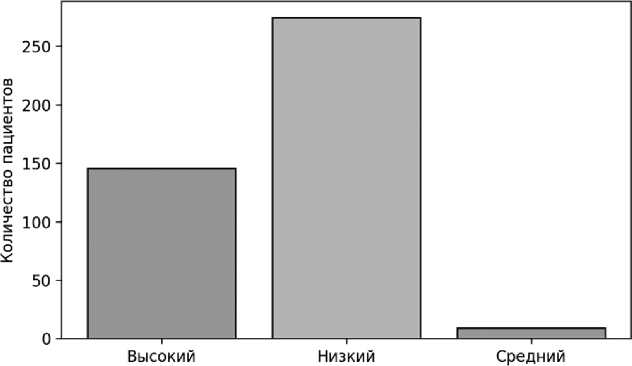
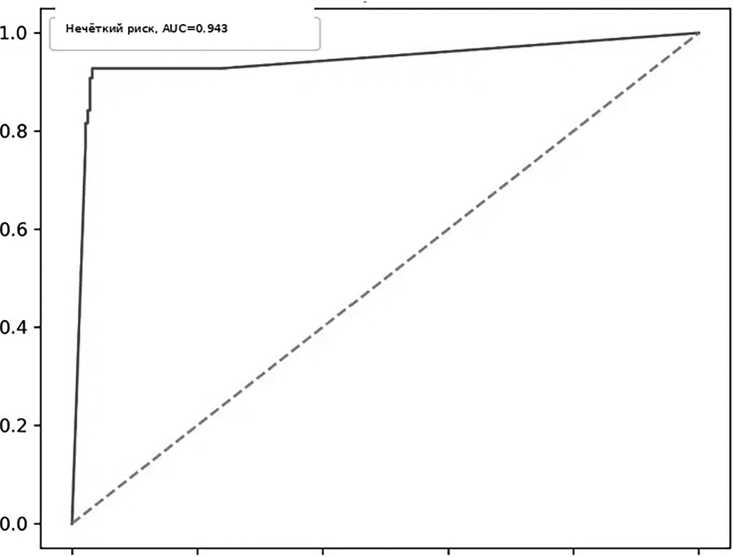
Результаты работы нечёткого блока поддержки решений приведены в Таблице 4 и на Рисунке 6. Площадь под ROC-кривой для непрерывной нечёткой оценки риска составила 0,943 – практически идентична AUC исходной вероятности Cat Boost (0,9444), что подтверждает, что преобразование в нечёткую шкалу не приводит к потере дискриминационной способности модели, при этом обеспечивая клинически интерпретируемую трёхуровневую градацию вместо точечной вероятности.
Таблица 4
Распределение пациентов тестовой выборки по уровням нечёткого риска
|
Уровень риска |
Число пациентов |
Доля, % |
|
Низкий (Low) |
275 |
63,95 |
|
Средний (Medium) |
9 |
2,09 |
|
Высокий (High) |
146 |
33,95 |
|
Итого |
430 |
100,00 |
Вестник Российского нового университета
Серия «Сложные системы: модели, анализ и управление». 2026. № 3
Распределение уровней риска (нечёткая модель)
Уровень риска
Рисунок 5. Распределение пациентов тестовой выборки по уровням нечёткого риска
Полученное распределение имеет выраженный бимодальный характер с крайне малой долей пациентов в промежуточной («серой») зоне. С одной стороны, это отражает достаточно резкую границу решения исходного классификатора Cat Boost и означает, что для подавляющего большинства пациентов система выдаёт уверенную, не двусмысленную рекомендацию. С другой стороны, столь малая доля среднего уровня риска (около 2 %) указывает на потенциальный резерв для дальнейшей настройки границ функций принадлежности нечёткого блока: возможно, часть пациентов, реально находящихся в зоне диагностической неопределённости, в текущей конфигурации системы преждевременно относится к категории «высокий» или «низкий» риск. Это обстоятельство обсуждается в следующем разделе как одно из направлений дальнейшего совершенствования модели.
ROC-кривая нечёткой оценки риска
0.0 0.2 0.4 0.6 0.8 1.0
FPR
Рисунок 6. ROC-кривая нечёткой оценки риска (AUC = 0,943)
Гибридная интеллектуальная система поддержки принятия решений на основе CatBoost, SHAP-анализа и нечёткой логики для оценки риска болезни Альцгеймера
Обсуждение результатов исследования
Полученные результаты подтверждают, что для рассматриваемой задачи классификации болезни Альцгеймера по структурированным клиническим данным ансамблевый градиентный бустинг CatBoost обеспечивает точность и площадь под ROC-кривой, сопоставимые с лучшими результатами, представленными в литературе для аналогичных табличных выборок [15; 17], при этом достигается быстрая сходимость модели (оптимум на 28-й итерации) без признаков переобучения.
Ключевой вклад настоящей работы состоит не столько в самой точности классификации, сколько в архитектурном решении, последовательно объединяющем три взаимодополняющих слоя: точный, но малопрозрачный классификатор; глобальную и локальную интерпретацию его решений методом SHAP и нечёткий блок, преобразующий числовую вероятность в клинически понятную трёхуровневую шкалу риска. В отличие от работ, ограничивающихся исключительно объяснением вклада признаков без последующей трансформации выхода в шкалу, пригодную для непосредственного клинического использования [13; 16], предложенная система явно решает задачу перехода от «модели для инженера» к «рекомендации для врача». В отличие от классических систем нечёткого вывода, полностью заменяющих статистическую модель [12], в данной работе нечёткий слой используется как надстройка над обученным классификатором, что позволяет сохранить его дискриминационную способность (AUC 0,943 против 0,9444 у базовой модели) при одновременном выигрыше в интерпретируемости результата.
Отдельного внимания заслуживает инженерное решение с резервными (fallback) правилами нечёткого вывода. В прикладных системах поддержки принятия решений на основе нечёткой логики нередко возникают комбинации входных значений, не покрываемые основной базой правил, что приводит к неопределённому (NaN) выходу дефаззифика-ции. Введение резервных правил, однозначно определяющих уровень риска по вероятности классификатора при неполном покрытии основной базы правил, устраняет эту уязвимость и делает систему пригодной для развёртывания на новых, заранее не предусмотренных комбинациях признаков, что имеет практическое значение, зачастую остающееся за рамками публикаций, посвящённых исключительно точности моделей.
Результаты SHAP-анализа согласуются с общей тенденцией, отмечаемой в систематическом обзоре применения методов машинного обучения к нейродегенеративным заболеваниям [14]: показатели прямой функциональной и когнитивной оценки (MMSE, ADL, интегральные функциональные шкалы) стабильно оказываются наиболее информативными предикторами, тогда как вклад демографических и части клинико-лабораторных показателей носит вспомогательный характер. Одновременно данное наблюдение указывает на ограничение используемого набора данных: сильная корреляция целевой переменной именно с показателями, которые сами являются частью клинического определения когнитивного снижения, создаёт риск определённой циркулярности при валидации модели исключительно на данном датасете. Это обстоятельство ограничивает прямой перенос количественных результатов на независимые проспективные когорты без дополнительной валидации.
К ограничениям исследования также следует отнести:
-
• однократное разбиение выборки на обучающую/валидационную/тестовую части без перекрёстной проверки (что подлежит уточнению в последующих работах);
Вестник Российского нового университета
Серия «Сложные системы: модели, анализ и управление». 2026. № 3
-
• отсутствие внешней валидации на независимом наборе данных;
-
• ручную (процентильную) настройку функций принадлежности нечёткого блока в отличие от применяемой авторами в смежном визуализационном пайплайне процедуры PSO-оптимизации параметров функций принадлежности, что является естественным направлением дальнейшего развития настоящей модели.
Перспективным направлением дальнейшего исследования представляется интеграция предложенного табличного блока с ранее разработанной авторами визуализационной моделью на основе свёрточных признаков и кластерного анализа [5] в единую мультимодальную систему, комбинирующую структурированные клинические данные и данные магнитно-резонансной томографии для повышения надёжности ранней диагностики.
Заключение
В работе предложена и экспериментально проверена трёхэтапная гибридная модель для оценки риска болезни Альцгеймера по структурированным клиническим данным, объединяющая градиентный бустинг CatBoost, объяснение решений методом SHAP и нечёткий блок поддержки решений типа Мамдани. Классификатор достиг на независимой тестовой выборке точности 0,9535 и площади под ROC-кривой 0,9444 при быстрой и устойчивой сходимости обучения. SHAP-анализ выявил доминирующий вклад показателей функциональной и когнитивной состоятельности пациента (Functional Assessment, ADL, Memory Complaints, MMSE, Behavioral Problems) и позволил обоснованно отобрать признаки для последующего нечёткого блока. Построенная система нечёткого вывода преобразует вероятностный выход классификатора в трёхуровневую, клинически интерпретируемую шкалу риска, практически не теряя в дискриминационной способности (AUC 0,943), и снабжена резервным механизмом правил, обеспечивающим определённость результата для любой комбинации входных данных.
Предложенный подход может рассматриваться как прототип вспомогательного инструмента предварительного скрининга риска болезни Альцгеймера на этапе первичного амбулаторного приёма, дополняющего, но не заменяющего заключение специалиста.
Направлениями дальнейшей работы являются: внешняя валидация модели на независимых клинических когортах; метаэвристическая (PSO/генетическая) оптимизация параметров функций принадлежности нечёткого блока для более точной калибровки промежуточной зоны риска, а также интеграция предложенной табличной модели с визуали-зационным пайплайном на основе МРТ-данных в рамках единой мультимодальной системы поддержки диагностики нейродегенеративных заболеваний.
