
Гибридный алгоритм автоматизированного подбора моделей и датасетов на основе деревьев решений и больших языковых моделей AIONet
Журнал: Инфокоммуникационные технологии @ikt-psuti
Рубрика: Новые информационные технологии
Статья в выпуске: 1 (93) т.24, 2026 года.
Бесплатный доступ
В статье рассматривается адаптивный алгоритм автоматизированного подбора и обучения моделей машинного обучения AIONet (Adaptive Intelligent Optimization Network), основанный на интеграции методов деревьев решений и больших языковых моделей (LLM). Проводится сравнительный анализ возможностей классического алгоритма дерева решений и современных LLM в задаче поиска подходящих моделей и датасетов для автоматизированного обучения нейронных сетей. Формулируется гипотеза о том, что объединение дерева решений как структуры первичного логического отбора и LLM как контекстно-зависимого интеллектуального модуля позволяет повысить точность и эффективность выбора моделей и наборов данных по сравнению с использованием каждого подхода по отдельности. Представлены ключевые особенности функционирования алгоритма AIONet, а также его потенциал для применения в системах автоматизации машинного обучения.
Короткий адрес: https://sciup.org/140316414
IDS: 140316414 | УДК: 004.85 | DOI: 10.18469/ikt.2026.24.1.05
AIONet: A hybrid algorithm for automated model and dataset selection based on decision trees and large language models
The article examines an adaptive algorithm for automated selection and training of machine learning models, AIONet (Adaptive Intelligent Optimization Network), based on the integration of decision tree methods and large language models (LLMs). A comparative analysis is conducted of the capabilities of classical decision tree algorithms and modern LLMs in the task of identifying suitable models and datasets for automated neural network training. A hypothesis is formulated that combining a decision tree as a structure for primary logical selection with an LLM as a context-dependent intelligent module can improve the accuracy and efficiency of model and dataset selection compared to using each approach independently. The key features of the AIONet algorithm’s operation are presented, as well as its potential for application in automated machine learning systems.
Текст научной статьи Гибридный алгоритм автоматизированного подбора моделей и датасетов на основе деревьев решений и больших языковых моделей AIONet
Современные системы машинного обучения предъявляют высокие требования к автоматизации процессов выбора моделей, конфигураций и наборов данных. Пользователи – как начинающие разработчики, так и исследователи – сталкиваются с проблемой выбора из сотен архитектур, десятков тысяч датасетов и множества стратегий обучения. Это усложняется тем, что оптимальный выбор зависит от типа задачи, объёма данных, доступных вычислительных ресурсов и требований к точности или времени работы модели.
Классические методы, такие как деревья решений, обеспечивают интерпретируемые и простые в реализации механизмы выбора. Однако их способность учитывать сложные взаимосвязи и динамический контекст задачи ограничена [1, 2]. С другой стороны, современные языковые модели (LLM), обученные на огромных корпусах данных, обладают развитой способностью к анализу, обобщению и формированию рекомендаций, однако требуют структуризации входных условий и могут допускать вариативность выводов без внешней логики [3, 4, 5].
В связи с этим возникает необходимость в алгоритме, который объединяет логическую строгость дерева решений и адаптивность LLM. Такой подход реализуется в проектируемом алгоритме AIONet (Adaptive Intelligent Optimization
Network), который обеспечивает автоматизированный подбор моделей и датасетов, прогнозирование параметров обучения, анализ метрик и генерацию рекомендаций [6].
Одной из ключевых задач является исследование того, каким образом дерево решений и LLM могут применяться как отдельные компоненты системы выбора, и как их объединение может обеспечить более высокое качество итоговых рекомендаций [6, 22, 23].
Принцип работы алгоритма «дерево решений» и его роль в подборе моделей
Алгоритм дерева решений относится к числу классических методов машинного обучения и представляет собой структуру, основанную на иерархическом разбиении исходных данных. В процессе построения дерева на каждом узле выбирается признак, который наилучшим образом разделяет обучающую выборку по заданному критерию – например, по информации, энтропии или индексу Джини [1, 3, 7, 8]. Такое разбиение продолжается до тех пор, пока не достигаются заданные условия остановки, например минимальная глубина дерева или отсутствие значимого улучшения качества классификации.
Результатом работы алгоритма является дерево, каждая ветвь которого соответствует набору логических правил, приводящих к определённому
классу или значению на выходе. Деревья решений обладают высокой интерпретируемостью и наглядностью, но ограничены в способности обрабатывать сложные нелинейные зависимости и большие объёмы высокоразмерных данных [9, 10, 11].
Хотя дерево решений обычно применяют для классификации или регрессии, его можно адаптировать для помощи пользователю в выборе модели и набора данных [7]. Принцип следующий:
Алгоритм дерева решений строится на основе правил выбора, определяемых по заранее собранной информации о типах задач, данных и моделях (рис. 1). Каждый узел дерева задаёт вопрос, уточняющий условия использования модели. Например, система может работать так:
На вход подаются характеристики задачи, заданные пользователем: тип данных (изображения, текст, табличные данные), цель обучения (классификация, регрессия, сегментация), желаемая скорость или точность.
Дерево решений последовательно уточняет эти параметры, задавая вопросы вроде:
-
• «Данные изображений или текстовые?»
-
• «Есть ли размеченный датасет?»
-
• «Необходима ли работа в реальном времени?»
Каждая ветвь дерева ведёт к предложению подходящей архитектуры нейросети и набора данных. Например:
-
• Если изображения и есть разметка → предложить модели семейства YOLO или EfficientNet, и датасеты вроде COCO, ImageNet.
-
• Если текстовые данные → предложить BERT, GPT или DistilBERT с датасетами SQuAD, AG News.
-
• Если данных мало → предложить дообучение готовой модели (transfer learning).
На основе выбранных листьев дерева можно автоматически сформировать запросы к API (Hugging Face, Kaggle) и загрузить подходящие модели или датасеты.
Дерево решений выполняет роль логического фильтра, который помогает пользователю без глубоких знаний в ML подобрать подходящие компоненты. Это не интеллектуальная система в строгом смысле, но она обеспечивает простую и объяснимую логику выбора, которую затем можно сравнить с более сложным поведением адаптивного алгоритма AIONet.
Роль LLM в системе подбора
Большие языковые модели (LLM) в архитектуре AIONet выполняют функцию интеллектуального адаптивного анализа, дополняя детерминированную структуру дерева решений. Их основная роль заключается в обработке неформализованных, семантически насыщенных описаний задач и моделей, а также в динамическом уточнении требований к процессу обучения. В отличие от фиксированных правил дерева решений, LLM способны интерпретировать контекст задачи, обобщать сведения из разнородных источников и формировать рекомендации, выходящие за рамки заранее определённых структур [12, 13, 14].
Во-первых, LLM обеспечивают гибкость при работе с естественно-языковыми запросами пользователя. Это позволяет системе принимать описание задачи в свободной форме – например, формулировку цели обучения, специфику данных или ожидаемые качества итоговой модели – и преобразовывать его в структурированные параметры, необходимые для дальнейшего выбора моделей и датасетов.
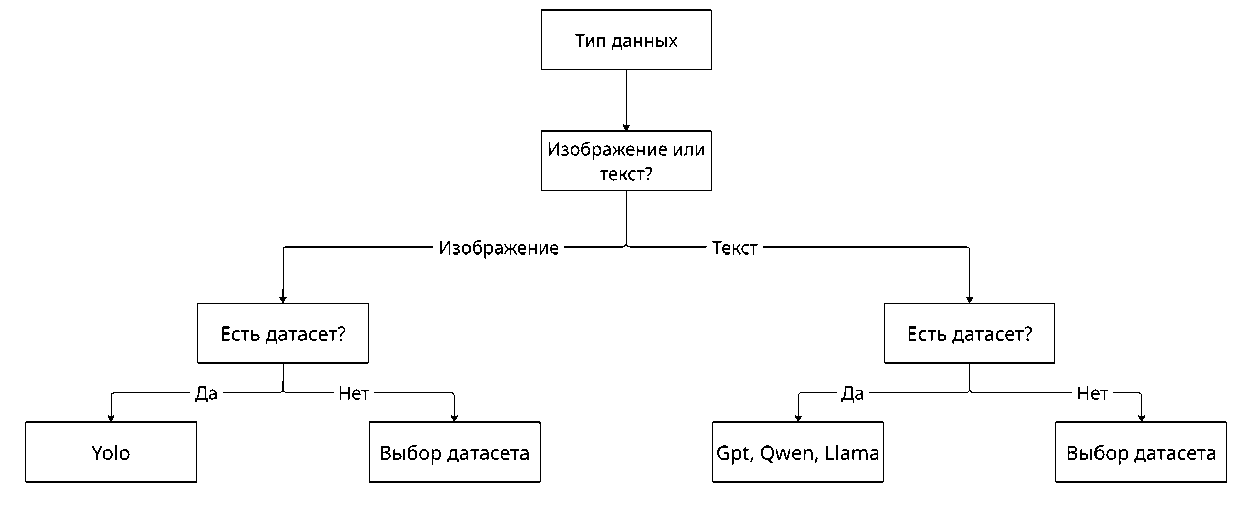
Рисунок 1. Примерный вид варианта решения задачи с использованием дерева решений
Во-вторых, LLM участвуют в формировании гиперпараметров и оптимизационных стратегий. Используя контекст, модель способна предложить комбинации настроек, учитывающие размер выборки, степень шумности данных, требования к вычислительным ресурсам и ограничения по времени обучения. Такие рекомендации динамически корректируются по мере получения промежуточных метрик [15, 16].
В-третьих, LLM позволяют осуществлять интеллектуальный поиск внешних ресурсов. На основе описания задачи они сопоставляют характеристики различных архитектур и датасетов, выполняют семантическое сопоставление описаний, анализируют лицензии, версии, формат данных и предлагают наиболее релевантные варианты. Это особенно важно в условиях большого количества доступных моделей и выборок, когда детерминированной структуры фильтрации недостаточно [5, 17, 18].
Наконец, LLM играют ключевую роль в аналитическом этапе. Они участвуют в интерпретации метрик, выявлении возможных причин ухудшения качества, формировании рекомендаций по улучшению модели и прогнозировании поведения при дальнейшем обучении [19]. В совокупности это делает LLM центральным элементом адаптивного контура AIONet: дерево решений определяет структурные ограничения и базовые варианты выбора, в то время как LLM обеспечивает гибкость, глубину анализа и способность учитывать сложные взаимосвязи.
Сравнительный анализ дерева решений и модели LLM
Дерево решений и большие языковые модели представляют два принципиально разных подхода к обработке информации и принятию решений. Их сравнение позволяет выявить ограничения классических методов, преимущества адаптивных моделей и обосновать необходимость гибридного алгоритма, подобного AIONet [20].
Однако такой подход обладает слабой адаптивностью. Дерево не способно учитывать сложные взаимосвязи между параметрами, не умеет анализировать неоднородные описания моделей, не использует скрытые закономерности внутри да-тасетов и не адаптируется к новым данным без ручного изменения структуры. Как следствие, при сложных задачах, включающих многокритериальный поиск, неопределённые требования или работу с естественно-языковыми запросами, дерево решений демонстрирует ограниченную гибкость.
Большие языковые модели работают иначе. LLM способны анализировать текстовые описания моделей, автоматически выявлять релевантные признаки, сопоставлять параметры датасетов, учитывать метрики, лицензии и историю использования. LLM не ограничена фиксированной структурой правил, поэтому может формировать динамические стратегии поиска: например, комбинировать данные из нескольких источников, предлагать альтернативные датасеты или корректировать план обучения в зависимости от целей пользователя [4, 20]. В отличие от дерева решений, LLM сохраняет контекст в рамках одной сессии (контекст), что позволяет ей уточнять запросы, формировать рекомендации по улучшению качества обучения и прогнозировать результаты.
Тем не менее LLM обладает низкой интерпретируемостью, может давать вариативные ответы и требует дополнительных механизмов контроля качества. Она не всегда способна самостоятельно формировать детерминированные фильтры, особенно при большом количестве структурированных параметров. Поэтому LLM хорошо решает задачи адаптивного выбора и анализа, но хуже подходит для жёсткого отсечения неподходящих вариантов, где требуется фиксированная логика.
Сравнение этих подходов показывает, что дерево решений обеспечивает структурированность и предсказуемость, а LLM – гибкость, адаптивность и семантическое понимание. В условиях задачи автоматического подбора моделей и дата-сетов для обучения нейросетей ни один метод сам по себе не является достаточным. Дерево решений эффективно выполняет первичное структурное ранжирование, а LLM дополняет его глубоким поиском и контекстуальной адаптацией. На этом сочетании и строится гипотеза жизнеспособности AIONet как гибридного алгоритма, объединяющего строгость классических методов и интеллектуальность нейросетевых моделей.
Принцип работы проектируемого алгоритма AIONet
Проектируемый алгоритм AIONet представляет собой гибридную интеллектуальную систему, предназначенную для автоматизации процессов подготовки, обучения и последующего анализа моделей машинного обучения. Алгоритм интегрирует два взаимодополняющих подхода – детерминированное дерево решений и адаптивную языковую модель (LLM), что обеспечивает сочетание строгих правил фильтрации и гибкой контекстно-зависимой оптимизации. Такая архитектура позволяет формализовать выбор подходящих моделей и датасетов, адаптировать стратегию обучения и обеспечивать интерпретируемость результатов.
Общая архитектура.
Алгоритм AIONet функционирует как промежуточное звено между пользователем, вычислительной инфраструктурой и внешними источниками данных (рис. 2). Его архитектура включает четыре ключевых компонента:
Модуль первичного анализа (Decision Tree Selector).
Выполняет детерминированный отбор совместимых моделей, датасетов и библиотек, используя заранее определённые критерии: домен задачи, тип данных, формат входов/выходов, использование GPU, размеры датасета, ограничения по ресурсам и др.
Модуль адаптивного анализа (LLM Optimizer).
Использует встроенную или локально подключаемую LLM для:
-
• уточнения задачи;
-
• выбора гиперпараметров;
-
• прогноза времени обучения;
-
• генерации рекомендаций по стратегии оптимизации;
-
• анализа промежуточных результатов.
Модуль итогового анализа (Result Analyzer).
Формирует отчёт, визуализирует статистику, интерпретирует поведение модели и делает выводы о её устойчивости, качестве обобщения и пригодности к задаче.
Этапы функционирования алгоритма
Функционирование алгоритма AIONet представляет собой последовательный процесс, включающий подготовку входных данных, интеллектуальный подбор конфигурации обучения, выполнение тренировочного цикла и последующий аналитический разбор полученных результатов.
На начальном этапе пользователь взаимодействует с системой посредством веб-интерфейса, загружая собственную модель в формате .py и файл requirements.txt либо выбирая одну из внешних моделей, доступных через платформы Hugging Face или аналогичные источники. Аналогичным образом осуществляется работа с датасетами: пользователь может предоставить собственную размеченную выборку либо инициировать поиск внешних наборов данных через API Kaggle или Hugging Face. На этом же этапе выполняется автоматическая проверка совместимости библиотек, корректности формата данных и базовой синтаксической целостности загруженного кода.
После получения входной информации активируются интеллектуальные модули алгоритма. Первичная фильтрация выполняется с помощью структурированной логики, основанной на дереве решений, которое обеспечивает:
-
• классификацию задачи (например, обработка изображений, текста или табличных данных);
-
• предварительный отбор потенциально совместимых моделей и датасетов;
-
• проверку ограничений, связанных с размером данных, архитектурой модели или вычислительным бюджетом.
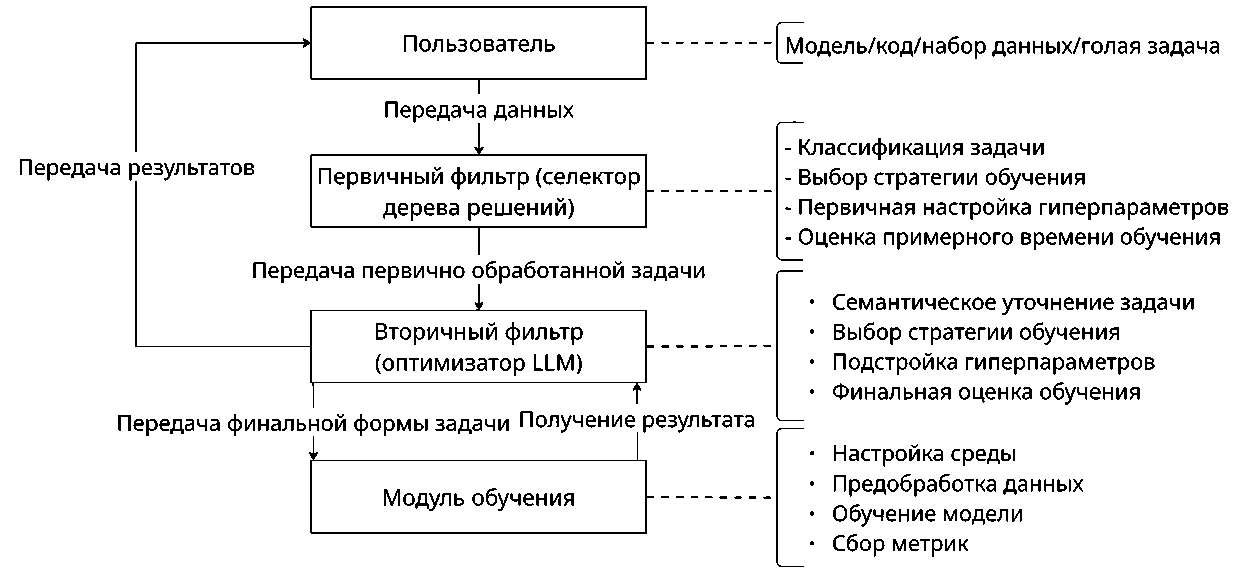
Рисунок 2. Примерный вид варианта решения задачи с использованием дерева решений
На следующем этапе подключается языковая модель (LLM), отвечающая за адаптивную интерпретацию контекста. Она уточняет семантику задачи пользователя, формирует рекомендации по стратегии обучения и выбору гиперпараметров, а также оценивает предполагаемую длительность и сложность последующего тренировочного процесса. В отличие от дерева решений, LLM сохраняет контекст в рамках одной сессии, что позволяет ей корректировать рекомендации в зависимости от промежуточных результатов [4].
Процесс обучения включает подготовку среды, автоматизированную предобработку данных, запуск тренировочного конвейера и сбор метрик. На данном этапе фиксируются динамика значений функции потерь и точности, поведение модели на валидационной выборке, скорость сходимости и использование вычислительных ресурсов и временные затраты. Эти результаты также анализируются модулем LLM для последующего «объяснения» пользователю.
Завершающий этап представляет собой аналитическую обработку собранных данных. AIONet формирует структурированный отчёт, включающий визуализацию метрик, текстовую интерпретацию результатов, выявление потенциальных узких мест и оценку устойчивости обученной модели. Итогом работы является не только обученная архитектура, но и полноценное аналитическое обоснование её применимости и качества.
Гипотеза о жизнеспособности гибридного подхода
Предлагаемый гибридный алгоритм AIONet основан на сочетании детерминированного дерева решений, выполняющего первичную фильтрацию, и адаптивной LLM-компоненты, обеспечивающей семантическое уточнение выбора модели, датасе-та и параметров обучения. Гипотеза состоит в том, что синергия этих двух механизмов способна обеспечить более высокую точность, стабильность и обобщающую способность процесса автоматического отбора ресурсов по сравнению с использованием каждого метода по отдельности.
Ключевое утверждение гипотезы заключается в следующем: если дерево решений обеспечивает структурированный и интерпретируемый фильтр, а LLM компенсирует его жесткость за счёт контекстного анализа, то результирующий гибридный алгоритм будет устойчив к ошибкам классификации, адаптивен к неточным входным требованиям и способен улучшать рекомендации по мере накопления данных.
Предполагается, что эффективность AIONet проявится в трёх областях:
-
1. корректность выбора архитектуры модели под задачу;
-
2. релевантность рекомендуемых датасетов;
-
3. снижение количества ложных путей при подборе гиперпараметров.
Таким образом, гипотеза утверждает, что гибридный подход не только жизнеспособен, но и потенциально превосходит классические автоматизированные системы подбора моделей за счёт оптимального распределения ролей между жёсткой логикой и семантическим интеллектом.
Экспериментальный план проверки гипотезы
Для проверки гипотезы предлагается провести серию экспериментов, направленных на количественную и качественную оценку работы AIONet. План исследований строится вокруг сравнения трёх систем:
-
1. традиционного дерева решений;
-
2. изолированной LLM-системы;
-
3. гибридного алгоритма AIONet.
Подготовка экспериментальной среды.
Создаются унифицированные наборы задач, включающие классификацию изображений, обработку текстов и табличное прогнозирование. Для каждого направления формируются:
-
• эталонные модели и датасеты (что подразумевается под эталоном);
-
• требования к задаче в естественном языке;
-
• вариации некорректных и неполных входных описаний, имитирующих реальных пользователей.
Выбор метрик.
Для оценки эффективности применяются точность соответствия подобранной модели референсной архитектуре (Model Match Accuracy); релевантность рекомендуемого датасета (Dataset Relevance Score); количество ошибок маршрутизации в процессе подбора (Decision Error Rate); устойчивость к неточным запросам (Robustness-to-Noise Index).
План экспериментов.
Эксперимент делится на три последовательных блока.
Блок А: тестирование дерева решений.
Оценивается, насколько строгое, но ограниченное правило-ориентированное ветвление может самостоятельно подобрать модель и датасет. Особое внимание уделяется случаям, когда информация пользователя неполна.
Блок B: тестирование LLM.
LLM обрабатывает те же задания без предварительной фильтрации. Измеряется склонность модели к:
-
• галлюцинациям;
-
• непоследовательным рекомендациям;
-
• неоптимальному подбору из-за отсутствия структурных ограничений.
Блок C: тестирование AIONet.
Гибрид работает в полном режиме: дерево решений формирует ограниченный пул вариантов, после чего LLM выполняет контекстную оптимизацию. Фиксируются ошибки, время принятия решений, степень улучшения выводов по сравнению с блоками A и B.
Анализ и сравнение результатов.
Проводится сравнительный анализ:
-
• между каждым из трёх подходов;
-
• между задачами разных типов;
-
• между корректными и намеренно «шумными» запросами.
Особое внимание будет уделено тому, насколько гибридный подход снижает вероятность неправильной маршрутизации и увеличивает точность рекомендаций. Если AIONet демонстрирует устойчивое превосходство по основным метрикам, гипотеза считается подтверждённой.
Следующим этапом реализации проекта подразумевается проверка предложенного алгоритма для тестирования гипотезы о жизнеспособности алгоритма, подготовка статей с демонстрацией полученных результатов первичной фильтрации с описанием всех метрик, описанием методов и этапов тестирования, а также результатов тестирования с дальнейшими этапами развития.
Заключение
В представленном исследовании проведён анализ возможностей дерева решений и больших языковых моделей в задаче автоматизированного подбора моделей и датасетов, а также предложен проект адаптивного алгоритма AIONet, совмещающего преимущества обеих технологий. Дерево решений показало свою эффективность как формальный, интерпретируемый и вычислительно малозатратный механизм первичной фильтрации, способный системно упорядочивать пространство возможных решений. LLM, напротив, демонстрирует способность к контекстному обобщению, гибкой интерпретации задач и адаптивному формированию рекомендаций, что существенно расширяет спектр возможностей по настройке обучения и анализу результатов.
Интеграция этих методов в рамках AIONet позволяет создать гибридную архитектуру, в которой дерево решений обеспечивает структурированную основу выбора, а LLM – интеллектуальную адаптацию под конкретные осо- бенности данных, ограничений пользователя и хода обучения. Такая комбинация обладает потенциалом превосходить каждый из подходов по отдельности как по точности рекомендаций, так и по устойчивости результата. На этапе формирования гипотезы сделано предположение, что использование дерева решений как фильтра первого уровня и LLM как адаптивного поискового и аналитического модуля способно существенно повысить качество автоматизированной настройки моделей в реальных условиях.
Проектируемый алгоритм AIONet демонстрирует жизнеспособность как концепции гибридного AutoML-подхода. Он обеспечивает автоматическое взаимодействие с внешними источниками данных, адаптивную рекомендацию методов обучения, оценку времени вычислений и подробный аналитический отчёт по результатам обучения. Таким образом, AIONet формирует инструмент, ориентированный на широкую аудиторию – от начинающих пользователей до исследователей, желающих ускорить рутинные процессы и повысить эффективность экспериментов.
В дальнейшем требуется эмпирическая проверка предложенной гипотезы с использованием набора стандартных задач машинного обучения, сравнение результатов гибридного подхода с классическими AutoML-системами и количественная оценка вклада каждого модуля. Полученные данные позволят уточнить архитектуру AIONet и определить направления для его оптимизации и расширения функциональности.
