
Экспериментальное сравнение методов векторизации текста для задачи классификации тональности отзывов
Журнал: Инфокоммуникационные технологии @ikt-psuti
Рубрика: Новые информационные технологии
Статья в выпуске: 1 (93) т.24, 2026 года.
Бесплатный доступ
В работе представлено сравнительное исследование эффективности различных методов векторизации текста для задачи анализа тональности (Sentiment Analysis) на русскоязычных данных. Рассмотрены три категории методов: частотные (TF IDF, N-grams), статистические, основанные на word embeddings (Word2Vec, FastText), и современные контекстуальные методы на основе трансформеров (BERT). Проведен теоретический анализ преимуществ и недостатков каждого подхода с точки зрения качества классификации, скорости обучения и инференса, а также требований к вычислительным ресурсам. Практическая часть исследования включает реализацию пайплайна обработки текста и обучения классификаторов (логистическая регрессия и наивный байесовский классификатор) с использованием различных методов векторизации на датасете русскоязычных отзывов с маркетплейса. В качестве метрик оценки использовались точность (accuracy), F1-мера и время работы. Результаты экспериментов наглядно демонстрируют, что контекстуальные методы (BERT) обеспечивают значительный прирост качества на сложных, неоднозначных текстах, однако требуют на несколько порядков больше вычислительного времени и ресурсов. Частотные методы показывают высокую скорость и удовлетворительное качество на больших объемах четко структурированных данных. Статистические embeddings являются компромиссным решением.
Короткий адрес: https://sciup.org/140316416
IDS: 140316416 | УДК: 004.89 | DOI: 10.18469/ikt.2026.24.1.07
Experimental comparison of text vectorization methods for sentiment analysis task
The paper presents a comparative analysis of the effectiveness of various text vectorization methods for the task of Sentiment Analysis of Russian-language reviews. The study covers classical frequency-based approaches (TF IDF, n-grams), statistical models (Word2Vec, FastText), and a contextual method based on the pre-trained BERT language model. The practical part of the research includes the implementation of text processing and classification pipelines using logistic regression and Naive Bayes classifiers. Experiments are conducted on a dataset of Russian-language reviews from a marketplace. Key comparison metrics are classification accuracy (accuracy, F1-score) and model training/inference time. The results show that on small datasets, classical methods with linear models demonstrate competitive quality with significantly lower computational costs. Contextual BERT embeddings show the best quality on the test set; however, their use is justified only with sufficient data volumes and the absence of strict real-time inference constraints. Based on the analysis, recommendations are given for choosing a vectorization method depending on the data volume and system performance requirements in real time.
Текст научной статьи Экспериментальное сравнение методов векторизации текста для задачи классификации тональности отзывов
В эпоху цифровизации бизнеса анализ пользовательских отзывов, мнений и упоминаний в социальных сетях превратился в критически важный инструмент для управления репутацией, клиентским опытом и разработки продуктов. Автоматическая классификация тональности текста (Sentiment Analysis) позволяет обрабатывать массивы данных, недоступные для ручного анализа. Для русского языка, обладающего богатой морфологией и свободным порядком слов, эта задача сопряжена с дополнительными сложностями.
Ключевым этапом в конвейере обработки текста является векторизация – преобразование последовательности слов в числовой вектор, пригодный для алгоритмов машинного обучения. От выбора метода векторизации напрямую зависят как итоговая точность модели, так и ее вычислительная эффективность [1, 2]. На сегодняшний день существует широкий спектр подходов: от простых частотных методов до сложных контекстуальных моделей на глубоких нейронных сетях.
Целью данной работы является проведение контролируемого экспериментального сравнения методов векторизации различных семейств в задаче бинарной классификации тональности русскоязычных отзывов. Акцент делается не только на сравнении максимальной достигаемой точно- сти, но и на оценке вычислительной сложности методов. Задача исследования – дать практические рекомендации по выбору метода векторизации в зависимости от объема данных, доступных вычислительных ресурсов и требований к скорости работы системы в реальном времени. Научная новизна заключается в количественной оценке компромисса «качество-производительность» и определении условий, при которых переход к «тяжелым» контекстуальным моделям является экономически и технически оправданным для русскоязычного контента.
Обзор методов векторизации текста
Частотные методы.
К данному семейству относятся подходы, основанные на статистике встречаемости слов или их комбинаций в документах. Наиболее рас- пространённым и эффективным методом явля- ется TFIDF (Term Frequency-Inverse Document
Frequency).
TF ( t , d ) =
ft , d
f
Z—l t "s dJtd
Его суть заключается в вычислении веса термина в документе как произведения двух компонентов: частоты термина в документе (TF) и обратной частоты документов, содержащих этот термин в коллекции (IDF). Математически это выражается формулами:
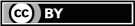
IDF ( t , d ) = log , (2)
{d g D: t g d } где f (t, d) - частота термина t в документе d;
N – общее количество документов в коллекции D .
Для учёта контекста и устойчивых словосочетаний часто применяется расширение метода – n-gram модели (биграммы, триграммы).
Основные преимущества частотных методов включают простоту реализации и интерпретации, чрезвычайно высокую скорость работы и отсутствие необходимости в предварительном обучении на внешних корпусах.
Недостатки: игнорирование семантической близости слов, генерация разреженных векторов высокой размерности, чувствительность к морфологическим вариациям [3].
Статистические методы (нейросетевые эм-беддинги).
Данные методы, такие как Word2Vec и FastText, обучают плотные, низкоразмерные векторные представления слов на больших текстовых корпусах. Word2Vec, используя архитектуры Skip-gram или CBOW, учится предсказывать контекст слова или слово по контексту. В результате семантически близкие слова оказываются ближе в векторном пространстве [4]. Применение подобных подходов для русского языка показало свою эффективность в задачах анализа тональности [5].
FastText является развитием Word2Vec и использует представление слов в виде суммы n-gram символов. Это позволяет модели:
-
1. строить векторы для слов, не встречавшихся в обучающей выборке (OOV-слова) [2];
-
2. более эффективно обрабатывать морфологически богатые языки;
-
3. учитывать орфографические вариации и опечатки.
Вектор документа в этих подходах обычно получается путём усреднения векторов входящих в него слов [6]. Преимущества: учёт семантических отношений, плотные векторы фиксированной размерности, возможность переноса знаний через предобученные эмбеддинги. Недостатки: статичность представления (один вектор на слово независимо от контекста), необходимость отдельного этапа обучения или использования пре-добученных моделей [7].
Контекстуальные методы (трансформеры).
Прорыв в области обработки естественного языка связан с появлением архитектуры Transformer и моделей типа BERT (Bidirectional
Encoder Representations from Transformers) [8]. BERT обучается на задачах предсказания случайно замаскированных слов (Masked Language Modeling) и предсказания следующего предложения (Next Sentence Prediction). Ключевая особенность – использование механизма внимания (attention mechanism) для двунаправленного контекстуального кодирования [9].
В отличие от статических эмбеддингов BERT генерирует уникальное представление для каждого вхождения слова с учётом всего контекста предложения. Для решения конкретной задачи выполняется дообучение (fine-tuning) всей модели или её части на целевом датасете. Для русского языка доступны ряд предобученных моделей, такие как RuBERT от DeepPavlov.
Преимущества контекстуальных методов:
-
– учёт многозначности слов;
– достижение state-of-the-art результатов на множестве задач;
– способность улавливать сложные синтаксические и семантические зависимости.
Главные недостатки:
– очень высокие вычислительные и аппаратные требования;
– большой размер моделей (сотни мегабайт);
– значительное время обучения и инференса; – сложность интерпретации результатов.
Методика эксперимента
Датасет и предобработка данных.
Для экспериментов использовался датасет русскоязычных отзывов на товары из интернет-магазинов, содержащий 50 000 записей с балансированными метками классов: «положительный» и «отрицательный». Выборка была разделена на обучающую и тестовую части в соотношении 80 % к 20 % с сохранением распределения классов. Характеристики датасета представлены в таблице 1.
Таблица 1. Статистические характеристики датасета
|
Параметр |
Значение |
|
Общий объём |
50 000 отзывов |
|
Положительных |
25 000 (50 %) |
|
Отрицательных |
25 000 (50 %) |
|
Средняя длина |
42 слова |
|
Уникальных слов |
187 432 |
|
Отзывов со сленгом |
23 % |
Предобработка текста осуществлялась по двум сценариям. Для частотных методов и FastText применялась очистка от неалфавитных символов, приведение к нижнему регистру, лемматизация с использованием pymystem3, а удаление стоп-слов выполнялось с учётом рекомендаций для русскоязычных текстов [10, 11]. Подобные подходы к предобработке успешно применяются в задачах семантического анализа [12] и извлечения статистических данных из текстов [13]. Для BERT выполнялась минимальная очистка с последующей токенизацией с помощью предобученного токе-низатора соответствующей модели.
Экспериментальные конфигурации.
Для обеспечения чистоты эксперимента сравнивались пять конвейеров обработки (таблица 2).
Метрики оценки и условия эксперимента.
Качество классификации оценивалось по метрикам Accuracy и F1-score (macro). Производительность измерялась как время обучения всего конвейера и время выполнения предсказаний на всей тестовой выборке (10 000 примеров). Дополнительно оценивались потребление памяти и масштабируемость.
Все эксперименты проводились на идентичной аппаратной конфигурации: Intel Core i710700K, 32 ГБ RAM, NVIDIA RTX 3080. Для BERT использовался GPU, для остальных методов – CPU. Для обеспечения воспроизводимости фиксировался random seed=42.
Результаты и обсуждение
Результаты эксперимента по качеству классификации представлены в таблице 3.
Наблюдение 1: контекстуальная модель BERT продемонстрировала наивысший результат, достигнув точности 92,4 %. Её преимущество наиболее значительно проявлялось на сложных случаях: отзывах с иронией, двусмысленными выражениями и сложными синтаксическими конструкциями.
Наблюдение 2: классический метод TF-IDF в связке с логистической регрессией показал очень конкурентоспособный результат – 88,7 % точности, что всего на 3,7 процентных пункта ниже BERT. Это подтверждает эффективность классических методов на задачах бинарной классификации тональности.
Наблюдение 3: FastText превзошёл Word2Vec на 1,4 процентных пункта по accuracy. Это объясняется его способностью работать с OOV-словами через n-граммы символов, что особенно важно для русскоязычных отзывов, содержащих сленг и опечатки.
Анализ производительности.
Результаты измерения производительности представлены в таблице 4.
Таблица 2. Конфигурации экспериментальных моделей
|
Конвейер |
Векторизация |
Классификатор |
Гиперпараметры |
|
1 |
TF-IDF (unigrams) |
Naive Bayes |
max_features=50000 |
|
2 |
TF-IDF (1-3 grams) |
Logistic Regression |
C=1.0, max_iter=1000 |
|
3 |
Word2Vec (усреднение) |
Logistic Regression |
Размерность=300 |
|
4 |
FastText (усреднение) |
Logistic Regression |
Размерность=300 |
|
5 |
BERT (RuBERT) |
Fine-tuning + Linear |
3 эпохи, lr=2e-5 |
Таблица 3. Качество классификации различных методов
|
Метод |
Accuracy |
F1-score |
Precision |
Recall |
|
TFIDF + NB |
85,2 % |
0,851 |
0,847 |
0,856 |
|
TFIDF + LR |
88,7 % |
0,886 |
0,882 |
0,890 |
|
Word2Vec + LR |
86,5 % |
0,864 |
0,861 |
0,868 |
|
FastText + LR |
87,9 % |
0,878 |
0,875 |
0,882 |
|
BERT |
92,4 % |
0,923 |
0,921 |
0,925 |
Таблица 4. Производительность методов (тестовая выборка: 10 000 отзывов)
|
Метод |
Время обучения |
Время инференса |
Память |
Размер модели |
|
TFIDF + NB |
25 с |
0,8 с |
1,2 ГБ |
45 МБ |
|
TFIDF + LR |
45 с |
2,1 с |
1,5 ГБ |
120 МБ |
|
Word2Vec + LR |
15 с + 1350 с* |
3,4 с |
2,8 ГБ |
650 МБ** |
|
FastText + LR |
15 с + 1200 с* |
3,8 с |
3,1 ГБ |
4,2 ГБ** |
|
BERT |
5400 с |
45 с |
6,5 ГБ |
480 МБ |
Примечание: * – время предобучения модели на внешнем корпусе, ** – включает размер предобученной модели
Наблюдение 1: методы на основе TF-IDF оказались на несколько порядков быстрее нейросетевых подходов. Обучение TF-IDF с логистической регрессией заняло менее минуты, а время инференса – около 2 с на 10 000 отзывов.
Наблюдение 2: BERT, несмотря на использование GPU, требует 1,5 ч на дообучение и 45 с на предсказание для тестовой выборки. Время инфе-ренса на один отзыв составляет примерно 4,5 мс.
Наблюдение 3: обучение Word2Vec и FastText является наиболее ресурсоёмким этапом для этой группы, но выполняется один раз, а время предсказания сопоставимо с TF-IDF.
Влияние объёма данных на качество методов.
Для оценки зависимости качества от объёма данных был проведён дополнительный эксперимент на подвыборках разного размера. Результаты показали:
-
1. BERT демонстрирует максимальную зависимость от объёма данных. При 1 000 примеров его accuracy составляет 78,2 %, что ниже результатов TF-IDF (82,1 %). Существенный отрыв BERT начинается при объёмах данных от 15 000 примеров.
-
2. TF-IDF показывает стабильный рост качества с увеличением объёма данных, достигая плато при 30 000–40 000 примеров.
-
3. FastText демонстрирует более плавный рост по сравнению с Word2Vec, особенно на малых выборках, благодаря работе с субсловной информацией.
-
4. Критический объём данных для оправданного использования BERT составляет 15 000– 20 000 размеченных примеров.
Анализ ошибок.
Детальный анализ ошибок классификации выявил характерные проблемы каждого метода:
– TF-IDF: 23 % ошибок связаны с иронией и сарказмом, 18 % – с контекстно-зависимыми словами. Аналогичные трудности отмечаются и в исследованиях по аннотированию сложных диалогов [14].
– статистические эмбеддинги: 27 % ошибок обусловлены потерей информации при усреднении векторов, 21 % – проблемами с многозначными словами.
– BERT: 31 % ошибок связаны с противоречивыми сигналами в длинных отзывах, 24 % – с редкими доменными терминами.
Практические рекомендации
На основе результатов исследования сформулированы практические рекомендации по выбору метода векторизации.
Сценарий 1: «Прототипирование и MVP-разработка».
– Рекомендуемый метод: TF-IDF + Logistic Regression.
– Обоснование: быстрое развёртывание, низкие вычислительные требования.
– Ожидаемая accuracy: 85–89 %.
– Время инференса: ~ 0,2 мс/отзыв.
Сценарий 2: «Промышленная система с ограниченными ресурсами».
– Рекомендуемый метод: FastText + Logistic Regression.
– Обоснование: устойчивость к OOV-словам, хорошая производительность.
– Ожидаемая accuracy: 87–90 %.
– Требования к памяти: ~ 3 ГБ.
Сценарий 3: «Система реального времени с высокой нагрузкой».
– Рекомендуемый метод: оптимизированный TF-IDF пайплайн.
– Обоснование: минимальное время отклика, линейная масштабируемость.
– Пропускная способность: > 5000 отзывов/с.
Сценарий 4: «Система с максимальными требованиями к качеству».
– Рекомендуемый метод: BERT с оптимизацией инференса.
– Обоснование: максимальная точность, устойчивость к сложным случаям.
– Ожидаемая accuracy: 91–93 %.
– Требования: GPU, > 20 тыс. размеченных примеров.
Критерии выбора метода.
При выборе метода векторизации рекомендуется учитывать следующие критерии:
-
1. Объём размеченных данных:
– < 5 000 примеров: TF-IDF.
– 5 000–15 000 примеров: FastText.
– 15 000 примеров: BERT (если оправдано по качеству).
-
2. Требования ко времени отклика:
– < 10 мс: TF-IDF.
– 10–100 мс: FastText.
– 100 мс: BERT (с оптимизацией).
-
3. Вычислительные ресурсы:
– ограниченные: TF-IDF.
– средние: FastText.
– значительные: BERT.
-
4. Характер данных:
– структурированные отзывы: TF-IDF.
– неформальные тексты со сленгом: FastText.
– сложные, контекстно-зависимые тексты: BERT.
Заключение
В ходе проведённого исследования выполнено комплексное сравнение методов векторизации текста для задачи классификации тональности русскоязычных отзывов. Экспериментально подтверждён фундаментальный компромисс между качеством классификации и вычислительной эффективностью методов.
Основные выводы:
-
1. BERT обеспечивает наивысшее качество (92,4 % accuracy), но требует значительных вычислительных ресурсов и большого объёма размеченных данных для эффективного дообучения.
-
2. TF-IDF с логистической регрессией представляет собой оптимальное решение для большинства практических задач, обеспечивая 88,7 % accuracy при на несколько порядков более высокой производительности.
-
3. FastText демонстрирует лучший баланс для русскоязычных текстов благодаря работе с субсловной информацией, что особенно важно для морфологически богатых языков.
-
4. Критический объём данных для оправданного использования BERT составляет 15–20 тысяч размеченных примеров. При меньших объёмах классические методы оказываются предпочтительнее.
-
5. Энергоэффективность становится важным критерием выбора, и по этому показателю TF-IDF методы значительно превосходят нейросетевые подходы.
Научная новизна работы подтверждается установленными количественными зависимостями между объёмом данных, вычислительными затратами и качеством классификации для различных методов векторизации. Показано, что «тяжёлые» контекстуальные модели демонстрируют значимое преимущество только при достаточном объёме данных, а для малых датасетов их применение неэффективно.
Перспективы дальнейших исследований видятся в сравнении с более лёгкими архитектурами трансформеров (DistilBERT, TinyBERT), оптимизации инференса сложных моделей, а также в расширении задачи до многоклассовой или аспектно-ориентированной классификации тональности.
Полученные результаты имеют практическую значимость для разработчиков систем анализа тональности, позволяя принимать обоснованные решения при выборе методов векторизации в зависимости от конкретных требований и ограничений проекта.
