
Метод аппаратного ускорения постквантовых криптографических примитивов на базе нейронных процессоров в IoT
Рубрика: Информатика и вычислительная техника
Статья в выпуске: 3, 2026 года.
Бесплатный доступ
Работа посвящена проблеме эффективной реализации постквантовой криптографии (PQC) в ресурсоограниченных системах интернета вещей (IoT). Программное исполнение криптографии на решетках (LBC) на классических микроконтроллерах приводит к критическим задержкам и энергопотреблению. В статье предложен метод адаптации вычислительных ядер LBC для исполнения на гетерогенных SoC, оснащенных нейронными сопроцессорами (NPU). Математически обоснована эквивалентность операции полиномиального умножения и тензорной свертки, что позволяет делегировать нагрузку NPU-акселераторам. Валидация метода проведена путем моделирования. Расчетная оценка демонстрирует, что предложенная гибридная архитектура обеспечивает значительное ускорение криптографических примитивов с ядрами Cortex-M4. Также проанализированы векторы атак на NPU и предложены архитектурные механизмы защиты памяти.
Короткий адрес: https://sciup.org/148334282
IDS: 148334282 | УДК: 004.62:004.89:004.77 | DOI: 10.18137/RNU.V9187.26.03.P.151
A method for hardware acceleration of post-quantum cryptographic primitives using neural processing units in IoT
This paper addresses the problem of efficient implementation of post-quantum cryptography (PQC) in resource-constrained Internet of Things (IoT) systems. Software implementation of lattice-based cryptography (LBC) standards on classical microcontrollers results in critical latency and high energy consumption. The article proposes a method for adapting LBC computational kernels for execution on heterogeneous SoCs equipped with Neural Processing Units (NPUs). The equivalence between polynomial multiplication and tensor convolution is mathematically substantiated, allowing the computational load to be offloaded to NPU accelerators. The method was validated through simulation. Performance estimation demonstrates that the proposed hybrid architecture achieves significant speedup for cryptographic primitives compared to Cortex-M4 cores. Additionally, attack vectors targeting NPUs are analyzed, and architectural memory protection mechanisms are proposed.
Текст научной статьи Метод аппаратного ускорения постквантовых криптографических примитивов на базе нейронных процессоров в IoT
Криптографическая стойкость классических ассиметричных стандартов (RSA, ECC) оказывается под угрозой ввиду потенциальной возможности реализации алгоритма Шора [1] на квантовых вычислителях, что в совокупности с прогрессом в области наращивания кубитов [2] актуализирует задачу миграции на постквантовую криптографию (PQC).
Критическим фактором для систем с длительным жизненным циклом (государственные архивы, ключи шифрования) являются атаки типа Harvest Now, Decrypt Later (HNDL), формирующие окно уязвимости еще до физического появления квантового компьютера [3].
Теоретические и практические ограничения классической криптографии в IoT
Алгоритм Шора снижает время подбора 2048-битного ключа RSA до нескольких часов при наличии квантового компьютера [4]. Узлы IoT особенно уязвимы к данной угрозе. Причины кроются в длительном сроке эксплуатации оборудования и строгих лимитах энергопотребления. Миграция на PQC требует оценки не только вычислительной сложности операций, но и их энергетической стоимости.
Согласно стандартам Национального института стандартов и технологий США (NIST) эквивалент AES-128 достигается при длине ключа RSA от 3072 бит [5]. Программная реализация такого алгоритма на малоресурсных микроконтроллерах нецелесо-
Метод аппаратного ускорения постквантовых криптографических примитивов на базе нейронных процессоров в IoT образна. Вычисления могут вызывать критические задержки работы процессора. Дополнительно возникает проблема блокировки каналов передачи данных в энергоэффективных сетях (LoRaWAN, Zigbee) из-за превышения размера передаваемых пакетов.
По этой причине алгоритм RSA рассматривается в данном исследовании как справочный ориентир. Текущим стандартом индустрии и конкурентом PQC выступает криптография на эллиптических кривых (ECC).
Сравнительный анализ этапов установления защищенного соединения на базе платформы Cortex-M4 представлен в Таблице 1. В качестве основы были выбраны функционально эквивалентные операции протокола рукопожатия со стороны устройств IoT. Для классической криптографии оценивается процедура выработки общего секрета (ECDH). Для постквантовых алгоритмов оценивался механизм инкапсуляции ключа (KEM) и подписи.
Таблица 1
Сравнительные характеристики операций установления защищенного соединения на типовых IoT-устройствах
|
Алгоритм |
Операция |
Тактов CPU |
Время, мс* |
Энергия, мкДж** |
|
X25519 (ECC) |
ECDH (Shared Secret) |
428 570 |
2,55 |
≈255 |
|
RSA-2048 |
Key Transport (Public) |
≈2 100 000 |
12,44 |
≈1 244 |
|
Kyber-768 |
Инкапсуляция |
1 146 556 |
6,82 |
≈682 |
|
Dilithium3 |
Подпись |
9 289 499 |
55,30 |
≈5 530 |
* Время приведено для частоты 168 МГц (Cortex-M4).
** Энергия рассчитана пропорционально времени исполнения (при полной загрузке CPU). Источник: таблица составлена авторами на основе [6–8].
Данные Таблицы 1 для алгоритма RSA отражают только операции с открытым ключом (12,44 мс). При этом операции с закрытым ключом (например, генерация цифровой подписи) занимают на микроконтроллерах более 450 мс [8]. Это затрудняет использование RSA в системах реального времени.
Современный стандарт ECC демонстрирует высокую скорость выполнения базовых операций (2,55 мс). Однако миграция на постквантовые алгоритмы (Kyber, Dilithium) увеличивает вычислительные задержки в 2,7–21 раз. Энергопотребление при этом возрастает до пиковых 5530 мкДж. Следовательно, программная реализация PQC-примитивов аналогично затрудняет использование PQC.
Специфика уязвимостей
Специфика инфраструктуры IoT характеризуется длительным сроком эксплуатации (10–15 лет) и сложностью обновлений парка устройств. Согласно отчетам [9–11], промышленный сектор лидирует по числу инцидентов, при этом средняя стоимость утечки достигла 4,88 млн долларов. Пересечение сроков жизни устройств с моментом появления криптографически релевантного квантового компьютера (CRQC) классифицируется NIST как критический риск управления активами, требующий превентивной защиты от HNDL-атак уже сегодня [12].
Вестник Российского нового университета
Серия «Сложные системы: модели, анализ и управление». 2026. № 3
Собираемые данные могут обладать длительной ценностью, превышающей срок службы самого оборудования. Это создает риск асимметричного ущерба, когда компрометация бюджетного IoT-узла приводит к системным потерям критической инфраструктуры [13], что делает защиту от атак HNDL приоритетной задачей.
Проблема усугубляется невозможностью программной модернизации унаследованного парка. Catuogno и Galdi [14] указывают, что отсутствие доверенного загрузчика и аппаратных криптографических примитивов в низкоресурсных системах делает реализацию защищенных механизмов обновления технически невыполнимой.
Уязвимости к атакам по сторонним каналам
Ресурсные ограничения IoT-устройств создают предпосылки для атак по сторонним каналам при реализации постквантовых алгоритмов. Исследования на платформах Cortex-M4 выявили высокую корреляцию энергопотребления с секретными параметрами при выполнении криптографических операций [15]. Для устройств с ограниченными ресурсами это является критическим вектором атаки, требующим специальных методов защиты, таких как маскирование секретных значений [15].
Также существенны и временные атаки. Вариативность времени выполнения операций в зависимости от загрузки системы позволяет злоумышленнику применять статистический анализ для восстановления ключа. Кроме того, использование единой памяти (HyperRAM) для кода и данных создает возможности для атак по времени доступа [16].
Классификация IoT-устройств
Для систематизации рисков и выработки стратегии защиты предлагается классификация IoT-устройств, основанная на модели жизненного цикла и критичности обрабатываемых данных (Таблица 2) [17–19]. Данная матрица позволяет дифференцировать подходы к миграции, опираясь на методологию NIST по переходу на постквантовую криптографию [17].
Таблица 2
Классификация IoT-устройств по параметрам уязвимости к квантовым угрозам
|
Класс устройства |
Типичные примеры |
Срок ввода в эксплуатацию* |
Критичность данных (HNDL риск) |
Рекомендуемый подход к миграции |
|
Критический |
Медицинские импланты, контроллеры SCADA |
2018–2022 |
Высокая (угроза жизни / инфраструктуре) |
Немедленная аппаратная замена или гибридная схема (Crypto-Agility) |
|
Высокий риск |
Умные замки, автокомпоненты, камеры наблюдения |
2020–2024 |
Средняя / Высокая (персональные данные, видео) |
Приоритетное обновление прошивки (OTA) до 2027 г. |
|
Средний риск |
Носимая электроника, датчики умного дома |
2022–2025 |
Средняя (поведенческие данные) |
Плановая миграция на PQC до 2030 г. |
|
Низкий риск |
Одноразовые метки, простые сенсоры |
2023+ |
Низкая (агрегированные данные) |
Замена устройства по исчерпании ресурса |
* Срок ввода указывает на устройства, чей жизненный цикл (10–15 лет) пересечется с моментом появления CRQC.
Источник: таблица составлена авторами на основе [17–19].
Метод аппаратного ускорения постквантовых криптографических примитивов на базе нейронных процессоров в IoT
Для массового сегмента (Consumer IoT, см. Таблицу 2) решения на базе FPGA или ASIC экономически нецелесообразны из-за ограничений управления спецификациями (BOM). Оптимальной стратегией может стать использование уже имеющихся на кристалле NPU-блоков, что не потребует изменения аппаратной конфигурации устройства.
Классификация PQC и критерии выбора
Из финалистов конкурса NIST (Таблица 3) наиболее перспективными для IoT являются алгоритмы на решетках (LBC). Они обладают сбалансированной сложностью O ( n log n ) и потенциалом для распараллеливания, в отличие от кодовых схем (большой размер ключей) или хеш-функций (высокая задержка).
Таблица 3
Сравнительный анализ алгоритмов PQC в контексте ограничений IoT
|
Алгоритм (тип) |
Размер ключа (секретный / открытый) |
Базовая операция |
Потенциал аппаратного ускорения |
Вердикт для IoT |
|
Kyber (LBC) |
Kyber-512: 1.5/0.8 КБ; Kyber-768: 2.3/1.2 КБ |
NTT + полиномиальное умножение |
Высокий (для SIMD, FPGA, потенциально NPU) |
Основа для гибридных схем |
|
Dilithium (LBC) |
Dilithium3: 3.0/1.9 КБ; Dilithium5: 3.5/2.5 КБ |
NTT + полиномиальное умножение |
Высокий (хорошо распараллеливается) |
Стандарт ЭЦП для IoT |
|
BIKE / HQC (Code) |
BIKE:~10-20 КБ; HQC:~50-100 КБ |
Битовые операции в GF(2 m ) XOR, сдвиги |
Средний (требует специализированных FPGA) |
Резервный вариант для энергоемких IoT |
|
SPHINCS+ (Hash) |
32-64 КБ / 1-4 КБ |
Хеш-функции (SHA3/SHAKE) |
Низкий (требует SHA-акселератор) |
Только для offline-сценариев |
|
McEliece |
255-1326 КБ / 255-1326 КБ |
Линейная алгебра над GF(2) |
Ограниченный (плохо параллелится) |
Невозможно для части IoT |
Источник: здесь и далее таблицы составлены авторами по материалам исследования.
Обоснование выбора LBC
Решетчатые алгоритмы (LBC) являются безальтернативным выбором для массового IoT по совокупности факторов. Алгоритмы на кодах (BIKE, HQC) требуют передачи кратно большего объема данных, что критично для узкополосных сетей (NB-IoT, LoRaWAN).
Основным ограничением производительности LBC остается вычислительная сложность полиномиального умножения. В частности, для алгоритма NTRU-HRSS701 ( n = 701, q = 8192) даже при использовании оптимизированных методов (Toom-4/ Karatsuba) одно полиномиальное умножение в кольце Rq требует более 170,000 тактов процессора Cortex-M4 [20].
Вестник Российского нового университета
Серия «Сложные системы: модели, анализ и управление». 2026. № 3
Эволюция аппаратных решений
Сравнительный анализ аппаратных архитектур (Таблица 4) выделяет гибридный подход (CPU-NPU) как компромиссное решение, обеспечивающее баланс между производительностью и стоимостью внедрения в существующую инфраструктуру.
Таблица 4
Сравнительный анализ аппаратных решений
|
Тип решения |
Примеры |
Преимущества |
Недостатки |
|
ASIC |
PQShield |
Производительность, энергоэффективность |
Высокая стоимость разработки, нет гибкости |
|
FPGA |
Xilinx, Intel |
Перепрограммируемость |
Сложность разработки, цена, энергопотребление |
|
Гибридные CPU-NPU |
Hailo, Google TPU |
Экономическая эффективность, доступность |
Ограниченная точность, отсутствие mod q |
Математическая основа синергии
Архитектурная синергия между LBC и NPU имеет строгое математическое обоснование. Ключевой операцией криптографии на решетках является полиномиальное умноже- ние в кольце
R q
^q [ X]
X N ± 1 ,
допускающее представление в виде операций, базовых для нейронных сетей.
Для алгоритмов типа NTRU полиномиальное умножение
c ( x ) = a ( x ) b ( x )(mod( xN – 1))
эквивалентно циклической свертке векторов коэффициентов:
c k = X a i b j .
i + j = k ( mod N )
Эта операция идентична слою 1D-свертки (Convolution) в глубоком обучении. Альтернативно, она может быть представлена как умножение циркулянтной матрицы, составленной из коэффициентов a ( x ), на вектор b ( x ) (GEMV).
На основе выявленной математической двойственности предлагается концептуальная схема разделения вычислительной нагрузки (см. Рисунок). В данной архитектуре наиболее ресурсоемкая тензорная часть (свертка или матричное умножение) делегируется ускорителю NPU, в то время как операции, требующие сложной логики управления или специфической арифметики (генерация полиномов, модульная редукция), выполняются на центральном процессоре.
Метод аппаратного ускорения постквантовых криптографических примитивов на базе нейронных процессоров в IoT
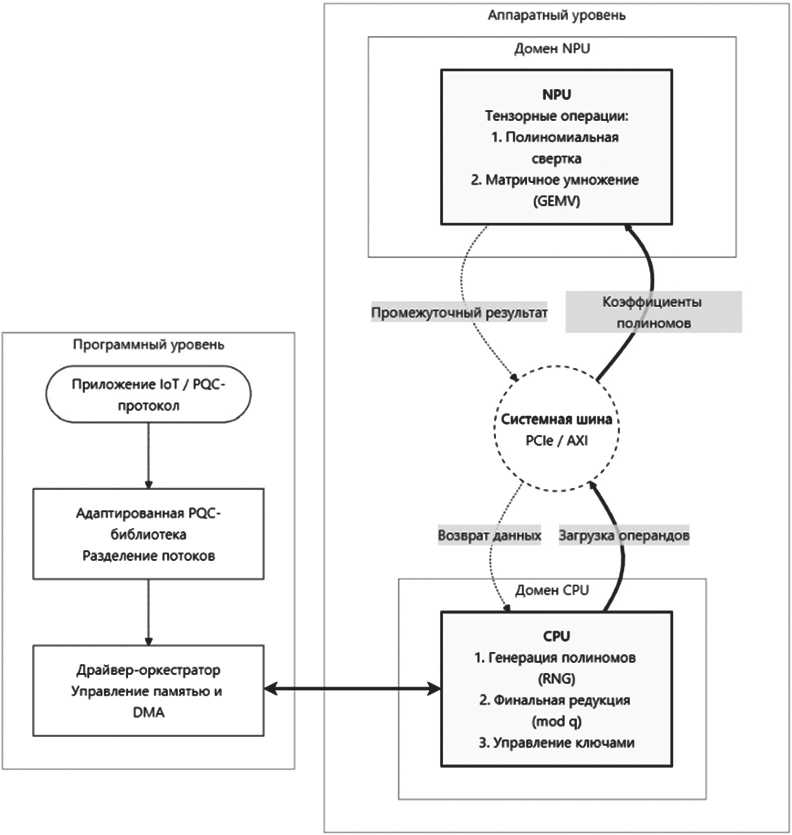
Рисунок. Концептуальная схема гибридной вычислительной архитектуры: разделение функциональных обязанностей между CPU и NPU Источник: рисунок выполнен авторами
Модель угроз и архитектурная реализация
Внедрение NPU создает прецедент использования архитектурно закрытых компонентов для критических операций. В отличие от документированных CPU микроархитектура NPU зачастую является проприетарной, что затрудняет независимый аудит безопасности. Можно выделить три специфических вектора угроз для таких систем:
-
1. В архитектуре SoC центральный процессор и NPU, как правило, разделяют общую системную шину и контроллер памяти. В условиях многозадачной ОС без стро-
- Вестник Российского нового университета
Серия «Сложные системы: модели, анализ и управление». 2026. № 3
-
2. Аппаратный пропуск операций умножения на ноль, эффективный для нейросетей, в криптографии создает уязвимость по времени исполнения, раскрывая количество нулевых коэффициентов в секретном полиноме.
-
3. Использование ускорителей через PCIe или USB создает риск перехвата данных на физическом уровне, а также атак через прямой доступ к памяти.
гой изоляции ресурсов возникает потенциальный вектор атаки по сторонним каналам.
Для нейтрализации рисков перехвата данных на системной шине предполагается использование механизмов аппаратной изоляции памяти (IOMMU для шлюзов или MPU/ TrustZone для микроконтроллеров). В рамках предлагаемой модели драйвер-оркестратор обеспечивает монопольный доступ к NPU на время выполнения криптографической операции, блокируя попытки обращения к памяти ускорителя со стороны сторонних процессов, что нивелирует риски атак по времени доступа.
Теоретическая оценка производительности
Валидация модели в среде PyTorch [21] через побитовое сравнение со стандартной реализацией (SymPy) подтвердила полную математическую эквивалентность тензорной свертки и полиномиального умножения, что гарантирует корректность криптографических преобразований при переносе на NPU.
Для верификации гипотезы проведен сравнительный расчет эффективности выполнения полиномиального умножения (на параметрах NTRU-HRSS-701). В качестве базовых вычислителей, не имеющих аппаратного ускорения, рассмотрены два представителя инфраструктуры IoT:
-
1. Уровень Gateway – процессор Cortex-A76, использующий только программные векторные инструкции NEON.
-
2. Уровень Endpoint – микроконтроллер Cortex-M4, опирающийся на DSP-расширения.
Данным программным подходам противопоставляются две предлагаемые гибридные топологии. В качестве референсного сопроцессора выбран тензорный чип Hailo-8L. Для Gateway сценария он выступает моделью внешнего ускорителя, обмен данными с которым идет по системной шине PCIe. Для Endpoint устройств параметры Hailo-8L служат оценкой перспективной системы на кристалле (SoC), где NPU интегрирован рядом с ядром Cortex-M4 и делит с ним высокоскоростную внутреннюю шину AHB/AXI.
Поскольку NTRU и Kyber требует работы с коэффициентами разрядностью 12– 13 бит, прямая обработка в INT8 недопустима из-за потери точности. Расчет теоретической производительности NPU выполнен для консервативного режима INT16:
13 TOPS
P = = 3,25 TOPS ≈ 3250 GOPS .
eff 4
Параметр Peff отражает асимптотический предел пропускной способности архитектуры. Достижение такой производительности на практике потребует максимальной загрузкой вычислительных ядер, за счет внедрения механизма пакетной обработки входных данных.
Метод аппаратного ускорения постквантовых криптографических примитивов на базе нейронных процессоров в IoT
Критическим фактором является защита от переполнения разрядной сетки в момент накопления суммы свертки. Современные NPU имеют 32-битные аккумуляторы сложения. Моделирование худшего случая для NTRU-HRSS-701 (N = 701, модуль q = 8192) показывает, что даже при максимальных значениях коэффициентов итоговая сумма не превышает порог S max ≈ N · q ≈ 5,7·106. Выявленный максимум гарантированно укладывается в диапазон знакового целого INT32 ≈ (2,14·109).
Размерность полиномов в стандартах NIST ( N = 701, N = 768) структурно не кратны размерностям аппаратных тензорных ядер. Для запуска вычислений матрицы дополняются нулями. Эта избыточность является незначительной и учтена в итоговых расчетах.
Для Cortex-A76 расчет ведется с учетом задержек шины PCIe и драйвера. Для Cortex-M4 моделируется взаимодействие через высокоскоростную внутреннюю системную шину (AHB/AXI), характерную для интегрированных SoC-решений.
Результаты сопоставления представлены в Таблице 5. Характеристики NPU выделены в отдельную колонку как универсальная математическая модель сопроцессора. Чистое время тензорных вычислений идентично для обоих сценариев. Формирование итоговых задержек гибридной архитектуры зависит исключительно от накладных расходов на транспортировку матриц по локальной шине AHB/AXI для Cortex-M4 или по внешнему интерфейсу PCIe для Cortex-A76.
Таблица 5
Теоретическая оценка производительности и энергоэффективности выполнения полиномиального умножения
|
Метрика |
Endpoint-IoT (Cortex-M4) |
Gateway-IoT (Cortex-A76) |
NPU-ускоритель (Hailo-8L) |
Анализ эффективности (NPU vs CPU) |
|
Режим работы |
DSP-расширения |
NEON-инструкции |
Тензорные вычисления (INT16) |
– |
|
Пиковая производительность |
≈0,1 GOPS |
≈38,4 GOPS |
≈3250 GOPS |
Архитектурное преимущество NPU над M4 > 3000 раз, над A76 ≈ 85 раз |
|
Время вычислений (ядро) |
≈1 700 мкс |
≈200 мкс |
< 1 мкс |
Временем вычислений на NPU можно пренебречь |
|
Накладные расходы (интерфейс) |
≈0 мкс (SRAM/ Flash) |
≈0 мкс (L1 Cache) |
~ 60–100 мкс (зависит от типа шины: AHB/AXI или PCIe) |
Узкое место смещается с вычислений на интерфейс передачи данных |
|
Итоговое время операции |
≈1 700 мкс |
≈200 мкс |
≈60–100 мкс |
Ускорение: 17 x –28 x относительно узла, 2 x –3 x относительно шлюза |
|
Энергия (на 1 операцию) |
≈170 мкДж |
≈400 мкДж |
≈20–50 мкДж |
Выигрыш в 3–8 раз по сравнению с CPU |
|
Узкое место |
Блокировка ALU |
Ширина вектора |
Шина данных |
Делегирование задач на NPU полностью освобождает CPU |
На Gateway-уровне интеграция сопроцессора дает эффект преимущественно за счет асинхронного режима работы. Итоговое время операции здесь упирается не в скорость
Вестник Российского нового университета
Серия «Сложные системы: модели, анализ и управление». 2026. № 3
вычислений, а в физические задержки при пересылке матриц по внешней шине PCIe. Однако перенос ресурсоемкой математики на тензорные блоки значительно разгружает центральный процессор. Высвобожденные мощности направляются на обслуживание сетевого стека и маршрутизацию пакетов, что кратно увеличивает общую пропускную способность шлюза при массовых подключениях IoT-клиентов.
На Endpoint-уровне применение NPU внутри SoC дает прирост скорости в 17–28 раз. Столь высокий показатель обусловлен изначальной слабостью АЛУ микроконтроллера и низким уровнем интерфейсных ограничений внутри SoC.
Помимо сокращения задержек гетерогенная архитектура решает проблему энергоэффективности. Во время выполнения тензорным ядром криптографических расчетов основной процессор микроконтроллера может перейти в режим сна либо параллельно выполнять другую работу. Для устройств IoT с питанием от батарей такой паттерн работы даст значительное преимущество.
Математическая база алгоритмов Kyber и Dilithium строится на идентичных вычислениях в полиномиальных кольцах. Благодаря этому разработанная модель носит универсальный характер. Она аппаратно ускоряет оба типа криптографических примитивов, комплексно решая проблему ресурсоемкой постквантовой аутентификации в сетях интернета вещей.
Выводы
Проведенное исследование показало, что миграция на программно реализованные алгоритмы LBC на устройства IoT неэффективна и ведет к значительному падению производительности и росту энергопотребления до 8 раз. Для систем интернета вещей, работающих в реальном времени, такие показатели критичны.
В работе предложен способ преодоления этого барьера через использование тензорных ядер нейронных процессоров (NPU). В основу метода легла доказанная математическая эквивалентность полиномиального умножения в кольце Rq и операции одномерной свертки. Это позволяет внедрять постквантовую криптографию (PQC) в современную инфраструктуру IoT без радикальной замены существующей элементной базы.
Несмотря на высокую эффективность, модель имеет ряд ограничений. Требуются дальнейшие исследования в области натурной верификации предложенного подхода, а также разработки специализированных механизмов защиты NPU от атак по побочным каналам, обусловленных архитектурными особенностями тензорных ускорителей.
