Методика адаптации алгоритмов глубокого обучения для скрининга диабетической ретинопатии в условиях реальной клинической практики
Журнал: Компьютерная оптика @computer-optics
Рубрика: Численные методы и анализ данных
Статья в выпуске: 4 т.50, 2026 года.
Бесплатный доступ
Применение систем искусственного интеллекта для скрининга диабетической ретинопатии в реальной клинической практике ограничено проблемой снижения точности алгоритмов при переносе на новые источники данных. Целью данной работы является разработка и валидация методики адаптации предобученных моделей к условиям гетерогенности медицинских изображений. В исследовании проанализировано влияние различий в характеристиках наборов данных на качество классификации. Показано, что при прямом переносе модели с открытых баз данных на локальный клинический набор (1123 снимка, 302 пациента), отличающийся техническими параметрами снимков и выраженным дисбалансом классов, метрика macro-F1 снижается с 0,86 до 0,38. Для обеспечения корректного переноса знаний модели и минимизации шума при обучении ключевым этапом работы стало формирование качественного эталонного локального набора данных. Для этого был применен многоступенчатый протокол аннотирования и оценки согласованности врачей-экспертов. На основе подготовленных данных была реализована двухэтапная стратегия трансферного обучения (архитектура EfficientNet-B0). Несмотря на ограниченный объем выборки, данная схема разметки в сочетании с предложенным подходом к дообучению позволила повысить метрику macro-F1 на валидационной выборке до 0,63. Результаты подтверждают, что создание качественно размеченных локальных датасетов является критически важным шагом для успешной адаптации диагностических систем к условиям практического здравоохранения.
Короткий адрес: https://sciup.org/140316476
IDS: 140316476 | DOI: 10.18287/COJ1839
Deep Learning for Diabetic Retinopathy Screening: An Adaptation Methodology for Real-World Clinical Environments
The deployment of deep learning systems for diabetic retinopathy screening in real-world clinical settings is limited by performance degradation when algorithms are applied to novel data sources. This study aims to develop and validate a methodology for adapting pre-trained models to the heterogeneity inherent in medical imaging data. The research analyzes the impact of dataset disparities on classification performance. It is demonstrated that the direct transfer of a model trained on public databases to a local clinical dataset (1,123 images, 302 patients), characterized by distinct technical parameters and pronounced class imbalance, results in a significant decline in the macro-F1 score from 0.86 to 0.38. To ensure robust knowledge transfer and minimize training noise, a critical stage of this work involved constructing a high-quality reference local dataset. This was achieved through a multi-stage annotation protocol and an assessment of inter-rater agreement among expert physicians. Utilizing the curated data, a two-stage transfer learning strategy was implemented using the EfficientNet-B0 architecture. Despite the limited sample size, this annotation scheme, combined with the proposed fine-tuning approach, improved the macro-F1 score on the validation set to 0.63. The results confirm that the creation of annotated local datasets is a critical step for the successful adaptation of diagnostic systems to practical healthcare settings.
Текст научной статьи Методика адаптации алгоритмов глубокого обучения для скрининга диабетической ретинопатии в условиях реальной клинической практики
Сахарный диабет (СД) признан глобальной эпидемией: в РФ число пациентов выросло с 3,94 млн в 2013 г. до 5,55 млн в 2023 г. (+40%) [1].
Диабетическая ретинопатия (ДР) – частое осложнение СД и ведущая причина слепоты. Распространённость ДР в РФ составляет 28,9 % при СД 1 типа и 12,3 % при СД 2 типа, что соответствует более 700 тыс. пациентов [2].
Доступ к офтальмологическому скринингу в РФ неравномерен: плотность кабинетов варьируется от 1–2 до 10 – 15 на 100 000 населения, из-за чего до 40% пациентов пропускают ежегодные осмотры и ДР выявляется на поздних стадиях. Отсутствие единых платформ и дефицит кадров усугубляют ситуацию [2].
На сегодняшний день для автоматизированного выявления и стадирования ДР создано множество систем, применяющих различные методы компьютерного зрения и искусственного интеллекта. Среди наиболее известных международных решений – RetmarkerDR [3], EyeArt [4], IDx-DR [5] (первая система, одобренная FDA для автономной диагностики ДР), система от команды Google DeepMind [6], а также крупные коммерческие платформы IRIS [7] и SERI-NUS [8], успешно внедрённые в рутинную клиническую практику за рубежом. Современные алгоритмы этих систем построены на глубоких сверточных нейронных сетях, что обеспечивает им высокие значения чувствительности на тестовых датасетах (до 96 – 97%) и специфичности (до 90 – 95%) [9, 10].
Однако при переносе в реальную клиническую практику точность моделей падает из-за смещения доменов (domain shift), вызванного различиями в оборудовании, протоколах съёмки и популяциях [11 – 13]. Это требует разработки методов адаптации моделей к локальным условиям [14 – 17].
В последние годы набирают популярность гибридные решения, сочетающие сегментацию ключевых патологических признаков (микроаневризмы, кровоизлияния, экссудаты) с последующей интерпретацией по экспертным правилам, а также системы с элементами контроля качества снимка и интеллектуальными подсказками для пользователя при съёмке. Российские коллективы также демонстрируют высокий уровень решений. Разработаны прототипы сервисов и сегментационные алгоритмы, достигающие чувствительности 85 – 92% на ограниченных по объему и гетерогенных по происхождению выборках, полученных в условиях российских медицинских учреждений. Также исследователи отмечают [18], что все существующие системы критически зависят от используемых датасетов и специфики оборудования: перенос моделей между различными клиниками и аппаратами часто сопровождается падением качества предсказаний из-за смещения целевого домена (англ. domain shift). Это подчёркивает актуальность подходов, учитывающих локальные особенности данных, прозрачную интерпретируемость и возможность масштабируемой адаптации к условиям практического здравоохранения.
Главной задачей разрабатываемой системы является автоматизированное определение степени тяжести ДР по изображениям, полученным с фундус-камеры. Для решения этой задачи были рассмотрены два принципиально разных подхода. Первый подход заключается в использовании end-to-end нейросетевого классификатора, который напрямую определяет стадию ДР на основании исходного снимка. Основным преимуществом этого подхода является его технологическая простота и ускоренное внедрение. Однако очевидным недостатком данного подхода является ограниченная интерпретируемость результатов его работы. Модель функционирует как «черный ящик», что снижает доверие к ней со стороны клиницистов, а также затрудняет анализ ошибок. Второй подход декомпозирует задачу на 2 этапа: сначала выполняется сегментация ключевых признаков ДР (микроаневризмы, кровоизлияния, экссудаты и др.), а затем на основе результатов сегментации стадия заболевания определяется с помощью экспертных правил. Такой подход обеспечивает максимальную прозрачность и интерпретируемость, позволяя визуализировать и объяснить, какие именно признаки повлияли на итоговое решение системы.
Поскольку процесс аннотации исходных данных для решения задачи сегментации требует существенно больше времени, а также на порядок сложнее, было принято решение о поэтапной разработке. На первом этапе реализуется система, основанная на нейросетевой классификации степени тяжести ДР. Затем планируется расширение функционала за счет создания модуля, решающего задачу сегментации, и перехода к определению стадии заболевания на основе экспертных правил.
Для предобучения использовались открытые наборы EyePACS и APTOS [19], полученные на фундус-камерах Canon. В РФ распространены иные модели (Kowa, Visucam), что ведёт к различиям в параметрах изображений. Кроме того, в самих открытых данных ограничена согласованность разметки (каппа Коэна 0,71 [6]). Эти факторы вызывают резкое падение качества при прямом переносе модели: на нашем внутреннем наборе macro-F1 упала с 0,86 до 0,38.
Материалы и методы
В обучении использовались открытые (APTOS и EyePACS) и внутренний наборы данных ФГБУ «НМИЦ эндокринологии им. академика И.И. Дедова» Минздрава России (табл. 1).
Табл. 1. Характеристики открытых наборов данных
|
Название датасета |
Количество снимков |
Фундус-камера |
Разрешение снимков, сжатие JPEG |
|
APTOS-2019 |
3662 |
Canon CR-2 |
Минимальное: 358×474 Максимальное: 2848×4288 Медианное: 1536×2048 |
|
EyePACS |
35126 |
Canon CR-DGi, Canon CR-1 |
Минимальное: 289×433 Максимальное: 3456×5186 Медианное: 2582×3888 |
В обоих открытых наборах данных (EyePACS и APTOS) применяется единая пятиуровневая шкала для классификации стадий ДР:
-
• 0 – No DR (нет ДР);
-
• 1 – Mild (легкая непролиферативная ДР);
-
• 2 – Moderate (умеренная непролиферативная ДР);
-
• 3 – Severe (тяжелая непролиферативная ДР);
-
• 4 – Proliferative DR (пролиферативная ДР).
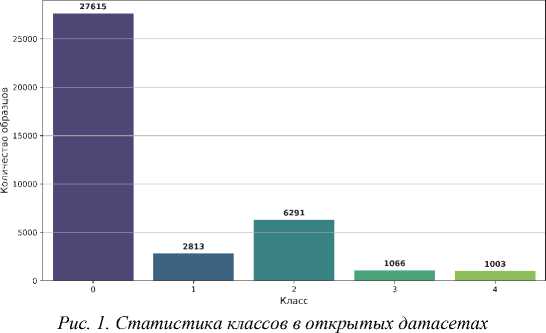
Важно упомянуть то, что изображения из открытых наборов данных были соединены в единый набор и заново стратифицированы на обучающую, валидационную и тестовую подвыборки без учета исходного разделения, предусмотренного в соревнованиях Kaggle. Итоговая стратификация представлена на рис. 1.
Во внутреннем же датасете используется разделение из атласа ДР [20] на следующие стадии:
-
• 0 – отсутствие ДР;
-
• 1 – непролиферативная стадия ДР;
-
• 2 – препролиферативная ДР;
-
• 3 – пролиферативная ДР;
-
• 4 – непригодная фотография (фотография, на которой невозможно оценить стадию ДР из-за её качества).
Распределение классов в объединённом датасете
Внутренний набор исходных данных включал около 13 000 снимков глазного дна с привязкой к уникальному идентификатору пациента. Изображения были получены с помощью фундус-камеры VISUCAM 524 (ZEISS) c 24-мегапиксельной матрицей в разрешении 3608×3608. Исходный набор данных включал изображения, содержащие только один цветовой канал, и многопольные снимки, полученные при объединении изображений отдельных полей глазного дна. В ходе предварительной фильтрации эти изображения были удалены из общего набора, для аннотации осталось около 8 тыс. фотографий. Для достижения более равномерного распределения классов в итоговом датасете с целью дальнейшего аннотирования приоритетно отбирались снимки пациентов, у которых, согласно базе данных медицинской информационной системы, ранее были диагностированы редко встречающиеся стадии ДР. Также для повышения разнообразия пространства признаков количество снимков от одного пациента, включенных в датасет, было ограничено.
Всего в итоговом датасете было 1123 снимка. Распределение классов было следующим: 108 – отсутствие ретинопатии (9,6%), 452 – непролиферативная стадия (40,2%), 143 – препролиферативная стадия (12,7%), 322 – пролиферативная стадия (28,7%), 98 непригодных фотографий (8,7%).
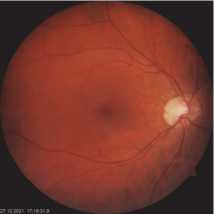
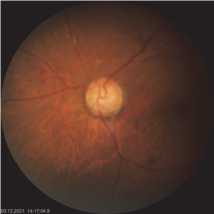
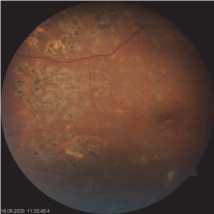
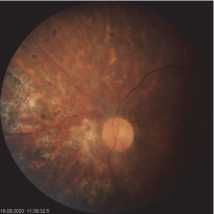
Рис. 2. Примеры изображений глазного дна на разных стадиях диабетической ретинопатии: а) здоровое глазное дно, б) непролиферативная стадия, в) препролиферативная стадия, г) пролиферативная стадия
Протокол аннотирования и оценка согласованности
Аннотирование изображений проходило в развернутом локально веб-приложении CVAT (Computer Vision Annotation Tool). В процессе аннотирования снимков принимало участие 3 врача-офтальмолога ФГБУ «НМИЦ эндокринологии им. академика И.И. Дедова» Минздрава России. Для дальнейших действий врачи были разделены на 2 группы, каждый специалист был «ослеплен», то есть не знал о том, какую стадию поставили его коллеги. Перед началом аннотирования каждому врачу была выдана инструкция, включавшая принятое в проекте разделение признаков ДР на глазном дне по классам и иллюстрированный атлас референс-снимков. Процесс разметки изображений строился по следующему протоколу. На первом этапе снимок параллельно назначался двум офтальмологам из разных групп. Если оценки стадии ДР совпадали, данная стадия сохранялась в наборе данных. В случае расхождения снимок назначался третьему специалисту для получения дополнительной оценки. Оценка третьего врача считалась решающей. Если же оценки всех трех специалистов различались, изображение выносилось на очные обсуждения для достижения коллективного консенсуса (рис. 4).
Распределение изображений по стадиям
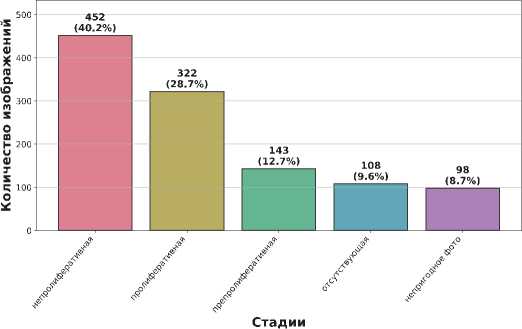
Рис. 3. Статистика классов во внутреннем наборе
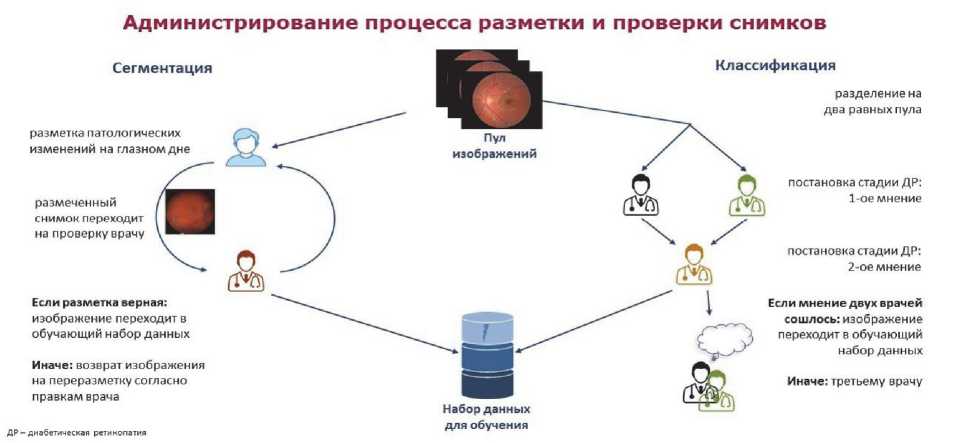
Рис. 4. Схема аннотации и валидации снимков в CVAT
Для количественной оценки качества и надежности разметки данных был проведен анализ внутренней и межэкспертной согласованности работы всех офтальмологов.
Каждый врач вслепую повторно аннотировал 50 изображений, случайным образом выбранных из ранее размеченного им же массива снимков, при этом офтальмологи не были проинформированы, что эти изображения они аннотируют повторно. Этот этап фундаментален для создания собственного набора данных, свободного от экспертной предвзятости и пригодного для воспроизводимого, надежного обучения. Степень внутренней и межэкспертной согласованности оценивалась с помощью коэффициента каппа Коэна.
Анализ внутренней согласованности заключался в повторном слепом аннотировании каждым из трех врачей-офтальмологов выборки из 50 изображений, которые они размечали ранее. Полученные значения показали достаточно серьезные проблемы в разметке и плохую повторяемость разметки экспертами: k 1 = 0,56; k 2 = 0,24; k 3 = 0,50.
Оценка межэкспертной согласованности проводилась на отдельной выборке из 100 снимков, которые были независимо размечены тремя специалистами. Результаты межэкспертной согласованности, так же как и внутренней согласованности, выявили серьезные проблемы в разметке: сильную субъективность экспертов при разметке и плохо составленные инструкции для размечающих специалистов. Значения для пар врачей составили: k 1=0,34; k 2=0,10; k 3=0,45.
Для повышения однородности и согласованности разметки были организованы коллективные обсуждения. На них анализировались случаи с максимальным расхождением в оценках (например, оценки специалистов различались более чем на одну стадию ДР). Целью обсуждения было выработать и формализовать единые, более строгие критерии аннотирования для повышения качества аннотирования изображений в дальнейшем.
Первые эксперименты по обучению модели показали, что классическое деление датасета на обучающую, валидационную и тестовую выборки при небольшом объеме данных приводит к сильному зашумлению на кривых обучения и затрудняет интерпретацию результатов. В связи с этим в финальной схеме датасет был разделен только на обучающую и валидационную выборки.
Архитектура модели и предобработка
Для увеличения вариативности набора данных и повышения обобщающей способности модели использовались стандартные аугментации: случайные повороты, вертикальные и горизонтальные отражения, эластичные деформации изображения. Реализация данных преобразований была основана на библиотеке Albumentations [21].
В качестве архитектурной основы для решения задачи классификации стадий ДР и последующего применения в качестве энкодера сегментирующей модели была выбрана EfficientNet-B0 [22]. Данная модель содержит 6,5 миллионов обучаемых параметров и является самой компактной в семействе EfficientNet. Такой выбор обусловлен минимизацией риска переобучения, возникающего при обучении более комплексных моделей на весьма ограниченном внутреннем наборе данных.
Обучение модели проводилось на сервере с графическим ускорителем NVIDIA RTX 4070 (12 Гб видеопамяти). При размере изображения 1024 x 1024 пикселя и размере обучающего батча, равном 16, среднее время прохождения одной эпохи дообучения составляло ~ 30 секунд. Данный показатель включает как этап инференса, так и этап обратного распространения ошибки. Важно отметить, что разрабатываемая система ориентирована на офлайн-обработку и не требует выполнения инференса в реальном времени, поэтому к вычислительным задержкам не предъявляются жесткие требования.
Протокол обучения и оценка качества
Процесс обучения модели был разделен на 2 этапа в соответствии со стратегией transfer learning. На первом этапе проводилось предварительное обучение модели на объединенном наборе открытых данных с инициализацией весов на базе ImageNet. Задачей данного этапа являлось научить модель выделять признаки, характерные для ДР.
Затем на внутреннем наборе выполнялось дообучение: последний полносвязный слой заменялся на новый (5 классов, инициализация Xavier [23]), веса остальных слоёв фиксировались, кроме нескольких последних, число которых подбиралось экспериментально.
На обоих этапах применялся оптимизатор AdamW и механизм ранней остановки (по значению loss на предобучении, по F1 на дообучении). Для компенсации дисбаланса классов использовался focal loss.
В связи с ограниченностью вычислительных ресурсов обучение проводилось на кропах изображений глазного дна, в то время как валидация результатов осуществлялась на полноразмерных изображениях. В результате экспериментов оптимальным было признано разрешение изображений 1024×1024 пикселя по критерию баланса между качеством и производительностью обучения. Размер батча составлял 2 на обучающей выборке и 1 – на валидационной.
В качестве основной метрики использовался macro-F1, так как он одинаково учитывает все классы и не завышает оценку за счёт часто встречающихся стадий.
Результаты и обсуждение
В результате проведённого обучения оптимальная версия модели EfficientNet-B0, дообученная на внутреннем наборе данных, продемонстрировала следующие показатели качества на валидационной выборке полноразмерных изображений глазного дна. Значение основной метрики качества – macro-F1-score – составило 0,63. Это свидетельствует об умеренной способности модели корректно классифицировать все стадии ДР. Однако результаты выявляют неравномерность качества предсказания по отдельным классам.
Табл. 2. Лучшие результаты обучения модели на валидационной выборке
|
Название класса |
F1-метрика |
Количество примеров в наборе данных |
|
Отсутствие ДР |
0,71 |
108 изображений |
|
Непролиферативная ДР |
0,77 |
452 изображения |
|
Препролиферативная ДР |
0,14 |
143 изображения |
|
Пролиферативная ДР |
0,70 |
322 изображения |
|
Непригодное изображение |
0,91 |
98 изображений |
|
Среднее для всех классов |
0,63 |
1123 изображения (302 пациента) |
Модель уверенно справилась с определением классов: «Отсутствие ДР», «Непролиферативная ДР», «Пролиферативная ДР», а также отлично отбраковывала снимки низкого качества («Непригодное изображение»). Однако на классе «Препролиферативная ДР» её F1-метрика оказалась крайне низкой. Основная причина, которую хочется выделить, – размытые диагностические границы препролиферативной стадии. По одиночному изображению характерные признаки данной стадии трудноотличимы от соседних стадий, что усиливает субъективность оценки характерных признаков и только усугубляет проблему выделения данной стадии ДР. Данная проблема неоднократно обсуждалась на клинических консилиумах, но чёткий консенсус так и не был достигнут, что напрямую отразилось на F1-метрике модели.
Для оценки эффективности предложенной двухэтапной стратегии проведено сравнение с базовыми подходами (baseline). Прямой перенос модели, обученной только на открытых данных, на внутренний набор дал macro-F1 = 0,38, что подтверждает выраженный domain shift. Обучение «с нуля» только на внутренних данных привело к переобучению и macro-F1 ≈ 0,61.
Дополнительные эксперименты показали, что обучение на подвыборках, размеченных лишь одним врачом, ухудшает обобщающую способность по сравнению с использованием согласованной разметки. Наилучший результат достигнут при обучении на 522 снимках с консенсусной оценкой; модели, обученные на 427, 319 и 285 снимках от отдельных специалистов, показали более низкие значения macro-F1 (рис. 5).
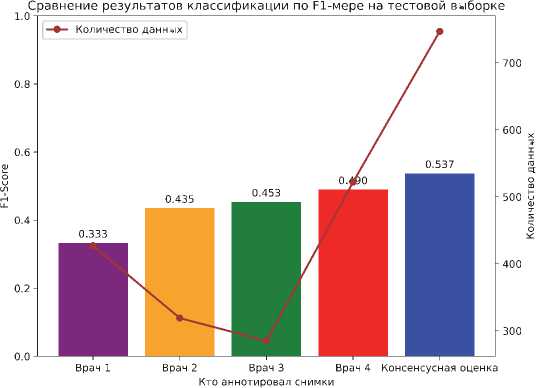
Рис. 5. График результатов моделей, обученных на отдельных выборках каждого размечающего врача
Заключение
В работе представлен полный цикл разработки и валидации системы автоматизированной классификации стадий ДР, адаптированной к условиям российской клинической практики. Научная новизна исследования заключается в реализации жесткого трехэтапного протокола слепого консенсусного аннотирования данных. Показано, что без применения данного подхода формирование эталонного набора данных на основе локальной выборки (1123 изображения) невозможно из-за высокой межэкспертной вариабельности и зашумленности разметки. Созданный датасет позволил реализовать двухэтапную стратегию трансферного обучения на архитектуре EfficientNet-B0, обеспечившую устойчивость модели к техническим особенностям оборудования.
Ключевым этапом работы стала оценка эффекта «смещения домена». При сравнении полученных результатов с коммерческими системами (IDx-DR, EyeArt) и отечественными прототипами (например, работы Нероева В.В. и соавт.), декларирующими чувствительность на уровне 85 – 92%, следует учитывать различия в условиях тестирования. Высокие метрики аналогов зачастую достигаются на гомогенных, предварительно отфильтрованных выборках. В то же время полученное значение macro-F1 является верифицированной оценкой работы системы в жестких условиях реальных снимков клинического потока с выраженным дисбалансом классов и вариативным качеством снимков. Таким образом, разработанное решение представляет собой валидированный инструмент, готовый к опытной эксплуатации для задач офлайн-скрининга.
В дальнейших работах планируется расширение датасета за счёт многоцентрового сбора снимков с редко встречающимися стадиями ДР, внедрение гибридной схемы «сегментация + экспертные правила» для повышения интерпретируемости, а также проведение клинического испытания в реальных условиях.
Таким образом, продемонстрировано, что сочетание открытых и локальных данных при строгом протоколе аннотации позволяет создать надёжный инструмент для скрининга ДР, адаптированный к техническим и клиническим условиям РФ.