
Нейросетевой подход в цифровом фенотипировании снопового материала гороха: от многоклассовой сегментации к специализированным моделям уточнения
Журнал: Инженерные технологии и системы @vestnik-mrsu
Рубрика: Технологии, машины и оборудование
Статья в выпуске: 3, 2026 года.
Бесплатный доступ
Введение. Цифровое фенотипирование сухого снопового материала гороха необходимо для ускорения селекционных работ в растениеводстве. Автоматический анализ таких образцов осложняется перекрытием органов, их низкой контрастностью, близкой окраской и экстремальным дисбалансом пикселей между морфологическими классами. Для решения проблемы предлагается каскадный нейросетевой подход, сочетающий многоклассовую семантическую сегментацию на кропах с последующим уточнением специализированной бинарной моделью слабопредставленного класса. Цель исследования. Разработка нейросетевого подхода для цифрового фенотипирования снопового материала гороха, основанного на последовательном применении семантической многоклассовой сегментации и специализированной бинарной модели уточнения для слабопредставленных морфологических органов. Материалы и методы. Исходный набор данных включал 162 изображения семи сортов гороха с ручной разметкой пяти классов (органов): фон, стебель, прилистник, боб и корень. Базовая U-Net архитектура с энкодером ResNet-34 обучалась на цельных изображениях и кропах размером 512x512 пикселей с использованием комбинированной функции потерь. Для корня дополнительно сформирована бинарная root-only модель с соответствующей функцией потерь и параметром pos_weight = 50, увеличивающим штраф за ошибки на положительном классе. Результаты исследования. Качество нейросетевой семантической многоклассовой сегментации в значительной степени определяется не только архитектурой модели, но и способом подготовки данных. При сохранении архитектуры U-Net переход от цельных изображений к кропам повысил средний IoU распознавания классов с 42,89 до 92,01 %. В то же время IoU миноритарного класса Root остался на уровне 30,63 %. Специализированная root-only модель показала рост Root IoU по классу Root до 88,46 %. Это подтверждает, что для слабо представленных и визуально сложных органов растения на изображениях целесообразно применять специализированную модель уточнения. Заключение. Увеличение числа эпох само по себе не устраняет влияние экстремального дисбаланса классов по пикселям. Наиболее результативным оказалось разделение общей и специализированной задач сегментации. Предложенный каскадный нейросетевой подход может быть использован как основа программного комплекса цифрового фенотипирования и адаптирован к другим культурам, для которых характерны малые, слабоконтрастные и редко представленные органы.
Короткий адрес: https://sciup.org/147255046
IDS: 147255046 | УДК: 63:633.358:004.9-045.64 | DOI: 10.15507/2658-4123.26363.518-540
A Neural Network Approach to Digital Phenotyping of Pea Sheaf Material: from Multi-Class Segmentation to Specialized Refinement Models
Introduction. Digital phenotyping of dried pea sheaf material is essential for accelerating breeding work in plant-growing. Automatic analysis of such samples is complicated by overlapping organs, low contrast, similar coloration, and extreme pixel imbalance between morphological classes. To solve this problem, there has been proposed a cascade neural network approach combining multi-class semantic segmentation on crops with subsequent refinement of underrepresented classes using a specialized binary model. Aim of the Study. The study is aimed at developing a neural network approach for digital phenotyping of pea sheaf material. This approach consists in the sequential application of semantic multi-class segmentation and a specialized binary refinement model for poorly represented morphological organs. Materials and Methods. The original dataset included 162 images of seven pea varieties, manually labeled into five classes (organs): background, stem, stipule, pod, and root. The baseline U-Net architecture with the ResNet-34 encoder was trained through using full images and 512x512 pixel crops with the use of a combined loss function. For the root, there was formed a binary root-only model with an appropriate loss function and a pos_weight parameter of 50, increasing the penalty for errors in the positive class. Results. The quality of neural network semantic multiclass segmentation is largely determined not only by the model architecture but also by the data preparation method. Maintaining the same U-Net architecture, the transition from whole images to cropped images increased the average class recognition IoU from 42.89 to 92.01%. Meanwhile, the IoU for the minority Root class remained at 30.63%. A specialized root-only model demonstrated an increase in Root IoU for the Root class to 88.46%. This confirms that a specialized refinement model is appropriate for poorly represented and visually complex plant organs in images. Conclusion. The obtained data show that increasing the number of epochs alone does not eliminate the impact of extreme class imbalance across pixels. Separating the general and specialized segmentation tasks is the most effective. The proposed cascade neural network approach can be used as the basis for a digital phenotyping software suite and adapted to other crops characterized by small, low-contrast, and sparsely represented organs.
Текст научной статьи Нейросетевой подход в цифровом фенотипировании снопового материала гороха: от многоклассовой сегментации к специализированным моделям уточнения
ТЕХНОЛОГИИ, МАШИНЫ И ОБОРУДОВАНИЕ / TECHNOLOGIES, MACHINERY AND EQUIPMENT
EDN: updates'" УДК / udk 63:633.358:004.9-045.64
Ufa, Russian Federation, bLLC «Titanium Digital», Ufa, Russian Federation
Цифровое фенотипирование растений является ключевым направлением развития современной аграрной науки, поскольку скорость получения генотипической и фенотипической информации существенно выше возможностей традиционных методов определения. Его связывают с использованием оптических сенсоров, автоматизированных платформ, компьютерного зрения и машинного обучения [1–3].
Горох посевной ( Pisum sativum L. ) – важная продовольственная и кормовая культура, играющая заметную роль в биологической фиксации азота. В селекции гороха ключевыми являются объективные оценки морфологических и продуктивных признаков, на основе которых ведется отбор перспективных образцов [4; 5]. Традиционный ручной учет (измерение длины стебля и корня, подсчет бобов и др.) требует значительных временных затрат и носит субъективный характер. Внедрение нейросетевых методов открывает путь к быстрому, воспроизводимому и точному цифровому фенотипированию.
Ранее предложенные алгоритмы компьютерного зрения подтвердили возможность автоматизации анализа гороха, но не обеспечили устойчивого выделения всех органов, прежде всего корня [6]. Особенно сложной является автоматизация анализа снопового материала. В отличие от живых растений, снимаемых в поле или в климатической камере, сухой сноп представляет собой деформированный объект, в котором органы растения частично перекрывают друг друга и имеют близкую окраску. При этом один образец должен рассматриваться как единая фенотипическая система: выделение только растения в целом не позволяет измерить длину отдельных органов, оценить их взаимное расположение и подготовить данные для автоматизированного морфометрического учета.
Цель исследования – разработка каскадного нейросетевого подхода, сочетающего многоклассовую семантическую сегментацию на кропах с последующим уточнением миноритарного класса специализированной бинарной моделью. Для достижения этой цели необходимо решить задачу по преодолению фундаментальной проблемы экстремального дисбаланса классов, характерную для сухих растений и не имеющую прямых аналогов в известных исследованиях по фенотипированию сноповых культур.
ОБЗОР ЛИТЕРАТУРЫ
Уровень развития цифрового фенотипирования рассматривается как ограничивающий фактор в повышении эффективности селекционных работ и биологических исследований [7–9]. Особое значение в цифровом фенотипировании имеет семантическая сегментация, которая позволяет каждый пиксель изображения отнести к определенному классу. Современные обзоры показывают ее применимость для распознавания культур, диагностики болезней, оценки листовой поверхности и продуктивности [10–12]. Однако большинство решений ориентировано на анализ сельскохозяйственных посевов и семенного материала по различным признакам [13; 14]. Так, даже при наличии развитых нейросетевых платформ существенными источниками ошибок остаются перекрытие органов растений, неоднородность съемки и ограниченность разметки [15–17].
Обзоры по сегментации растений систематизируют encoder-decoder-сети (ко-дировщик-декодировщик-сети), механизмы внимания, трансформеры и instance segmentation (сегментация экземпляров), одновременно отмечая зависимость качества распознавания классов от разметки, условий съемки и изменчивости морфологии [9; 10]. Платформа Deep Plant Phenomics и проведенные эксперименты зарубежных ученых показали высокую эффективность глубокого обучения для анализа побегов и корней, но преимущественно по контролируемым сценариям [17; 18].
Исследования отдельных органов подтверждают преимущества специализации. Оптические методы позволяют оценивать форму, размеры и свойства семян [13]. Система для кукурузных початков автоматизирует выделение и количественную оценку зерен [14]. Eff-UNet++ решает сегментацию и подсчет листьев [19]. Детально размеченные датасеты и сравнительное исследование разделения листьев способствовали объективному сопоставлению алгоритмов, однако выявлены устойчивые трудности при соприкосновении объектов и их перекрытии [15; 16].
Отечественные публикации демонстрируют практическую зрелость направления: разработана onboard-система детекции фитопатологий [11], семантическая сегментация поражений пшеницы [12], нейросетевая оценка содержания хлорофилла [20], облачный сервис выявления проблемных участков полей [21] и методы генерации синтетических данных для сегментации азотного режима [22]. Предшествующая работа по гороху [6] сформировала алгоритмическую основу цифрового фенотипирования, но задача надежного выделения корня в составе сухого снопа осталась нерешенной.
Наиболее близки к фенотипированию сухих сноп методы фенотипирования корневой системы. RootNav 2.0 автоматически восстанавливает архитектуру
^® ИНЖЕНЕРНЫЕ ТЕХНОЛОГИИ И СИСТЕМЫ Том 36, № 3. 2026 корней [23], а RootPainter сокращает объем разметки за счет корректирующего обучения [24]. При этом числовое сопоставление методов RootNav 2.0 и RootPainter невозможно без общих датасетов и единого протокола оценки. Обзоры также подчеркивают сложность топологии корней и получения эталонных данных [25; 26]. Однако такие методы обычно анализируют корень отдельно.
Автоматическая идентификация гербарных образцов подтверждает применимость глубоких сетей к сухому материалу, но относится к классификации изображения целиком [27]. Для гороха этого недостаточно, так как селекционная ценность культуры и вариабельность ее признаков требуют определения и измерения отдельных органов [4; 5].
Методическая основа статьи соответствует современным представлениям о сегментации. U-Net обеспечивает точную локализацию при ограниченном объеме данных [28], а остаточная архитектура ResNet эффективна как предварительно обученный энкодер [29]. Общие методы компенсации дисбаланса и функции потерь семейства Dice повышают чувствительность к редким областям [30; 31], но не гарантируют точного распознавания класса, который одновременно мал, тонок и визуально сходен с посторонними элементами.
Сравнение публикаций показывает, что одной из практически значимых и одновременно методически сложных задач является цифровое фенотипиро-вание снопового материала – целых растений, отобранных и высушенных для последующего учета. Научная проблема определяется сочетанием трех факторов: экстремального пиксельного дисбаланса, низкой контрастности органов растения и их перекрытия.
МАТЕРИАЛЫ И МЕТОДЫ
Объект исследования
В качестве объекта исследования принят сноповой материал гороха. Исходный набор данных (датасет) включал 162 изображения с размеченными вручную масками гороха. В датасет вошли изображения семи сортов: Aksakskiy usatiy, Kaban, Vizger, Alla, Gambit, Yaguar и Yuldash.
Методы, оборудование и процедура исследования
Разрабатываемая модель решала задачу распределения каждого пикселя изображения по классам: фон, стебель, прилистник, боб и корень. Изображения получали в сопоставимых лабораторных условиях. Растения размещали на светлом масштабном фоне с видимой размеченной заранее сеткой, что позволяло сохранять пространственную привязку для последующей морфометрии. В набор включали изображения с различимыми органами растения, достаточной четкостью и видимым масштабным ориентиром. Из анализа исключали снимки с критическим «смазом», отсутствием значимой части образца или с такими тенями и перекрытиями, при которых ручная идентификация органов становилась неоднозначной.
Ручная разметка выполнялась одним подготовленным человеком по единому протоколу с последующей визуальной проверкой цветных контрольных масок. Для снижения субъективности использовались: фиксированный порядок наложения классов, единое цветовое кодирование, проверка соответствия индексированных масок цветным маскам визуального контроля. При этом необходимость в межэкспертной согласованности отсутствовала.
При создании масок стебель наносился первым и располагался в нижнем слое. Поверх него наносились корень, прилистники и бобы. Такая последовательность выбрана из-за вероятности перекрытия крупной маской стебля остальных органов гороха.
Маски изображений формировались в двух вариантах: индексированная masks_id для обучения и цветная masks_color для визуальной проверки. Цвета выделяемых классов приведены к единому стандарту (табл. 1).
Т а б л и ц а 1
T a b l e 1
Классы и цветовое кодирование их масок Classes and color coding of their masks
|
ID (номер класса) / ID (class number) |
Название класса / Class name |
RGB (цветовое кодирование) / RGB (color coding) |
|
0 |
Фон / Background |
– |
|
1 |
Стебель / Stem |
255, 96, 55 (красно-оранжевый / red-orange) |
|
2 |
Прилистник / Stipule |
250, 50, 83 (неоновый розово-красный / neon pink-red) |
|
3 |
Боб / Pod |
45, 1, 255 (ультрамариновый ярко-синий / ultramarine bright blue) |
|
4 |
Корень / Root |
61, 61, 245 (глубокий ярко-синий / deep bright blue) |
Источник : таблицы 1–2 составлены авторами статьи.
Source : The tables 1–2 were compiled by the authors of the article.
Обучение модели выполнялось с использованием нейронной сети U-Net типа encoder-decoder (кодировщик-декодировщик), широко применяемой для решения задач по семантической сегментации изображений. Она позволяет не только определить объект на изображении, но и выделить его контур на уровне отдельных пикселей (каждому пикселю изображения присваивается соответствующий класс). Качество многоклассовой сегментации оценивалось по IoU (метрика пересечения к объединению, показывающая степень совпадения предсказанной и эталонной областей) без учета фона и по IoU каждого целевого класса.
В качестве энкодера использовалась сеть ResNet-34, рассматриваемая как часть модели и позволяющая извлекать из изображения соответствующие признаки (границы, текстуру, форму и другие визуальные особенности). Применение ResNet-34, предварительно обученной на наборе изображений ImageNet, позволило использовать уже сформированные низкоуровневые признаки на изображениях и благодаря этому ускорить обучение модели на малом количестве специализированных данных.
Комбинация U-Net + ResNet-34 выбрана как воспроизводимая и хорошо изученная базовая схема для задач семантической сегментации при ограниченном объеме размеченных данных, где важны точная локализация контуров и возможность использования признаков, предварительно сформированных на ImageNet. Более современные архитектуры, включая DeepLabV3+, SegFormer и трансфор-мерные модели компьютерного зрения, в данном исследовании не тестировались,
^® ИНЖЕНЕРНЫЕ ТЕХНОЛОГИИ И СИСТЕМЫ Том 36, № 3. 2026 поскольку их сравнение потребовало бы отдельного исследования с настройкой гиперпараметров, несколькими запусками и единым протоколом статистической оценки. Поэтому полученные выводы следует трактовать не как доказательство оптимальности U-Net + ResNet-34 среди всех возможных архитектур, а как подтверждение эффективности предложенной каскадной стратегии при выбранной базовой модели.
При обучении модели использовалась комбинированная функция потерь (математическая мера ошибки нейронной сети, которую оптимизатор минимизирует при обучении), включающая функции Dice Loss и Cross Entropy Loss. Dice Loss оценивает совпадение предсказанной маски с эталонной и полезна при решении задач сегментации, где важна форма выделяемой области. Cross Entropy Loss оценивает правильность классификации каждого отдельного пикселя по классам (была включена в состав функции потерь для повышения устойчивости обучения модели и дополнительного контроля классификации по пикселям).
Использовалась комбинация 0,7 · Dice Loss + 0,3 · Cross Entropy Loss. Больший удельный вес функция Dice Loss имела в связи с необходимостью получения правильной области органов растения.
Оптимизация параметров модели выполнялась с использованием алгоритма AdamW, который позволяет постепенно изменять вес классов так, чтобы уменьшить ошибку предсказаний. Начальная скорость обучения, определяемая параметром weight decay (является безразмерным и определяет величину изменения весов класса на каждом шаге оптимизации), составляла 1e-4 (т. е. 0,0001). Такая скорость выбрана для более стабильного изменения параметров модели. Использование параметра weight decay позволило дополнительно снизить риск переобучения. Наряду с этим применялся и планировщик ReduceLROnPlateau, уменьшающий скорость обучения, если качество распознавания на проверочной выборке перестает улучшаться.
РЕЗУЛЬТАТЫ ИССЛЕДОВАНИЯ
На первом этапе исследования модель обучалась на цельных изображениях. Разделение на обучающую (Train) и валидационную (Val) выборку цельных изображений выполнили в соотношении 80/20 (130 изображений в Train и 32 изображения в Val) с формированием датасета pea_dataset_unified. При формировании обучающей и валидационной выборок учитывался сортовой состав исходного набора данных, чтобы изображения семи сортов были представлены в обеих частях выборки. Выполнили 50 эпох (полных обучающих циклов) с определением величины IoU (рис. 1).
В связи с тем, что фон и стебель занимали большую часть изображения, модель быстро обучалась выделять именно стебель, тогда как бобы, прилистники и корень оставались плохо распознаваемыми. На лучшей 33 эпохе короткого прогона на цельных изображениях средний IoU (без учета фона) составил 39,63 %. При этом по стеблю IoU был равен 76,32 %, прилистникам – 19,63 %, бобам – 38,64 %, корню – 0 %.
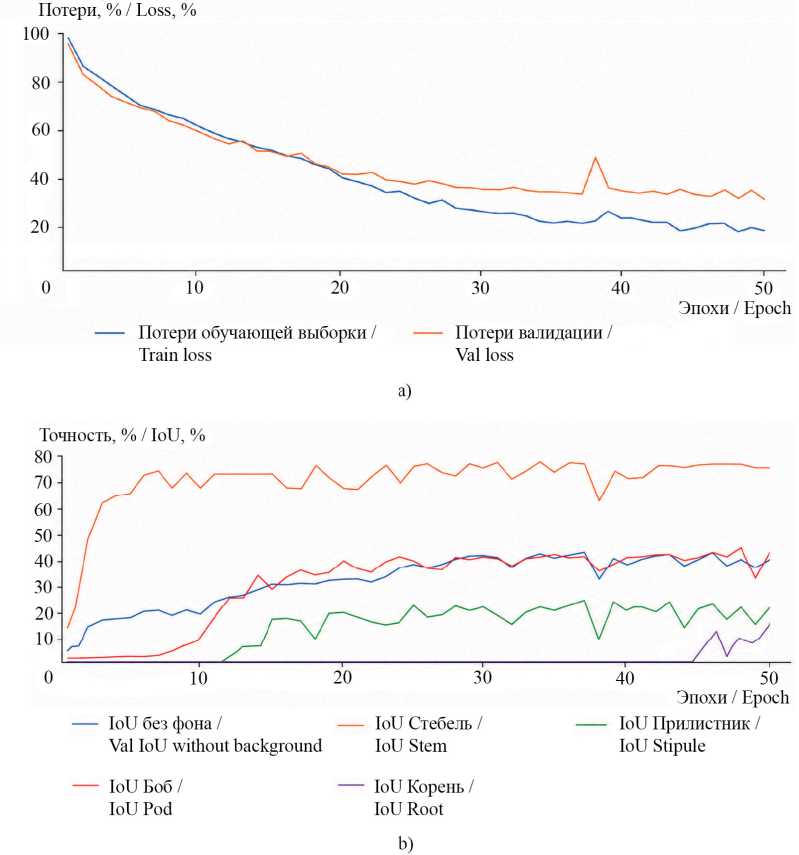
Р и с. 1. Динамика обучения модели на цельных изображениях (50 эпох): а) потери; b) точность
F i g. 1. Dynamics of model training on whole images (50 epoch): a) loss; b) IoU
Источник: рисунки 1, 2, 4, 6 составлены авторами статьи в программной среде Python с использованием библиотеки Matplotlib по результатам обучения нейронной сети.
Source: Figures 1, 2, 4, 6 were compiled by the authors of the article in the Python software environment using the Matplotlib library based on the results of neural network training.
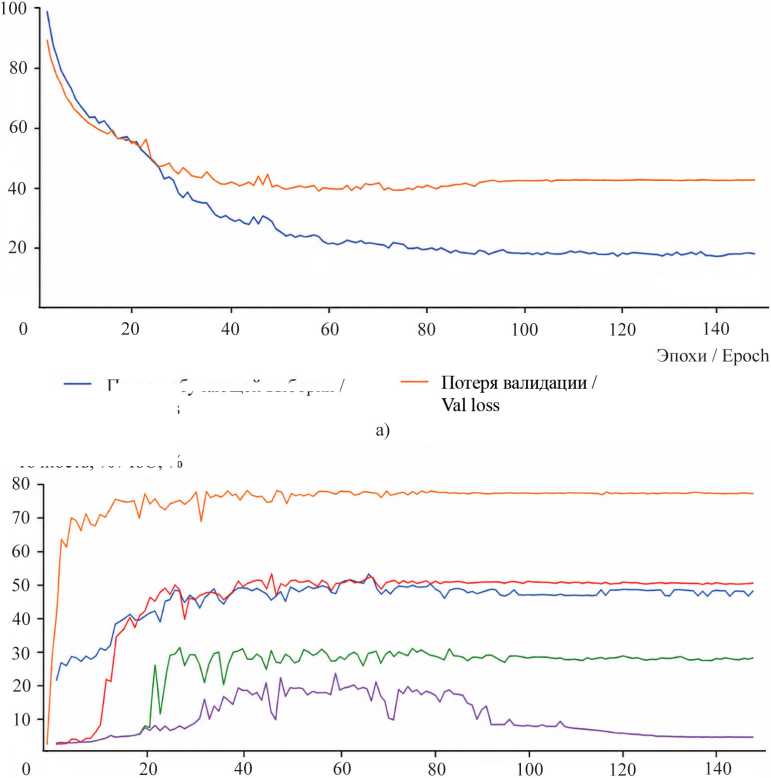
Из-за низкой точности распознавания органов гороха количество эпох было увеличено до 150. Динамика обучения модели показана на рисунке 2, а пример улучшения предсказаний по органам гороха на рисунке 3.
Потери, % / Loss, %
Потери обучающей выборки / Train loss
Точность, % / IoU, %
Эпохи / Epoch
— IoU валидация без фона / Vai IoU without background
IoU Стебель /
IoU Stem
--- IoU Прилистник / IoU Stipule
— IoU Боб / IoU Pod
— IoU Корень / IoU Root
b)
Р и с. 2. Динамика обучения модели на цельных изображениях (150 эпох): а) потери; b) точность F i g. 2. Dynamics of model training with whole images (150 epoch): a) loss; b) IoU
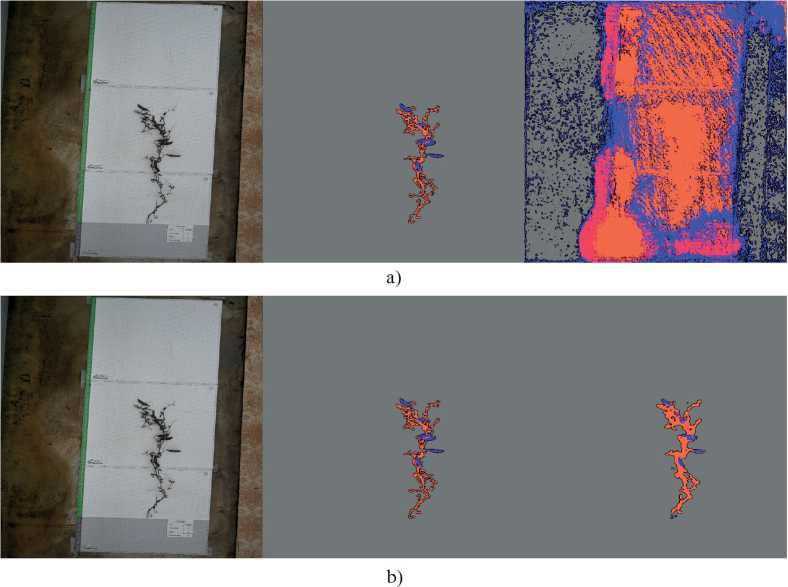
Р и с. 3. Визуализация результатов обучения модели на цельных изображениях (исходное изображение; маска, полученная разметкой вручную; маска, полученная обученной моделью): а) на начальном этапе; b) по результатам обучения на 150 эпохах
F i g. 3. Visualization of the results of model training with whole images (original image; mask obtained by manual labeling; mask obtained by the trained model): a) at the initial stage; b) based on the results of training with 150 epochs
Источник: рисунки 3, 5, 7 составлены авторами статьи в программной среде Python с использованием библиотек PyTorch, NumPy, OpenCV по результатам обучения нейронной сети.
Source: Figures 3, 5, 7 were compiled by the authors of the article in the Python software environment using the PyTorch, NumPy, and OpenCV libraries based on the results of neural network training.
Увеличение обучающих циклов до 150 повысило общий IoU. На лучшей 66 эпохе средний IoU (без учета фона) достиг 42,89 %, однако результат по корню остался низким (8,64 %). После этой эпохи началось переобучение модели.
Сложность в распределении пикселей по классам заключалась в сильном дисбалансе количества этих пикселей, относящихся к определенному классу. Это привело к низкой обучаемости модели по выделению мелких и редко встречающихся органов (миноритарных классов).
Низкая точность распознавания миноритарного класса Root связана с совокупностью факторов: занимает крайне малую долю пикселей и имеет тонкую форму; зачастую его контрастность близка к фону и визуально он может быть похож на тени, растительные остатки или тонкие фрагменты органов гороха.
В связи с относительно низкой точностью распознавания мелких органов исходные цельные изображения были разбиты на кропы (фрагмент исходного изображения фиксированного размера, используемый как отдельный обучающий пример) с формированием датасета pea_dataset_crops. Это позволило увеличить долю мелких органов гороха на кропах.
Размер кропа был выбран 512х512 пикселей. Из 162 исходных изображений было получено 13 726 кропов (разбивка осуществлялась со смещением на 384 пикселя, т. е. возникало перекрытие в 25 %). Такие размеры кропа и шаг смещения выбраны как компромисс между сохранением локального морфологического контекста и вычислительной нагрузкой. Перекрытие в 25 % уменьшало вероятность потери органа на границе кропов. В выборках Train использовалось 10 981 кроп, а Val – 745.
С учетом дисбаланса данных по классам их веса были выбраны эвристически. Для Cross Entropy Loss использовались веса классов [0,2; 1,5; 1,2; 1,4; 3,0], соответствующих (в последовательности) классам: фон, стебель, прилистник, боб и корень. Вес фона был уменьшен до 0,2, так как он занимал большую часть изображения и при равном весе с остальными классами мог доминировать в процессе обучения. Вес корня был увеличен до 3,0, поскольку он является наиболее редким и трудно выделяемым миноритарным классом. Для стебля, прилистников и бобов вес также был увеличен, так как они уступали фону по числу пикселей.
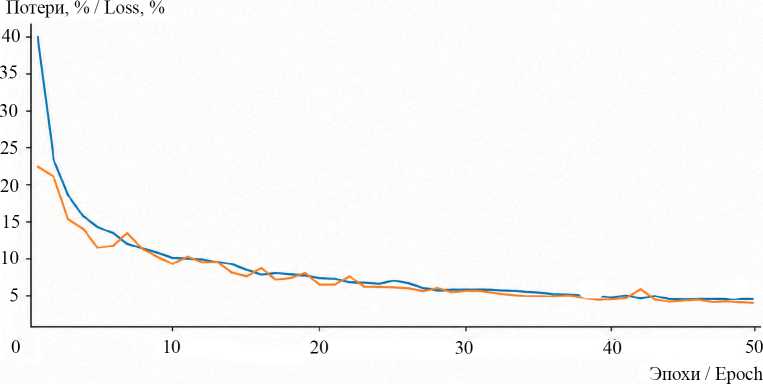
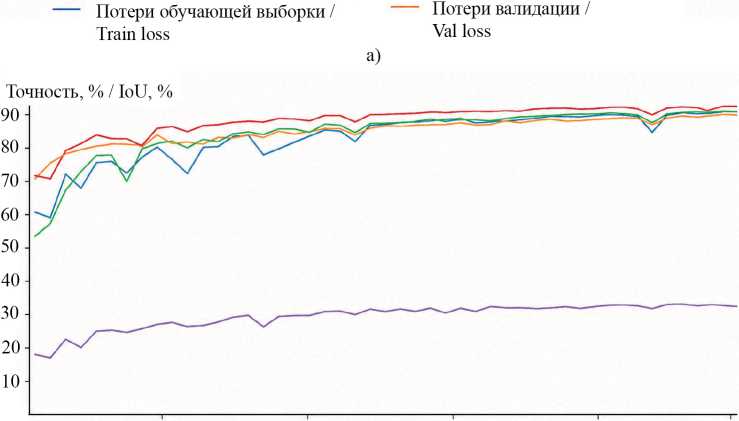
Результаты исследований представлены на рисунках 4 и 5.
Лучший результат по обучению модели на кропах получен на 50-й эпохе. Средняя точность IoU по классам (без учета фона) составила 92,01 %. По отдельным классам: Stem – 90,38 %, Stipule – 92,21 %, Pod – 93,90 %, Root – 30,63 %. По полученным результатам выявлено, что такие органы гороха, как стебель, прилистники и бобы определялись с высокой точностью, однако по корню результаты остались также на низком уровне.
В связи с относительно низкой точностью распознавания миноритарного класса Root был сформирован отдельный бинарный датасет pea_dataset_root_crops. В обучении использовалось 1 736 кропа (708 с наличием корня и 1 028 без него). В выборках Train использовалось 1 389 кропа, а в Val – 347.
Специальная бинарная модель root-only обучалась на двух классах: Root (класс 1) и Background/Not_Root (класс 0). Класс Background/Not_Root объединял фон, стебель, прилистники и бобы, а Root включал отдельно только корень. Это позволило модели сосредоточиться на поиске только класса Root. При этом выходной слой был изменен, и модель выдавала одну карту вероятности, показывающую, насколько каждый пиксель похож на корень.
В обучении использовалась бинарная функция потерь 0,55 • Dice Loss + + 0,45 · BCEWithLogitsLoss. Dice Loss отвечала за совпадение формы выделенной области корня с эталонной маской, а BCEWithLogitsLoss оценивала правильность бинарной классификации пикселей на два класса (корень и не корень).
|
0 10 |
20 30 40 50 Эпохи / Epoch |
— loU валидация без фона / — IoU Стебель / --- IoU Прилистник /
Vai IoU without background IoU Stem IoU Stipule
|
- IoUБоб/ IoU Pod |
— IoU Корень / IoU Root |
b)
Р и с. 4. Динамика обучения модели на кропах (50 эпох): а) потери; b) точность
F i g. 4. Dynamics of model training with crops (50 epoch): a) loss; b) IoU
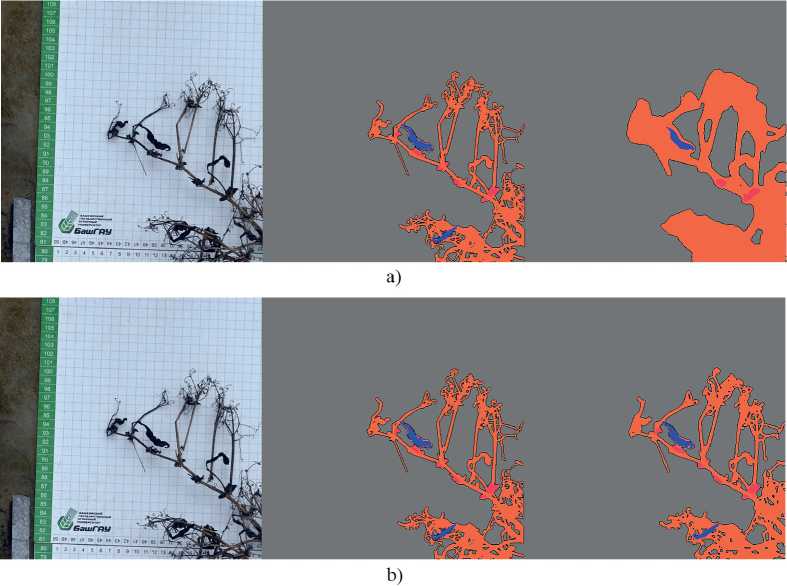
Р и с. 5. Визуализация результатов обучения модели на кропах (исходное изображение; маска, полученная разметкой вручную; маска, полученная обученной моделью): а) на начальном этапе; б) по результатам обучения на 50 эпохах
F i g. 5. Visualization of the results of model training with crops (original image; mask obtained by manual marking; mask obtained by the trained model): a) at the initial stage; b) based on the results of training on 50 epochs
Для компенсации малого количества пикселей корня был использован параметр pos_weight = 50. Он увеличивал штраф за ошибки на положительном классе (на пикселях корня). Это было необходимо в связи с тем, что даже после отбора root-only кропов доля пикселей корня на изображениях составляла не более 0,4 %. Без усиления положительного класса модель могла бы получить низкую точность распознавания (почти всегда относя пиксели к классу Background/Not_Root) и плохо находить сам корень.
Для root-only модели дополнительно рассчитывались Dice (метрика сходства масок, близкая по смыслу к IoU, но обычно принимающая более высокие значения), Precision (доля правильных пикселей среди всех пикселей, предсказанных как нужный класс) и Recall (доля найденных пикселей среди всех пикселей эталонного класса). Высокий Recall при низком Precision означает, что модель почти не пропускает корень, но ошибочно относит к нему лишние пиксели. Высокий Precision при низком Recall означает осторожную модель, которая редко ошибается, но пропускает часть корня.
Результаты обучения специализированной бинарной модели представлены на рисунках 6 и 7.
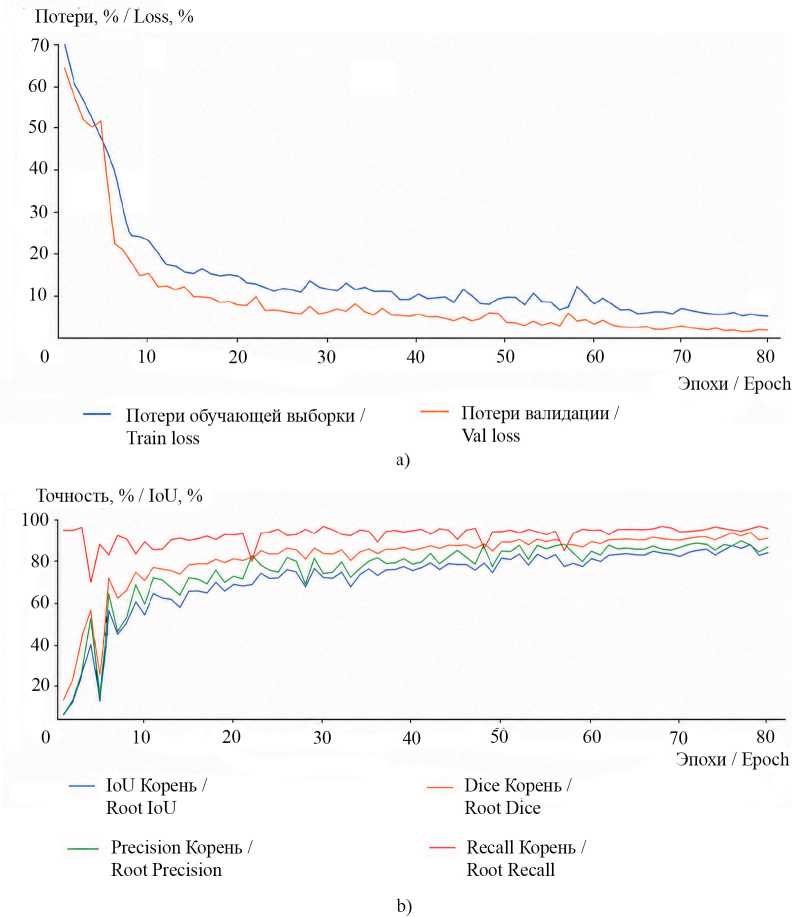
Р и с. 6. Динамика обучения специализированной root-only модели (80 эпох): а) потери; b) точность
F i g. 6. Dynamics of training a specialized root-only model (80 epoch): a) loss; b) IoU
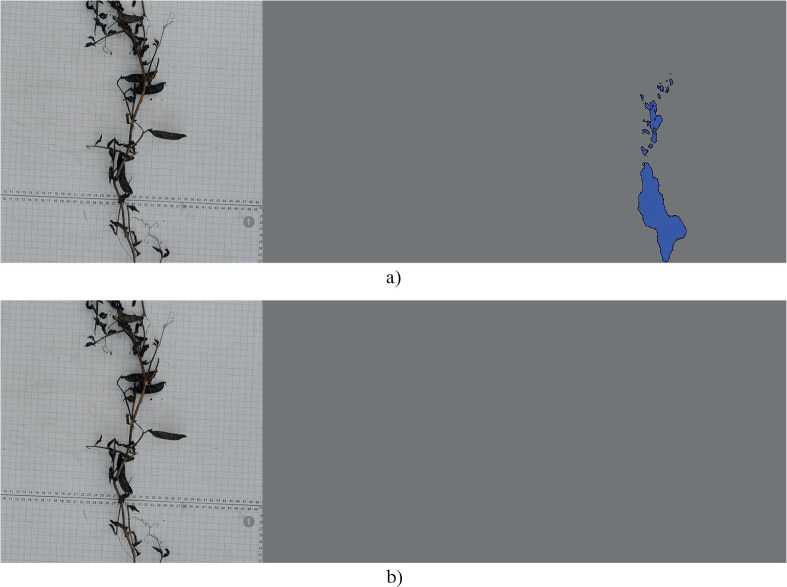
Р и с. 7. Визуализация результатов обучения root-only модели на кропах без наличия корня на изображении (исходное изображение; маска, полученная разметкой вручную; маска, полученная обученной моделью): а) на начальном этапе; б) по результатам обучения на 80 эпохах
F i g. 7. Visualization of the results of training a root-only model with crops without the presence of a root in the image (original image; mask obtained by manual labeling; mask obtained by the trained model): a) at the initial stage; b) based on the results of training with 80 epochs
По рисунку 7 видно, что на начальных этапах обучения модель ошибочно определяла класс Root, путая его с другими органами гороха. В процессе обучения точность определения корня возросла и ошибочное определение уменьшилось.
Root-only модель достигла лучшего результата к 78-й эпохе: Root IoU – 88,46 %, Dice – 93,85 %, Precision – 88,26 %, Recall – 95,50 %. Из них видно, что обученная модель смогла найти около 95,50 % пикселей, относящихся к классу корня, и при этом 88,26 % пикселей, предсказанных как корень, действительно относились к этому классу.
ОБСУЖДЕНИЕ
Проводимые экспериментальные исследования выполнялись при фиксированном разбиении данных и протоколе обучения (сравниваемые этапы выполнялись на одном наборе данных, при одной базовой архитектуре и единой логике оценки). Многократные независимые запуски модели с разными начальными условиями не проводились, стандартные отклонения метрик не определялись. Это ограничило статистическую оценку воспроизводимости абсолютных значений IoU, однако не 532 Технологии, машины и оборудование поменяло методический вывод о необходимости выделения корня в отдельную бинарную задачу. Обобщенные итоговые результаты экспериментальных исследований представлены в таблице 2.
Т а б л и ц а 2
T a b l e 2
Результаты обучения моделей по экспериментам Results of training models based on experiments
Эксперимент / Experiment
на цельных 50 эпох / изображениях / 50 epoch with whole 150 эпох / images 150 epoch на кропах (50 эпох) / on crops (50 epoch)
на root-only модели (80 эпох) / with root-only models (80 epoch)
|
Лучшая эпоха при обучении / The best epoch in learning |
Валида-ционная точность IoU, % / Val IoU, % |
Класс / Class |
|||
|
Стебель, % / Stem, % |
Прилистник, % / Stipule, % |
Боб, % / Pod, % |
Корень, % / Root, % |
||
|
33 |
39,63 |
76,32 |
19,63 |
38,64 |
0,00 |
|
66 |
42,89 |
76,92 |
19,29 |
41,91 |
8,64 |
|
50 |
92,01 |
90,38 |
92,21 |
93,90 |
30,63 |
|
78 |
88,46 |
– |
– |
– |
88,46 |
Полученные результаты показывают, что качество нейросетевой семантической многоклассовой сегментации в значительной степени определяется не только архитектурой модели, но и способом подготовки данных. При сохранении той же архитектуры U-Net переход от цельных изображений к кропам повысил средний IoU (без учета фона) с 42,89 до 92,01 %. Особенно заметен рост точности определения по бобам и прилистникам. В то же время корень остался «слабым» классом, что связано не только с его малой представленностью на изображении, но и с низкой визуальной выраженностью.
Специализированная root-only модель показала, что выделение проблемного класса в отдельную бинарную задачу может быть эффективнее, чем дальнейшее увеличение числа эпох обучения. Подобный подход особенно полезен в случаях, когда один из классов имеет резкий дисбаланс с другими классами, сложную форму и высокую вероятность схожести с другими органами.
Показательным является сравнение результатов сегментации по миноритарному классу Root. В общей модели на кропах IoU класса Root составил 30,63 %, тогда как в специализированной бинарной модели Root IoU достиг 88,46 % (прирост составил 57,83 %). Это подтверждает, что для слабо представленных и визуально сложных органов растения на изображениях целесообразно применять специализированную модель уточнения.
Предложенный подход рассматривается как сегментационный модуль программного комплекса цифрового фенотипирования, а не как полностью завершенная система селекционного учета. Практическое применение этих признаков в селекционном процессе требует отдельной проверки точности автоматических измерений по ручным эталонам.
Отдельно следует отметить ограниченную возможность семантической сегментации для задач подсчета отдельных объектов. Модель выделяет класс пикселей, но не различает отдельные экземпляры. К примеру, если два боба соприкасаются и формируют одну непрерывную область на маске, то постобработка по компонентам может посчитать их как один объект. Для предварительной оценки качества подсчета можно использовать число связных компонент, среднюю абсолютную ошибку подсчета объектов (MAE), относительную ошибку подсчета (MAPE), а также Precision, Recall и F1-score для объектов при сопоставлении автоматических и ручных экземпляров по порогу перекрытия IoU. Для гарантированного подсчета отдельных экземпляров в дальнейшем целесообразно рассмотреть instance segmentation, например, Mask R-CNN или YOLO-seg.
В рамках выполненной работы предложен и экспериментально апробирован нейросетевой подход для цифрового фенотипирования сухого снопового материала на примере гороха. В отличие от существующих решений, фокусирующихся на живых растениях или отдельных их органах, предлагаемый подход впервые реализует каскадный переход от многоклассовой сегментации к специализированной бинарной модели уточнения, что позволяет преодолеть характерное для сухих снопов сочетание пиксельного дисбаланса и низкой визуальной контрастности миноритарных органов.
Показано, что применение семантической многоклассовой сегментации на цельных изображениях снопового материала принципиально неспособно обеспечить полноценное фенотипирование: даже при 150 эпохах IoU класса Root не превысила 8,64 %, что обусловлено пиксельным дисбалансом и визуальной неразличимостью этого класса.
Разбивка изображений на кропы с эвристическим взвешиванием функции потерь является эффективной стратегией для многоклассовой сегментации основных органов гороха. Такой подход позволил получить средний IoU 92,01 % и достичь высокой точности по стеблю, прилистникам и бобам (IoU 90,38…93,90 %), однако, не решив проблему для корня (IoU 30,63 %).
Предложенный каскадный переход от многоклассовой модели к специализированной бинарной root-only модели уточнения является ключевым элементом подхода. Благодаря выделению корня в отдельную задачу определения на изображении и применению агрессивной компенсации дисбаланса (pos_weight = 50) удалось повысить точность сегментации класса Root до IoU 88,46 % при Recall 95,50 %, что практически применимо для количественной оценки в селекционном процессе.
ЗАКЛЮЧЕНИЕ
Комбинирование многоклассовой и бинарной моделей формирует единую детальную фенотипическую маску целого растения, пригодную для автоматического извлечения морфометрических признаков. Предложенный каскадный подход, включающий послойную разметку органов, обучение на кропах и специализированное уточнение, может рассматриваться как универсальная методология цифрового фенотипирования снопового материала культур с аналогичными проблемами дисбаланса и низкой контрастности.
Из результирующих масок планируется извлекать: длину стебля и корня после скелетизации и пересчета пикселей в физические единицы по масштабному ориентиру; площадь и периметр отдельных органов; число и суммарную площадь бобов; относительные показатели распределения органов в структуре растения. Эти признаки представляют интерес для последующего селекционного учета, однако их точность должна быть подтверждена сравнением с ручными измерениями с расчетом MAE, RMSE, коэффициентов корреляции и относительной ошибки.
Дальнейшее развитие работы предполагает объединение этапов в единый программный комплекс и переход к методам instance segmentation для прямого подсчета отдельных органов гороха, что позволит расширить возможности цифрового фенотипирования снопового материала.
