
Оптимизация протокола 5G RLC для высокоскоростной передачи данных с низкими задержками в сетях OpenRAN на платформе ARM
Рубрика: Информатика и вычислительная техника
Статья в выпуске: 3, 2026 года.
Бесплатный доступ
Обеспечение сверхнизких задержек и высокой пропускной способности на канальном уровне является критически важной задачей для реализации сценариев eMBB (Enhanced Mobile Broadband) и URLLC (Ultra-Reliable Low Latency Communications) в сетях мобильной связи. Существующие подходы к борьбе с чрезмерной буферизацией – алгоритмы активного управления очередями (AQM), архитектура L4S (Low Latency, Low Loss, Scalable throughput), стандартизированная в 3GPP Release 18, фокусируются исключительно на очередях, игнорируя задержки, возникающие в самой программной реализации протокола RLC (Radio Link Control). Это ограничение критически снижает их эффективность в декомпозированных архитектурах Open RAN с жесткими требованиями к задержке. В данной работе предложен комплекс методов оптимизации RLC: кольцевой буфер с ассоциативными списками сегментов, декомпозиция сущностей TX и RX с механизмом синхронизации и технология DPDK. Реализация выполнена с учетом архитектуры ARM Cortex-A72. Эксперименты на промышленной платформе NXP LX2160A (16 ядер Cortex-A72) с эмуляцией нагрузки до 4 пользовательских устройств и 4 распределенных блоков DU показали улучшение пропускной способности, снижение средней задержки в очереди и сокращение времени обработки пакетов. Предложенные решения могут быть адаптированы для отечественного оборудования 5G и перспективных сетей 6G.
Короткий адрес: https://sciup.org/148334280
IDS: 148334280 | УДК: 004.73:621.391+004.272.2 | DOI: 10.18137/RNU.V9187.26.03.P.130
Optimizing RLC for High-Throughput and Low-Latency Communication in Open RAN Deployments on ARM Architecture
Ensuring ultra-low latency and high throughput at the link layer is a critical task for implementing eMBB (Enhanced Mobile Broadband) and URLLC (Ultra-Reliable Low Latency Communications) scenarios in mobile networks. Existing approaches to combat bufferbloat-such as Active Queue Management (AQM) algorithms and the L4S (Low Latency, Low Loss, Scalable throughput) architecture standardized in 3GPP Release 18 focus exclusively on queues, ignoring delays originating within the software implementation of the RLC (Radio Link Control) protocol itself. This limitation critically reduces their effectiveness in decomposed Open RAN architectures with stringent latency requirements. This paper proposes a suite of RLC optimization methods: a ring buffer with associative segment lists, the decomposition of TX and RX entities with a synchronization mechanism, and DPDK technology. The implementation is tailored for the ARM Cortex-A72 architecture. Experiments on the industrial NXP LX2160A platform (16 Cortex-A72 cores), emulating loads of up to 4 UEs and 4 Distributed Units (DU), demonstrated improved throughput, reduced average queuing delay, and shorter packet processing times. The proposed solutions can be adapted for domestic 5G equipment and future 6G networks.
Текст научной статьи Оптимизация протокола 5G RLC для высокоскоростной передачи данных с низкими задержками в сетях OpenRAN на платформе ARM
Современные сети 5G переходят от проприетарных систем к открытым архитектурам Open RAN (O-RAN) [1]. Ключевой особенностью является разделение базовой станции
Вестник Российского нового университета
Серия «Сложные системы: модели, анализ и управление». 2026. № 3
на RU, DU и CU (Рисунок 1). Цель – повысить гибкость, снизить нагрузку между блоками и стоимость владения. Ключевым элементом канального уровня является протокол RLC, унаследованный от 4G и доработанный в 5G NR. Он отвечает за повторные передачи, сегментацию и управление SRB и DRB. В варианте разделения Open RAN 7.2x RLC исполняется в DU [2], становясь конечным протоколом на его стороне.
RLC должен удовлетворять требованиям uRLLC, eMBB и mMTC [3]. Задержка uRLLC и пропускная способность eMBB зависят от скорости обработки RLC. Задачу усложняет поддержка различных нумерологий, сокращающих время обработки до десятков микросекунд, а также наличие FDD, где передача и приём (UL) осуществляются одновременно.
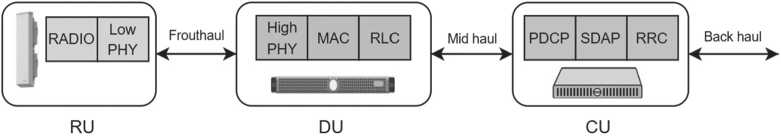
Рисунок 1. Архитектура Open Ran с функциональным разделением по опции 7,2х
Несмотря на заслуженную популярность открытого стека программного обеспечения 5G Open Air Interface (OAI) в исследовательских целях, его текущая реализация RLC требует адаптации под соответствие промышленным спецификациям 3GPP. Основными барьерами являются: использование медленных линейных структур данных, неоптимальная синхронизация потоков – общие блокировки для доступа к нисходящему (DL) и восходящему (UL) каналам, а также накладные расходы сетевого стека для передачи между блоками DU и CU. Данные факторы ограничивают предельную пропускную способность и ведут к росту задержек в канале, что особенно критично при развертывании на специализированных встраиваемых ARM-платформах, ориентированных на телеком-оборудование при работе с одновременно большим количеством пользовательских устройств.
Вопросам производительности открытых программных стеков 5G посвящено немало современных исследований. В работах коллектива под руководством Nikaein M. (Eurecom) заложены основы архитектуры OpenAirInterface [4; 5]. В первую очередь функциональная полнота протоколов и их соответствие стандартам 3GPP [6]. Проблематика задержек в архитектуре Open RAN поднимается в исследованиях [7; 8]. Авторы доказали, что для выполнения требований URLLC необходимо детерминированное исполнение функций DU, но конкретные методы оптимизации в этих работах не предлагаются. Вопросы применения технологии DPDK (Data Plane Development Kit) для ускорения обработки пакетов поднимаются в работе [9], где авторы демонстрируют его использование совместно с GPU для обработки уровня L1 в архитектуре O-RAN. Однако предложенные методы ориентированы на серверные платформы и не учитывают специфику реализации RLC на ARM-архитектурах. Отдельное направление составляют работы по использованию сетевого кодирования как альтернативы классическому ARQ. Такие работы демонстрируют потенциал для снижения задержек за счёт исключения повторных передач, однако требуют отхода от стандартов 3GPP и вносят дополнительную вычислительную нагрузку на абонентские терминалы при выполнении операций декодирования в полях Галуа [10].
Оптимизация протокола 5G RLC для высокоскоростной передачи данных с низкими задержками в сетях OpenRAN на платформе ARM
Таким образом, существующие работы либо анализируют проблемы, либо предлагают менять стандарты.
Цель настоящего исследования – комплексная оптимизация RLC для ARM-платформ с сохранением совместимости с 3GPP. Для достижения цели поставлены задачи:
-
• выявление узких мест OAI реализации;
-
• внедрение ассоциативных структур данных;
-
• реализация раздельных блокировок для DL и UL;
-
• интеграция DPDK с Zero-copy;
-
• исследование производительности и экспериментальное подтверждение на промышленной ARM-платформе.
Функции протокола RLC
Протокол RLC в стеке 5G находится между PDCP и MAC. Его основная задача – обеспечить надежную и своевременную передачу данных через радиоканал. В отличие от сетей 4G [11], где допускалась предварительная обработка пакетов, архитектура 5G NR требует сегментации SDU в реальном времени. Модуль RLC осуществляет сегментацию пакетов от PDCP в соответствии с размером транспортного блока (Grant), выделенного планировщиком gNB на MAC-уровне для конкретного TTI. Данный процесс критичен при использовании высоких нумерологий (SCS 60/120 кГц и более), где TTI сокращается до десятков микросекунд.
В соответствии с 3GPP TS 38.322 [6], определены три режима RLC:
-
• TM – простейший режим без заголовков, сегментации и обратной связи (для BCCH);
-
• UM – с заголовками и сегментацией, но без обратной связи (для голосового трафика);
-
• AM – дополнительно реализует ARQ, гарантируя доставку (для сигнальных сообщений).
RLC в режиме UM [6] представлен передающим (TX) и принимающим (RX) процессами. В режиме AM модель является единой двунаправленной сущностью с обратной связью через Control PDU (Status PDU – ACK/NACK). Выбор режима связан с типом радиоканалов (Radio Bearers): сигнальные (SRB), за исключением SRB0 (TM), используют только AM; пользовательские (DRB) могут использовать AM или UM.
В архитектуре O-RAN Split 7.2x RLC остается в составе DU (см. Рисунок 1), выполняя агрегацию трафика от CU через интерфейс F1-U [12]. Передача данных между CU и DU осуществляется по протоколу GTP-U поверх IP-стека [13]. Это создает требования к эффективной работе с сетевым стеком ОС и быстрому демультиплексированию. Ключевые параметры конфигурации RLC [14]: sn-FieldLength , t-Reassembly , а для AM – t-Poll Retransmit , t-Status Prohibit , poll PDU и poll Byte . Их настройка влияет на баланс между пропускной способностью, задержкой и надежностью доставки.
Анализ и методы оптимизации программного стенка RLC в Open Air Interface 5G.Методология исследования
Методология исследования, использованная в данном исследовании, включает оценку и анализ эффективности протокола NR RLC от Open Air Interface 5G с использованием
Вестник Российского нового университета
Серия «Сложные системы: модели, анализ и управление». 2026. № 3
аппаратной платформы NXP LX2160A (архитектура ARMv8). Для верификации результатов и оценки производительности были использованы следующие инструменты:
-
• Linux Perf для сбора аппаратно-поддерживаемых метрик производительности;
-
• Flame Graph для наглядной визуализации распределения времени выполнения.
Экспериментальный фреймворк и параметры настройки представлены детально для обеспечения понимания проведенных экспериментов и оценок.
Анализ реализации RLC в Open Air Interface 5G
Реализация протокола RLC в Open Air Interface 5G основана на классических подходах к реализации сетевых стеков, разработанных для обеспечения необходимой функциональности, и полностью соответствует спецификациям 3GPP [6; 14]. Архитектурно обработка данных разделена на две логические сущности: передающую (Transmitter, TX) и принимающую (Receiver, RX). Код написан универсально и подходит как для базовой станции, так и для пользовательского оборудования, что упрощает поддержку и верификацию.
Алгоритм обработки на передающей стороне (TX) для режимов с подтверждением (AM) и без подтверждения (UM) включает в себя следующие этапы (Рисунок 2).
-
1. Приём SDU от PDCP. Передающая сторона RLC получает SDU от вышестоящего протокола PDCP по заранее созданному радиоканалу с конкретным идентификатором через FIFO-очередь (First In First Out).
-
2. Выделяется память для хранения заголовка и данных; заранее заполняется заголовок RLC таким образом, будто пакет уже готов к отправке целиком без сегментации.
-
3. Подготовленная SDU буферизируется в TX в порядке FIFO.
-
4. MAC по готовности ресурсов запрашивает RLC выдать SDU из буфера с конкретным идентификатором. Далее заголовок RLC модифицируется: добавляется SN (Sequence Number), и по необходимости, если запрошенный размер данных из MAC меньше, чем размер SDU, данные сегментируются.
-
5. Только для случая RLC AM создается копия PDU и хранится в буфере, пока не будет принята ACK-квитанция.
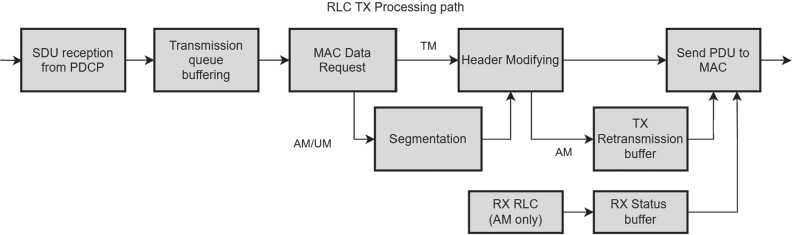
Рисунок 2. Путь обработки данных на передающей стороне RLC
Обработка принимающей стороны для AM/UM (Рисунок 3).
-
1. Приёмная сторона RLC получает PDU от MAC на конкретную сессию абонента Radio Bearer и начинает декодировать заголовок, извлекая SN, флаги сегментации и длину буфера.
-
2. Проверяется, что полученный SN находится внутри текущего окна приёма и здесь же отбрасываются дубликаты.
-
3. Сегменты собираются в один SDU.
-
4. Для RLC AM формируется STATUS PDU, содержащий информацию о принятых и потерянных сегментах данных.
-
5. Пакет отправляется на PDCP для дальнейшей обработки.
Оптимизация протокола 5G RLC для высокоскоростной передачи данных с низкими задержками в сетях OpenRAN на платформе ARM
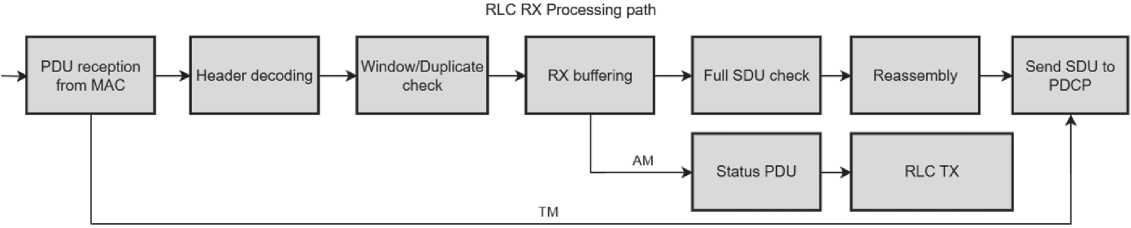
Рисунок 3. Путь обработки данных на принимающей стороне RLC
Основные операции RLC, такие как приём PDU, проверка полноты SDU, управление окнами приёма, требуют частого поиска элементов по SN. В текущей реализации для поиска PDU с определенным SN используется линейный обход списка (Рисунок 4), что имеет линейную сложность O ( n ), где n – количество элементов в списке. Помимо поиска для перечисленных функций выше вставка элемента в список для дальнейшей его обработки осуществляется по правилу сортировки «сначала по SN, а затем по SO внутри одного SN».
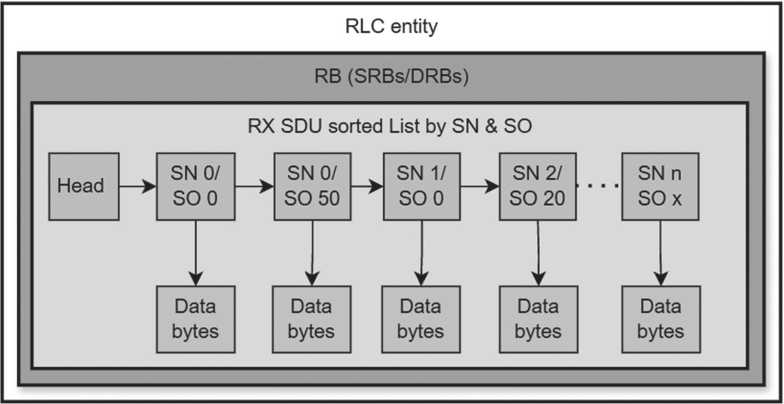
Рисунок 4. Текущая структура данных для хранения SDU в принимающей сущности RLC
