
Развитие инструментария методов потребительской оценки качества машиностроительной продукции на основе семантического поиска
Журнал: Известия Самарского научного центра Российской академии наук @izvestiya-ssc
Рубрика: Машиностроение и машиноведение
Статья в выпуске: 4 т.28, 2026 года.
Бесплатный доступ
В статье представлено развитие методов потребительской оценки качества машиностроительной продукции через инструментарий обработки обратной связи от потребителей машиностроительной продукции с использованием специализированного сервиса агрегации запросов по темам на основе семантического поиска. Описана диаграмма активности, отражающая путь обращения от неструктурированного сообщения до формализованной задачи в системе кодификаторов, включая этапы регистрации, хранения в централизованной базе, передачи в сервис агрегации, контекстной группировки и распределения по темам. Показано методическое значение выделенных этапов для разработки метода классификации неструктурированных запросов на доработку и формирования тематического классификатора, который может использоваться для аналитики, приоритизации и планирования развития продукта.
Короткий адрес: https://sciup.org/148334330
IDS: 148334330 | УДК: 621:658.562 | DOI: 10.37313/1990-5378-2026-28-4-88-93
The Process of Obtaining Feedback from Customers Using a Service for Aggregation of Requests on Themes Based On Semantic Search
The article presents the development of methods for consumer assessment of the quality of machinebuilding products through tools for processing feedback from consumers of machine-building products using a specialized query aggregation service based on semantic search. An activity diagram is described that refl ects the path of treatment from an unstructured message to a formalized task in the codifi er system, including the stages of registration, storage in a centralized database, transfer to an aggregation service, contextual grouping and distribution by topic. The methodological signifi cance of the selected stages for the development of a classifi cation method for unstructured refi nement requests and the formation of a thematic classifi er that can be used for analytics, prioritization and product development planning is shown.
Текст научной статьи Развитие инструментария методов потребительской оценки качества машиностроительной продукции на основе семантического поиска
EDN: GBSNNA
В условиях роста сложности продуктов и предприятий, растет и объём обращений потребителей машиностроительной продукции (далее – потребители). При этом обращения имеют разный характер и структуру, а также собираются производителями из разных каналов связи. Это приводит к тому, что большую часть обращений становится сложно обработать и формализовать. Предприятиям сложно полноценно оценить качество изделий, воспринимаемое потребителями.
Для решения этой задачи применяются различные инструменты для агрегации и тематизации неструктурированных запросов, в том числе с применением методов обработки естественного языка. Интеграция таких инструментов в существующий организационный процесс работы с обратной связью позволяет существенно снизить время обработки и оценки воспринимаемого качества продуктов [1, 2, 3].
В настоящей статье предлагается подход к классификации неструктурированных запросов на доработку, основанный на применении разработанного агрегатора обращений потребителей. В основе сервиса лежит алгоритм семантического поиска на базе нейронной сети. Также описана роль сервиса во внутренних процессах компании, интеграция с базой задач и процесс обработки обращений.
ОПИСАНИЕ ПРОЦЕССА ПОЛУЧЕНИЯ ОБРАТНОЙ СВЯЗИ ОТ ПОТРЕБИТЕЛЕЙ
Процесс начинается с получения обращений от нескольких потребителей, обозначенных на диаграмме как «Потребители 1..N». Это означает, что источников обратной связи несколько, и каждый из них может формировать запросы в собственном стиле, с разной степенью детализации, различной терминологией и неодинаковым уровнем формализации требований.
После поступления обращения начинается его первичная обработка, результатом которой становится регистрация задачи по обращению в базе задач. Иначе говоря, входным объектом процесса выступает неструктурированное сообщение от потребителя, а первым формализованным объектом — задача, зафиксированная в информационной системе.
Следующим этапом является сохранение задач в базе. На этом шаге обеспечивается накопление единого массива запросов, поступающих из разных источников, что создаёт основу для последующей автоматизированной или полуавтоматической обработки.
Далее задачи передаются в сервис агрегации, где выполняются загрузка задач из базы, агрегация по контексту и определение тем. Результатом данного этапа становится распределение задач по темам, то есть переход от набора отдельных обращений к те матически организованной структуре запросов.
На рисунке 1 изображена интерпретация диаграммы активности процесса получения и агрегации обратной связи по продукту. Процесс разделен на 7 этапов, которые в свою очередь разделены на 4 группы по областям, в которых происходят данные этапы. Диаграмма описывает путь от получения обратной связи от потребителя до регистрации задач для инженеров, при этом задачам присвоен код,
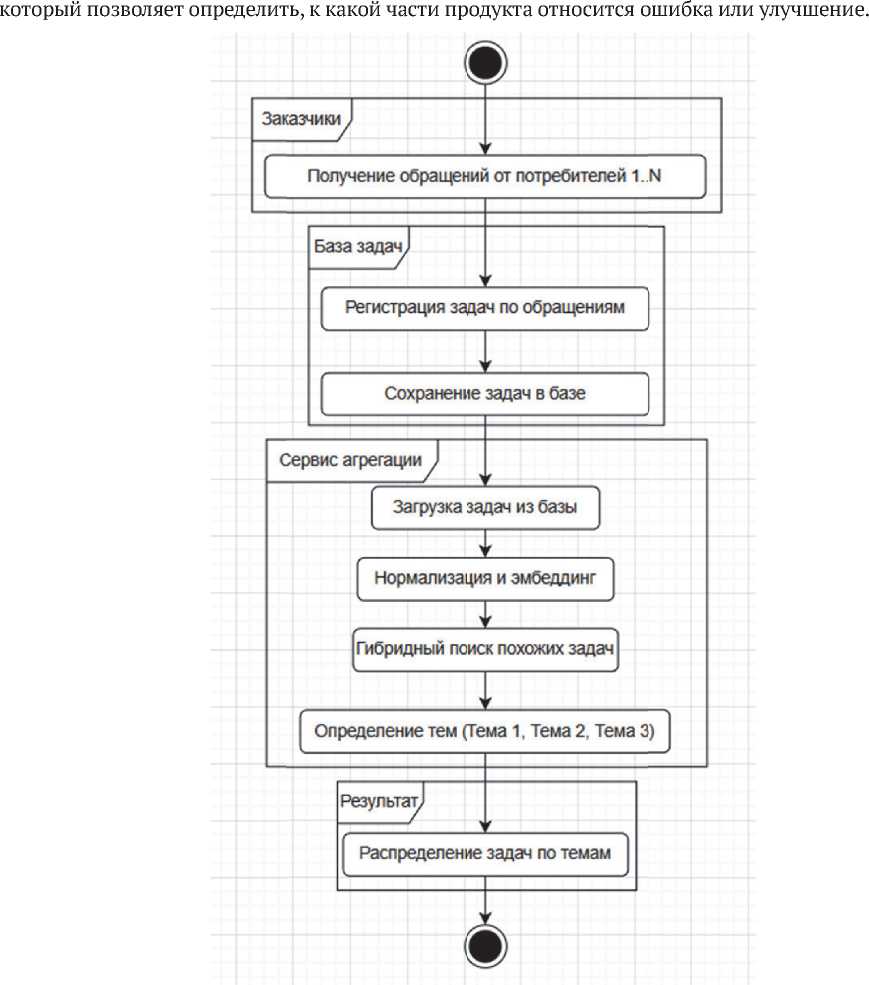
Рисунок 1. Диаграмма активности процесса получения и агрегации обратной связи по продукту от потребителя
Этап 1. Получение обратной связи от потребителей.
На первом этапе система получает обращения от потребителей. Под обращением в данном случае понимается любое сообщение, содержащее замечание, проблему, пожелание, предложение по улучшению, запрос на изменение функциональности или описание некорректной работы существующего решения.
Особенность этого этапа состоит в том, что запросы поступают в неструктурированном виде. Потребители могут использовать естественный язык, профессиональный жаргон, сокращения, внутренние обозначения, эмоциональные оценки, неполные формулировки и смешивать в одном сообщении несколько смысловых единиц.
Для задачи классификации это принципиально важно, поскольку исходные данные ещё не приведены к единому стандарту. Следовательно, уже на этапе получения обращений необходимо предусмотреть механизмы фиксации текста обращения, сведений об авторе, канале поступления, времени регистрации и, при необходимости, дополнительных атрибутов, которые позже могут использоваться как признаки классификации.
На практике к таким атрибутам могут относиться: идентификатор потребителя; дата и время поступления запроса; канал коммуникации; исходный текст обращения; вложения или сопроводительные материалы; предварительная отметка о срочности или критичности.
Даже если эти реквизиты не показаны на диаграмме явно, они логически вытекают из этапа получения обращений и необходимы для обеспечения прослеживаемости дальнейшей обработки.
Этап 2. Регистрация задач по обращениям
После получения обращения выполняется регистрация задачи по обращению в базе задач. На этом этапе неструктурированный запрос переводится в форму учётной единицы, пригодной для хранения, поиска, сравнения и последующей аналитической обработки.
Регистрация задачи предполагает выделение из текста обращения минимально необходимой управленческой сущности. Иначе говоря, система или оператор должны зафиксировать, что именно требует рассмотрения: дефект, доработка, новый функциональный запрос, уточнение бизнес-правила, изменение интерфейса, интеграционная проблема или иной тип изменения.
С методической точки зрения этот этап особенно важен, так как именно здесь формируется связка между исходным текстом и структурированным представлением запроса. Если при регистрации задача описана слишком кратко, без сохранения первичного контекста, это ухудшает качество последующей классификации; если же сохраняются и исходный текст, и нормализованное описание, то появляется возможность сравнивать различные варианты представления одного и того же запроса.
На этапе регистрации целесообразно фиксировать: уникальный идентификатор задачи; заголовок задачи; исходный текст обращения; нормализованное описание сути запроса; сведения о потребителе-инициаторе; текущий статус обработки; предполагаемый тип запроса; служебные признаки для последующей маршрутизации и анализа.
Таким образом, регистрация задачи представляет собой промежуточный слой между свободной формой коммуникации и структурированной моделью данных. Именно этот слой позволяет перейти от простой фиксации обратной связи к её системному анализу.
Этап 3. Сохранение задач в базе
После регистрации задача сохраняется в базе задач. База в данном процессе выступает как центральное хранилище, обеспечивающее консолидацию всех поступивших запросов вне зависимости от потребителей, формата сообщения и времени поступления.
Значение этого этапа состоит не только в архивировании данных, но и в создании единого корпуса запросов для аналитической обработки. Для разработки метода классификации неструктурированных запросов наличие централизованной базы особенно важно, поскольку именно она позволяет формировать обучающие и тестовые выборки, выявлять повторяющиеся паттерны и анализировать динамику тематических групп.
В базе задачи должны храниться в таком виде, чтобы можно было: извлекать первичный текст обращения; сопоставлять похожие запросы; отслеживать историю изменения формулировок и статусов; выделять группы обращений по потребителям, продуктам, модулям или периодам; передавать накопленные данные в сервисы интеллектуальной обработки.
Следовательно, база задач в рассматриваемой модели является не просто операционным журналом, а источником данных для процедур тематической агрегации и классификации.
Этап 4. Загрузка задач из базы в сервис агрегации
После накопления задач в базе они передаются в сервис агрегации. На диаграмме этот этап представлен как загрузка задач из базы в специализированный сервис, выполняющий дальнейшую интеллектуальную обработку.
Функционально это означает выделение отдельного контура, в котором задачи рассматриваются не как единицы операционного учёта, а как объекты анализа. В сервис агрегации могут передаваться как полные тексты обращений, так и нормализованные описания, метаданные, идентификаторы потребителей, служебные признаки и исторические сведения, если они требуются для более точной группировки.
Разделение базы задач и сервиса агрегации методически оправдано. Оно позволяет отделить процессы транзакционного хранения и сопровождения задач от процессов аналитической обработки, классификации и тематического объединения.
Этап 5. Агрегация задач по контексту
Ключевым этапом всей схемы является агрегация задач по контексту. На этом шаге отдельные задачи анализируются с целью выявления их смысловой близости, принадлежности к общему предметному полю или связи с одной и той же проблемной областью.
Контекстная агрегация предполагает, что объединение выполняется не только по буквальному совпадению слов, но и по смыслу запроса. Например, разные потребители могут по-разному описывать одну и ту же проблему: один указывает на неудобство интерфейса, другой — на избыточное число действий, третий — на отсутствие нужной кнопки, однако все эти обращения могут относиться к одной теме, например к доработке пользовательского сценария.
Для исследования по классификации неструктурированных запросов именно этот этап представляет наибольшую научно-практическую ценность. Здесь может использоваться нормализация текста, выделение ключевых терминов, лемматизация, извлечение признаков, векторное представление текста, правила сопоставления с эталонными темами или модели машинного обучения для определения тематической близости запросов.
Содержательно контекстная агрегация решает несколько задач: уменьшает разрозненность входящих обращений; выявляет повторяющиеся и типовые запросы; отделяет единичные частные формулировки от устойчивых тематических групп; помогает перейти от уровня отдельных сообщений к уровню классов запросов; создаёт основу для присвоения кодов темам и формирования классификатора.
В результате выполнения данного этапа система получает не просто перечень задач, а более высокоуровневую структуру, в которой каждая задача рассматривается в связи с другими содержательно близкими запросами [4].
Этап 6. Определение тем и кодов
После агрегации по контексту выполняется определение тем. На диаграмме этот результат показан как выделение нескольких тем.
В прикладной постановке темы могут интерпретироваться как категории, рубрики, эпики, классы запросов или коды классификатора. Иначе говоря, каждая выявленная тематическая группа получает формальное обозначение, позволяющее использовать её в процессах учёта, приоритезации, аналитики и планирования доработок.
Для темы «Разработка метода классификации неструктурированных запросов на доработку» этот этап означает завершение перехода от неструктурированного текста к формализованной категории. Если тема снабжается кодом, например кодом функционального блока, типа проблемы или бизнес-направления, то становится возможной автоматизированная маркировка новых запросов на основании ранее сформированного классификатора.
На практике определение тем может включать: выбор наименования темы; присвоение кода теме; описание критериев отнесения задачи к теме; установление связи темы с модулем, подсистемой или бизнес-процессом; уточнение уровня обобщения, например тема, подтема, подтип запроса.
Таким образом, тема выступает как результат смыслового обобщения множества индивидуальных обращений. Код темы, в свою очередь, превращает это обобщение в машиночитаемый и управляемый классификационный признак [3].
Этап 7. Распределение задач по темам
Завершающим этапом процесса является распределение задач по темам. Это означает, что каждая зарегистрированная и обработанная задача получает принадлежность к одной из выявленных тематических групп, а при необходимости — к нескольким группам, если модель допускает многоклассовую или многометочную классификацию.
Результат распределения имеет как практическое, так и исследовательское значение. С практической точки зрения организация получает структурированную картину входящих доработок; с исследовательской — формируется размеченный массив данных, пригодный для оценки качества классификации, обучения моделей и анализа точности тематического отнесения.
После распределения задач по темам становится возможным: анализировать наиболее частые направления запросов; выявлять проблемные зоны продукта; оценивать нагрузку по классам доработок; находить дублирующиеся или почти идентичные обращения; строить отчётность по темам, группам потребителей и периодам; использовать накопленную разметку для автоматической классификации новых обращений.
Именно на этом этапе процесс, отражённый на диаграмме, приобретает непосредственную связь с задачей разработки метода классификации. Диаграмма показывает не просто маршрут прохождения запроса, а последовательность преобразований, в которой неструктурированная обратная связь последовательно превращается в классифицированный объект, включённый в тематическую систему.
МЕТОДИЧЕСКОЕ ЗНАЧЕНИЕ ПРОЦЕССА ДЛЯ ИССЛЕДОВАНИЯ.ВЫВОДЫ ДЛЯ ПОСТАНОВКИ ЗАДАЧИ КЛАССИФИКАЦИИ
Рассматриваемая диаграмма активности может быть интерпретирована как концептуальная модель предметной области исследования. Она показывает, какие сущности участвуют в обработке запросов, в какой последовательности выполняются действия и на каком этапе возникает возможность для классификации неструктурированных текстов.
С научно-методической точки зрения описанный процесс позволяет обосновать архитектуру метода классификации. На вход метода поступает неструктурированный текст обращения, промежуточным объектом служит зарегистрированная задача с набором атрибутов, а выходом является тематическая принадлежность, выраженная в виде темы или кода [5].
На основании диаграммы активности можно сделать вывод, что задача классификации неструктурированных запросов встроена в более широкий организационный процесс обработки обратной связи от потребителей. Следовательно, разрабатываемый метод должен учитывать не только текст обращения как таковой, но и этапы его регистрации, хранения, передачи в сервис агрегации и последующего тематического распределения.
В прикладном смысле исследуемый метод должен обеспечивать решение следующих задач: принимать текст обращения в свободной форме; выделять или сохранять его ключевой контекст; сопоставлять запрос с уже известными тематическими группами; присваивать запросу тему или код; обеспечивать возможность накопления и уточнения классификатора по мере роста базы задач.
Таким образом, диаграмма активности задаёт логическую рамку для разработки метода классификации запросов на доработку. Она показывает движение от обратной связи потребителей к структурированному тематическому представлению запросов и тем самым служит основанием для формализации требований к алгоритмам агрегации и классификации.
