
Выявление сетевых атак на устройства интернета вещей методами понижения размерности
Журнал: Инфокоммуникационные технологии @ikt-psuti
Рубрика: Электромагнитная совместимость и безопасность оборудования
Статья в выпуске: 1 (93) т.24, 2026 года.
Бесплатный доступ
Все больше современных бытовых устройств становятся «умными» путем оснащения сенсорами, контроллерами и сетевыми картами для подключения к домашним и производственным сетям. «Умные» вещи могут значительно улучшить условия жизни и работы пользователей за счет повышения безопасности, экономии энергоресурсов и облегчения взаимодействия с ними, что особенно актуально для пожилых людей и людей с ограниченными возможностями. Однако повсеместное распространение устройств Интернета вещей значительно повышает риски, связанные с утечками персональных данных и сведений о частной жизни. Это напрямую связано с тем, что производители «умных» устройств для их удешевления часто пренебрегают мерами, обеспечивающими их высокую степень защиты от сетевых атак. Несмотря на большое число научных работ, посвященных безопасности Интернета вещей, только в небольшом числе из них уделяется достаточно внимания практической реализации мер по выявлению широкого спектра сетевых атак и сравнительному анализу наиболее пригодных для этого методов. Данная работа отчасти служит для восполнения этого недостатка, в ней рассматривается использование нескольких методов понижения размерности для выявления популярных ботнет атак на устройства Интернета вещей.
Короткий адрес: https://sciup.org/140316419
IDS: 140316419 | УДК: 004.852 | DOI: 10.18469/ikt.2026.24.1.10
Network attack detection on devices of Internet of Things using dimensionality reduction methods
Constantly increasing numbers of everyday devices are becoming smart by being equipped with sensors, controllers and network cards. The smart devices can be connected to home or production computer networks to improve their control, accessibility, security and energy efficiency. That is especially important for elderly people and individuals with disabilities. However smart thing deployment comes with significant drawbacks, including privacy risks and cybersecurity threats. The main reason behind this is that manufacturers often omit critical security features to reduce prices for their devices. Despite a lot of studies in the cybersecurity field there is limited practical analysis for detection of wide range network attacks on smart devices with various suitable methods. This research addresses this deficiency by comparison of several dimensionality reduction methods for detection of some popular network botnet attacks.
Текст научной статьи Выявление сетевых атак на устройства интернета вещей методами понижения размерности
В повседневной жизни нас все больше и больше окружают «умные» вещи, способные обмениваться данными по сети Интернет: умные колонки, часы, термометры, IP-камеры, дистанционные переключатели, системы управления микроклиматом, сигнализации и множество других подобных устройств, являющихся компонентами так называемого Интернета вещей (Internet of Things, IoT). «Умные» вещи являются удобной мишенью для проведения разнообразных сетевых атак, поскольку производители часто уделяют недостаточное внимание средствам защиты программного обеспечения и аппаратной части таких устройств. Главная причина этого состоит в ограниченности вычислительных ресурсов микроконтроллеров, лежащих в основе большинства «умных» вещей, увеличение которых может приводить к значительному их удорожанию. Кроме того, зачастую конечные пользователи IoT-устройств не знакомы в необходимой мере с требованиями сетевой безопасности и не используют какие-либо меры по их защите. В качестве примера этого можно привести оставление логина и пароля по умолчанию, как указано в заводских настройках или использование легко угадываемых их значений [1, 2].
Наиболее известным примером успешного проведения атак на устройства Интернета вещей является ботнет Mirai, основными целями которого становились IP-камеры и домашние марш- рутизаторы. Ботнет непрерывно сканировал в Интернете IP-адреса IoT-устройств и использовал для их взлома набор из 60 значений логинов и паролей по умолчанию, часто применяемых производителями «умных» устройств. После взлома на IoT-устройства устанавливалось вредоносное программное обеспечение, и они продолжали функционировать в нормальном режиме, что не позволяло оперативно выявить их заражение [1].
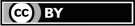
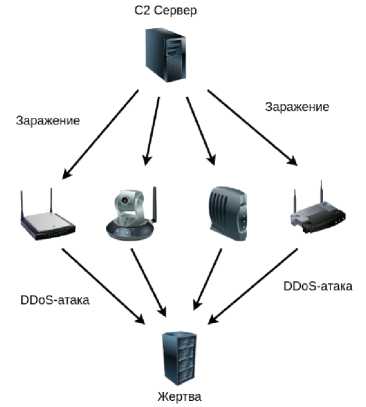
Рисунок 1. Распространение ботнета Mirai
Единственным признаком инфицирования IoT-устройств было повышенное использование пропускной способности подключения к Интернету, поскольку взломанные устройства по указаниям C2-сервера выполняли различные виды сетевых атак на устройства-жертвы. По разным оценкам на 2016 год в мире насчитывалось более 560 тысяч устройств, уязвимых для первой версии ботнета Mirai. Наиболее опасным видом атак, производимых Mirai, являются атаки распределенного отказа в обслуживании (Distributed Denial of Service, DDoS), так как, во-первых, из-за очень большого количества IoT-устройств их трафик сложно оперативно выявить и заблокировать, а во-вторых, общий трафик DDoS-атаки может достигать сотен Гбит/c и даже нескольких Тбит/c. Это крайне негативно может сказываться на доступности сайтов-жертв для обычных пользователей [2].
Ботнет Mirai наиболее часто производит следующие виды сетевых атак на IoT-устройства [1, 3]:
– взлом хостов грубой силой (host brute force);
– переполнения запросами HTTP (http flooding);
– переполнение дейтаграммами UDP (udp flooding);
– переполнение TCP-сегментами с флагом ACK (ack flooding).
Взлом хостов грубой силой выполняется в два этапа: на первом зараженное устройство сканирует сеть с помощью ARP-запросов для выявления активных IP-адресов, после чего, на втором этапе делаются попытки удаленного подключения по протоколу Telnet с наиболее частыми логинами и паролями из списка. В случае успеха данной атаки, контроль над устройством перехватывается и производится заражение устройства-жертвы вирусной программой, делающей жертву ботом.
Переполнение HTTP-запросами относится к DDoS-атакам, производимым на уровне приложений. Атака заключается в отправке на веб-сервер большого количества HTTP GET-запросов с множества зараженных ботнетом устройств с целью перегрузки сервера их обработкой, после чего сервер не сможет отвечать на запросы от легитимных источников.
Атака переполнения UDP-дейтаграммами выполняется на транспортном уровне и также относится к DDoS-атакам. Она состоит в отправке серверу большого числа поддельных UDP-дейтаграмм от ботов, со случайно заданными номерами портов и фальшивым IP-адресом источника. При нормальных условиях, получив UDP-дейтаграмму, сервер сначала проверяет наличие приложений ожидающих получений сообщений на этих портах, при отсутствии таковых сервер отправляет источнику ICMP-ответ о недоступности получателя. При очень большом количестве UDP-дейтаграмм вычислительные ресурсы сервера-жертвы будут полностью расходоваться их обработкой, делая невозможным обработку запросов от легальных источников.
Целью DDoS-атаки переполнения TCP-сегментами с флагом ACK также является перегрузка сервера-жертвы на транспортном уровне фальшивыми пакетами для предотвращения обработки легитимных сообщений. TCP-сегмент с флагом ACK служит для подтверждения получения сегментов, отправленных сервером, и выглядит идентично легальным сегментам, что делает атаку данного типа весьма сложной для распознавания и предотвращения.
В связи с простотой реализации и общими небольшими затратами наблюдается постоянный рост ботнетов и произведенных ими DDoS-атак. Можно выделить следующие основные меры защиты против Mirai и аналогичных ботнетов, направленных на взлом IoT-устройств:
– предотвращение использования логинов и паролей по умолчанию;
– принудительная установка сложно угадываемых логинов и паролей;
– своевременное обновление программного обеспечения IoT-устройств для устранения всех выявленных уязвимостей;
– мониторинг IoT-устройств в реальном времени для отслеживания любых изменений в их работе;
– мониторинг в реальном времени трафика IoT-устройств для выявления сетевых атак;
– на основе данных мониторинга создание профилей «умных» вещей, что позволит системам отслеживания состояния и трафика оперативно сигнализировать о возможных нарушениях в их работе.
На данный момент имеется достаточное количество научных работ, посвященных выявлению сетевых атак на «умные» устройства [3–7]. Однако в большинстве таких работ основное внимание уделяется только одному методу выявления на ограниченном наборе сетевых атак. Ценность настоящей научной работы заключается в практическом анализе эффективности сразу нескольких методов понижения размерности для выявления на широком наборе данных сетевых атак.
Способы выявления сетевых атак
Для выявления сетевых атак разработано большое количество различных техник, которые можно разделить на следующие группы [8]:
– на основе правил или сигнатур;
– статистические методы;
– методы машинного обучения.
В способах на основе правил трафик сетевых атак выявляется как несоответствующий определенным правилам (сигнатурам), которые заранее должны быть установлены и загружены в систему обнаружения вторжений. Преимуществом таких способов является простота реализации, их основной недостаток связан с необходимостью постоянного обновления большого актуального списка сигнатур.
В статистических методах на основе измерений параметров нормального сетевого трафика определяется его стохастическая модель, любые значительные отклонения трафика от характеристик модели считаются аномальными, что сигнализирует о проведении в эти моменты сетевых атак. В отличие от методов на основе правил, статистические методы не требуют постоянного обновления, однако более сложны в реализации, так как подбор подходящей стохастической модели часто затруднен на практике.
Методы машинного обучения подразделяют на методы обучения с учителем (supervised) и без учителя (unsupervised) [9–11].
В методах первого типа модель обучают на заранее размеченном наборе данных, который содержит как нормальный трафик, так и трафик сетевых атак. При обучении производится коррекция параметров модели с целью минимизации ошибки распознавания. Преимуществом методов обучения с учителем является то, что для построения модели может использоваться практически любой алгоритм классификации: k-ближайших соседей, деревьев принятия решений, опорных векторов или искусственных нейросетей. Главный недостаток применения таких методов на практике заключается в необходимости подготовки актуального размеченного набора данных для обучения модели, от качества которого напрямую зависит точность распознавания, что является достаточно сложным и дорогостоящим процессом.
В методах обучения без учителя для построения модели используются алгоритмы, способные самостоятельно структурировать каким-либо способом характерные признаки экземпляров в данных, что позволяет производить обучение моделей непосредственно на неразмеченных данных. Наиболее широко в методах данного типа применяются различные алгоритмы кластеризации и понижения размерности данных [9–11].
В алгоритмах кластеризации предполагается, что нормальные данные в пространстве призна- ков образуют единый кластер, а аномальные либо формируют отдельные кластеры, либо находятся на большом расстоянии от центра кластера нормальных данных. Использование алгоритмов кластеризации для обнаружения аномалий трафика затруднено на практике из-за необходимости заранее определять характеристики кластеров нормальных данных и вероятных отклонений аномальных экземпляров [9, 10].
Методы понижения размерности
Понижение размерности представляет собой преобразование исходных данных в пространство меньшей размерности, при этом должны сохраняться наиболее значимые их признаки. При обратном преобразовании в пространство исходной размерности, ошибка реконструкции аномальных данных будет существенно выше в сравнении с нормальными, что позволяет применять алгоритмы данного типа для эффективного выявления аномального трафика сетевых атак [9–12].
На практике используется достаточно большой набор методов понижения размерности, из которого можно выделить следующие наиболее популярные методы [9–12]:
– главных компонент;
– случайных проекций;
– автокодировщики;
– кластеризации.
В методе главных компонент (Principal Component Analysis, PCA) производится линейная трансформация данных в пространство с новой координатной системой, подобранной таким образом, чтобы направления ее осей (главных компонент) соответствовали направлениям наибольших вариаций в данных. Компоненты с небольшими вариациями просто отбрасываются, поскольку их общее влияние на вариации в данных незначительны [13].
Метод главных компонент можно выразить в матричном виде:
P=WTA, где A - матрица исходных данных, m х n ;
W – матрица преобразования главных компонент, n х n ;
P - проекция данных, m х n .
В полученной проекции P k столбцов содержат нулевые или исчезающе малые значения, которыми можно пренебречь. В результате получаем итоговую проекцию P`, размерностью m х ( n - k ) .
Матрица преобразования W может быть найдена различными способами: на основе матрицы ковариации данных, сингулярного разложения, с использованием функций ядра и др.
В основе применения случайных проекций для понижения данных лежит лемма Джонсо-на-Линденштрауса: точки в пространстве высокой размерности могут быть представлены в Евклидовом пространстве значительно меньшей размерности таким образом, что расстояния между ними сохраняются с незначительными отклонениями [13]. Такое преобразование описывается простым матричным выражением:
P=RA , где A - матрица исходных данных, m х n ;
R – матрица случайного преобразования, k х m ;
P - проекция данных, k х n .
Матрица случайного преобразования R может быть получена при помощи гауссовского распределения, соответствующего требованиям сферической симметрии и ортогональности. Очевидным преимуществом случайных проекций является простота реализации и низкая вычислительная сложность.
Автокодировщик (autoencoder) представляет собой искусственную нейронную сеть, у которой количество нейронов в скрытых слоях ( h ) не превышает число входных ( x ) и выходных ( y ) нейронов, рисунок 2 [11].
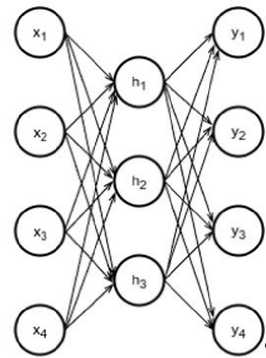
Рисунок 2. Схема автокодировщика
Автокодировщик обучают путем сравнения значений на его входах и выходах, полученная ошибка используется для коррекции значений нейронов в скрытых слоях. Поскольку скрытых нейронов меньше, чем входных и выходных, они обучаются сжатому представлению данных.
Для реализации автокодировщиков могут использоваться различные виды искусственных нейронных сетей, такие как многослойный персептрон (MultiLayer Perceptron, MLP), сверточная нейросеть (Convolutional Neural Network, CNN), рекуррентные нейросети (Recurrent Neural
Network, RNN). Преимуществами автокодировщиков является простота реализации, а недостатки связаны с высокими требованиями к вычислительным ресурсам в процессе обучения искусственных нейронных сетей.
Для понижения размерности данных могут применяться практически все методы кластеризации, однако для обнаружения аномалий пригодны только методы, допускающие обратную реконструкцию данных. Примером такого метода является агломеративная кластеризация по свойствам (Feature Agglomeration, FA). В данном методе вначале отбираются пары наиболее близких параметров данных, которые объединяются в кластеры, затем определяют наиболее близкие пары кластеров и т.д., до тех пор, пока не достигается заданное общее количество кластеров. В данном методе могут применяться различные критерии близости, например расстояние в евклидовом пространстве. Агломеративная кластеризация проста в реализации и предъявляет низкие требования к вычислительным ресурсам, когда общий размер данных не очень велик [15].
Критерии выявления сетевых атак
В методах понижения размерности чаще всего для оценки отклонений от нормальных значений используется усредненное значение среднеквадратической ошибки (Root Mean Squared Error, RMSE) [9, 10]:
n
RMSE = А -Ё(y-y')\ n i=1
где n – размерность данных; yi – исходное значение; y i ' - реконструированное значение.
Полученное значение RMSE сравнивается с пороговой величиной ф : если RMSE > ф , то рассматриваемый экземпляр данных считается аномальным отклонением.
Для общей оценки правильности классификации экземпляров из набора данных как нормальных или аномальных обычно используют такие параметры как точность и чувствительность.
Точность (Precision, P) – отношение числа экземпляров, верно отнесенных к аномальным (True Positive, TP), к общему числу экземпляров, отнесенных к аномалиям как верно, так и неверно (False Positive, FP):
P =
TP
TP + FP
Точность напрямую зависит от выбранного порога: чем выше пороговое значение, тем выше точность. Однако с увеличением порогового значения падает и общее число выявленных ано- мальных экземпляров, что снижает чувствительность метода.
Чувствительность (Recall, R) – отношение правильно выявленных аномалий к общему числу аномалий в данных, как выявленных, так и не выявленных (False Negative, FN):
R =
TP
TP + FN ’
Пороговое значение должно быть подобрано таким образом, чтобы обеспечивался баланс между точностью и чувствительностью. Для выбора оптимального порогового значения на практике часто применяется кривая зависимости точности от чувствительности [9, 10].
Для определения общей пригодности метода для решения данной задачи при разных пороговых значениях часто применяют такой интегрированный параметр как усредненная точность при различных пороговых значениях (Average Precision, AP):
AP = E ( R i - R i - i ) P i ,
i где Pi и Ri – точность и чувствительность для порогового значения (pi.
Общая оценка качества бинарной классифи- кации при разных пороговых значениях производится с помощью кривой рабочей характеристики приемника (Receiver Operating Curve, ROC), которая представляет собой зависимость доли правильно классифицированных экземпляров (True Positive Rate, TPR) или чувствительности от доли ошибочно классифицированных (False Positive Rate, FPR):
FPR =
FP
FP + TN
где FP – экземпляры, неправильно классифицированные как аномалии (False Positive);
TN – экземпляры, правильно классифицированные как неаномальные (True Negative, TN).
Чем более вытянутый вид к оси TPR имеет ROC-характеристика, тем лучше метод выполняет классификацию: идеальный классификатор имеет TPR = 1 и FRP = 0 .
Для сопоставления различных методов удобно использовать площадь области под рабочей характеристикой приемника (Area Under Curve, AUC). Для идеального классификатора значение AUC равно 1 [9].
Использованные данные
С целью исследования возможностей различных моделей машинного обучения по выявлению сетевых атак на устройства Интернета вещей были использованы данные, собранные исследо- вателями из Hacking and Countermeasure Research Lab [16]. Они представляют собой необработанные файлы пакетов, захваченных при проведении сетевых атак на два устройства умного дома: EZVIZ (Wi-Fi IP-камера) и SKT NUGU (умная колонка). Все устройства были подключены к общей беспроводной сети, захват пакетов производился напрямую беспроводным адаптером в режиме мониторинга.
В отдельном файле представлены нормальные пакеты, не содержащие злонамеренный трафик, остальные файлы содержат как нормальные пакеты, так и пакеты, сгенерированные для проведения сетевых атак.
В ходе моделирования проводились следующие виды сетевых атак:
– подделка ARP-ответов для проведения атаки «человек посередине» (ARP Spoofing);
– атака отказа в обслуживании за счет переполнения узла сегментами TCP с SYN-флагом (SYN Flooding);
– сканирование для определения портов программного обеспечения (ПО) и его версий (Scan Portos);
– сканирования для поиска узлов и портов ПО (Scan Hostport);
– атака ботнета Mirai по переполнению узла HTTP-запросами (Mirai Http Flooding);
– атака ботнета Mirai по взлому узла через Telnet (Mirai Host Bruteforce);
– атака ботнета Mirai путем отправки на узел сегментов TCP с флагом ACK (ACK Flooding).
Ряд атак проводился одновременно на оба IoT-устройства, а в ряде атак одно из IoT-устройств было целью, а второе выступало в качестве цели. Общий объем собранных данных составил примерно 1,5 Гбайт.
Результаты исследования
При проведении исследования проводилось обучение всех моделей на нормальных данных, не содержащих пакеты сетевых атак, затем производилась оценка моделей по выявлению сетевых атак на данных, содержащих как нормальные пакеты, так и пакеты атак. Для оценки были использованы две характеристики: усредненная точность (AP) и площадь области под кривой (AUC).
Для исследования были выбраны наиболее простые в реализации модели, поскольку они предъявляют наименьшие требования к вычислительным ресурсам, что актуально для устройств Интернета-вещей. Для выявления атак применялись модели:
|
– автокодировщик на основе двухслойной MLP-нейросети (AE); – метод главных компонент (PCA); – агломеративная кластеризация по свойствам (FA); – гауссовских случайных проекций (GRP). Программные коды по обработке исходных данных, а также всех моделей, представленные в AP ARP Spoofing 10 ---------- К / / / 1 0 6 —________ АЕ РСА FA GRP Методы Рисунок 3. Сравнение усредненной точности выявления атаки подделки ARP-ответов АР SYN Flooding 04 0.0J—----1---- к X Л М/—■' 1 / л X ф X ]— АЕ РСА FA GRP Методы Рисунок 5. Сравнение усредненной точности выявления атаки переполнения узла TCP-сегментами с флагом SYN АР Scan Portos 1.0 0.8 „ У^Жкм! лш АЕ РСА FA GRP Методы Рисунок 7. Сравнение усредненной точности выявления атаки сканирования портов ПО и его версий |
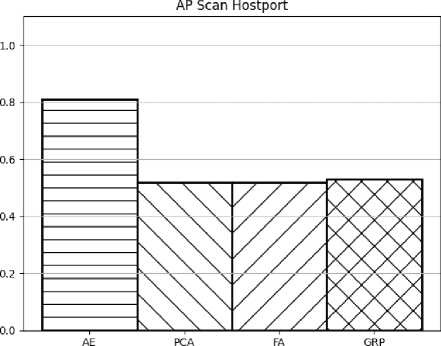
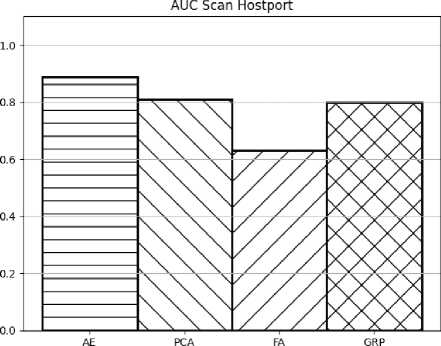
формате Jupyter Notebook, размещены в репозитории [17]. Примеры сравнения результатов усредненной точности и площади под кривой выявления сетевых атак использованными методами в форме столбчатых диаграмм приведены на рисунках 3–10. AUC ARP Spoofing 1.0 0.8— 0 4' X о.о J—----1----- К Л X J— АЕ РСА FA GRP Методы Рисунок 4. Сравнение площади под кривой выявления атаки подделки ARP-ответов AUC SYN Flooding 06 — -- 0.0 J-------т-------— АЕ РСА FA GRP Методы Рисунок 6. Сравнение площади под кривой выявления атаки переполнения узла ТСР-сегментами с флагом SYN AUC Scan Portos о.о J—-----,-----Ь— X X /1 X X X 1— АЕ РСА FA GRP Рисунок 8. Сравнение площади под кривой выявления атаки сканирования портов ПО и его версий |
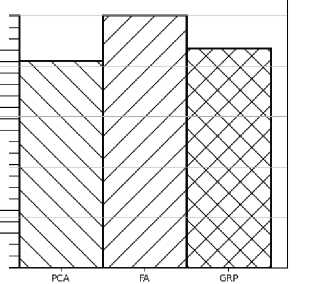
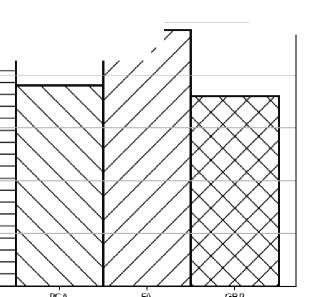
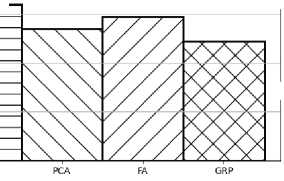
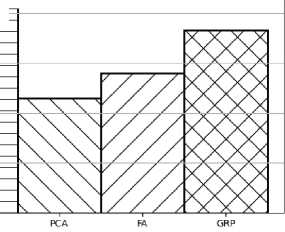
Методы
Рисунок 9. Сравнение усредненной точности выявления атаки сканирования для поиска узлов и портов ПО
Методы
Рисунок 10. Сравнение площади под кривой выявления атаки сканирования для поиска узлов и портов ПО
Заключение
Выполненное исследование показало, что наилучшие показатели по выявлению большинства сетевых атак на устройства Интернета вещей имеет простой автокодировщик на основе MLP-нейросети. В связи с этим данный метод можно рекомендовать к практическому применению для выявления сетевых атак, например в системах «умного дома».
Следует отметить, что автокодировщик обеспечивает хорошие показатели выявления атак, использующих уязвимости протоколов нижних уровней модели взаимодействия открытых систем, например TCP. Однако уровень выявления атак, производимых через протоколы прикладного уровня, например HTTP, достаточно низкий. В связи с этим, необходимо дополнительное исследование методов ориентированных на выявление данных видов сетевых атак, а также уделять повышенное внимание мерам по защите «умных» устройств от них.
