
Исследование методов распознавания эмоций человека на основе цифрового анализа изображений
Журнал: Advanced Engineering Research (Rostov-on-Don) @vestnik-donstu
Рубрика: Информатика, вычислительная техника и управление
Статья в выпуске: 3 т.26, 2026 года.
Бесплатный доступ
Введение. Распознавание базовых эмоций по изображению лица востребовано в мониторинге водителей, медицинских интерфейсах и образовательной аналитике. С июля 2024 года в ЕС такие системы стали нормативным требованием. Среди методических подходов в данной области нейросетевые архитектуры обеспечивают высокую точность, однако требуют значительных обучающих выборок и обладают низкой интерпретируемостью, что особенно важно для задач безопасности. Классические дескрипторы LBP и HOG, напротив, характеризуются вычислительной экономичностью и интерпретируемостью, однако в сопоставимых условиях изучены недостаточно: сохраняются вопросы об устойчивости их метрик при кросс-валидации на компактных наборах и о природе смешений визуально близких эмоций. В этом контексте предполагалось, что наблюдаемая в подобных протоколах близкая к идеальной точность HOG отражает утечку идентичностей субъектов между обучающей и тестовой выборками и тем самым завышает оценку обобщающей способности дескриптора. Цель исследования — оценить LBP и HOG на наборе данных JAFFE в едином воспроизводимом конвейере и определить границы их применимости. Материалы и методы. Для решения поставленных задач исследование организовано как сравнительное эмпирическое сопоставление преимуществ двух классических дескрипторов в рамках единого воспроизводимого протокола. В качестве экспериментальной базы использован открытый набор данных JAFFE (Lyons et al., 1998); 213 полутоновых изображений десяти испытуемых с семью базовыми эмоциями), а оценка качества классификации выполнялась по схеме стратифицированной пятикратной кросс-валидации. На этапе предварительной обработки изображения проходили нормализацию яркости (гистограммное выравнивание) и геометрическое выравнивание по опорным точкам лица. Затем на подготовленных кадрах извлекались дескрипторы LBP (текстура) и HOG (контурная геометрия), конкретные параметры которых детально приведены в тексте статьи. Полученные признаки подавались на вход линейного классификатора SVM, при этом параметр регуляризации подбирался по сетке {0,01; 0,1; 1; 10} в ходе внутренней трёхкратной кросс-валидации. Качество распознавания оценивали как среднее значение ± стандартное отклонение метрик Accuracy (точность) и Macro-F1 (макро-усредненная F1-мера) по результатам пяти внешних фолдов. Программная реализация всего конвейера выполнена на языке Python 3.10 (с использованием библиотек scikit-learn 1.3 и scikit-image 0.21). Результаты исследования. В ходе проведённого эксперимента метод HOG в сочетании с линейным SVM (support vector machine, метод опорных векторов) обеспечил полное разделение семи эмоциональных классов на наборе данных JAFFE в рамках выбранного стратифицированного протокола. При использовании того же алгоритмического порядка метод LBP продемонстрировал существенно более низкую точность и выявил специфическую структуру систематических смешений: устойчиво неразличимыми оказались пары «страх – удивление» и «грусть – нейтральное выражение», а распределение метрик по категориям количественно определило фундаментальные различия между контурным и текстурным признаковыми представлениями. Обсуждение. Полученные результаты свидетельствуют о решающем влиянии протокола разделения данных на итоговую оценку качества классических дескрипторов. В частности, идеальная разделимость признаков HOG объясняется сохранением идентичностей субъектов в обучающей и тестовой выборках, что полностью согласуется с известной чувствительностью градиентного профиля к индивидуальным особенностям лица. В отношении дескриптора LBP наблюдаемые значения точности попадают в диапазон, характерный для эталонной работы авторов Shan, Gong, McOwan. Однако структура ошибочных срабатываний, зафиксированная в настоящем исследовании, впервые детально интерпретирована посредством FACS-описания перекрывающихся наборов активных лицевых мышц, что ранее отсутствовало в опубликованных сравнительных обзорах. Заключение. В работе успешно решены задачи по сравнительной оценке методов LBP и HOG, построению полностью воспроизводимого программного конвейера и содержательной интерпретации ошибок автоматической классификации. На основе полученных эмпирических данных модель HOG в связке с линейным классификатором SVM признана целесообразной для лабораторных задач с фиксированным составом испытуемых, тогда как применение LBP в аналогичной комбинации оправдано в качестве компонента гибридных архитектур со сверточными или рекуррентными нейронными сетями. В прикладной плоскости выводы применимы при проектировании современных систем распознавания эмоциональных состояний для медицинских интерфейсов и систем мониторинга психофизиологического состояния водителя. Вместе с тем существенными ограничениями исследования являются малый объем набора данных JAFFE и строго лабораторные условия съёмки.
Короткий адрес: https://sciup.org/142248827
IDS: 142248827 | УДК: 004.93 | DOI: 10.23947/2687-1653-2026-26-3-2437
A Study of Human Emotion Recognition Methods Based on Digital Image Analysis
Introduction. The recognition of basic emotions from facial images is increasingly required in driver monitoring systems, medical user interfaces, and educational learning analytics. As of July 2024, such systems have been mandated by EU regulations. Among the methodological approaches in this area, neural-network architectures reach high accuracy but require large training samples and remain opaque, which is critical in safety applications. Classical descriptors LBP and HOG, in contrast, are computationally efficient and interpretable. However, their performance under comparable conditions remains underexplored: there are still questions regarding the stability of their metrics under cross-validation on compact datasets, as well as the nature of confusions between visually similar emotions. In this context, it was assumed that the near-perfect accuracy of HOG observed in such protocols reflected leakage of subject identities between the training and test sets, thereby overestimating the generalization ability of the descriptor. The objective of the study was to evaluate LBP and HOG on the JAFFE dataset in a single, reproducible pipeline, and determine the limits of their applicability. Materials and Methods. To address the stated tasks, the study was organized as a comparative empirical evaluation of two classical descriptors within a single reproducible protocol. The open JAFFE dataset (Lyons et al., 1998; 213 grayscale images of ten subjects with seven basic emotions) served as the experimental basis, with quality assessed under stratified five-fold cross-validation. The images underwent intensity normalization (histogram equalization) and geometric alignment by facial landmarks. Then, on the prepared frames, the LBP (texture) and HOG (contour geometry) descriptors were extracted, with specific parameters reported in the body of the article. The resulting features were fed to a linear SVM (support vector machine), with the regularization parameter tuned using a grid search over {0.01, 0.1, 1, 10} via internal three-fold cross-validation. Quality was assessed as the mean ± standard deviation of Accuracy and Macro-F1 metrics across five outer folds. The software implementation of the entire pipeline was done in Python 3.10 (using the scikit-learn 1.3 and scikit-image 0.21 libraries). Results. In the experiment, HOG combined with linear SVM provided complete separation of the seven emotional classes on the JAFFE dataset within the selected stratified protocol. Under the same algorithmic order, LBP showed significantly lower accuracy and revealed a specific structure of systematic confusion errors: the pairs “fear — surprise” and “sadness — neutral” provided consistently indistinguishable, while the category-wise distribution of metrics quantified the fundamental differences between contour and texture feature representations. Discussion. The results obtained indicate the decisive impact of the data splitting protocol on the final assessment of classical descriptors. Specifically, the perfect separability of HOG features is explained by preservation of subject identities across training and test sets, and is fully consistent with the known sensitivity of the gradient profile to individual facial features. With respect to LBP, the observed values fall within the range known from the reference work by Shan, Gong, and McOwan. However, the pattern of false positives documented in the present study is the first to be interpreted in detail through FACS description of overlapping sets of active facial muscles, which has previously been absent from published comparative reviews. Conclusion. The work has successfully solved the problems of comparative evaluation of LBP and HOG methods, construction of a fully reproducible software pipeline, and meaningful interpretation of automatic classification errors. Based on the data obtained, the HOG model combined with a linear SVM is suitable for laboratory tasks with a fixed set of subjects, whereas LBP in the same combination is justified as a component of hybrid architectures with convolutional or recurrent networks. In applied terms, the results can be used in the design of emotion recognition systems for medical interfaces and driver-monitoring systems. At the same time, the limitations of the work include the compact JAFFE dataset and the laboratory imaging conditions. Addressing these limitations, future work will involve moving to a more demanding protocol with full subject-out exclusion from the training set, as well as a comparative evaluation against current deep learning models.
Текст научной статьи Исследование методов распознавания эмоций человека на основе цифрового анализа изображений
Оригинальное эмпирическое исследование
Введение. Распознавание базовых эмоций по изображению лица востребовано в мониторинге водителей, медицинских интерфейсах и образовательной аналитике. С июля 2024 года в ЕС такие системы стали нормативным требованием. Среди методических подходов в данной области нейросетевые архитектуры обеспечивают высокую точность, однако требуют значительных обучающих выборок и обладают низкой интерпретируемостью, что особенно важно для задач безопасности. Классические дескрипторы LBP и HOG, напротив, характеризуются вычислительной экономичностью и интерпретируемостью, однако в сопоставимых условиях изучены недостаточно: сохраняются вопросы об устойчивости их метрик при кросс-валидации на компактных наборах и о природе смешений визуально близких эмоций. В этом контексте предполагалось, что наблюдаемая в подобных протоколах близкая к идеальной точность HOG отражает утечку идентичностей субъектов между обучающей и тестовой выборками и тем самым завышает оценку обобщающей способности дескриптора. Цель исследования — оценить LBP и HOG на наборе данных JAFFE в едином воспроизводимом конвейере и определить границы их применимости.
Материалы и методы. Для решения поставленных задач исследование организовано как сравнительное эмпирическое сопоставление преимуществ двух классических дескрипторов в рамках единого воспроизводимого протокола. В качестве экспериментальной базы использован открытый набор данных JAFFE (Lyons et al., 1998); 213 полутоновых изображений десяти испытуемых с семью базовыми эмоциями), а оценка качества классификации выполнялась по схеме стратифицированной пятикратной кросс-валидации. На этапе предварительной обработки изображения проходили нормализацию яркости (гистограммное выравнивание) и геометрическое выравнивание по опорным точкам лица. Затем на подготовленных кадрах извлекались дескрипторы LBP (текстура) и HOG (контурная геометрия), конкретные параметры которых детально приведены в тексте статьи. Полученные признаки подавались на вход линейного классификатора SVM, при этом параметр регуляризации подбирался по сетке {0,01; 0,1; 1; 10} в ходе внутренней трёхкратной кросс-валидации. Качество распознавания оценивали как среднее значение ± стандартное отклонение метрик Accuracy (точность) и Macro-F1 (макро-усредненная F1-мера) по результатам пяти внешних фолдов. Программная реализация всего конвейера выполнена на языке Python 3.10 (с использованием библиотек scikit-learn 1.3 и scikit-image 0.21).
Информатика, вычислительная техника и управление
Результаты исследования. В ходе проведённого эксперимента метод HOG в сочетании с линейным SVM (support vector machine, метод опорных векторов) обеспечил полное разделение семи эмоциональных классов на наборе данных JAFFE в рамках выбранного стратифицированного протокола. При использовании того же алгоритмического порядка метод LBP продемонстрировал существенно более низкую точность и выявил специфическую структуру систематических смешений: устойчиво неразличимыми оказались пары «страх – удивление» и «грусть – нейтральное выражение», а распределение метрик по категориям количественно определило фундаментальные различия между контурным и текстурным признаковыми представлениями.
Обсуждение. Полученные результаты свидетельствуют о решающем влиянии протокола разделения данных на итоговую оценку качества классических дескрипторов. В частности, идеальная разделимость признаков HOG объясняется сохранением идентичностей субъектов в обучающей и тестовой выборках, что полностью согласуется с известной чувствительностью градиентного профиля к индивидуальным особенностям лица. В отношении дескриптора LBP наблюдаемые значения точности попадают в диапазон, характерный для эталонной работы авторов Shan, Gong, McOwan. Однако структура ошибочных срабатываний, зафиксированная в настоящем исследовании, впервые детально интерпретирована посредством FACS-описания перекрывающихся наборов активных лицевых мышц, что ранее отсутствовало в опубликованных сравнительных обзорах.
Заключение. В работе успешно решены задачи по сравнительной оценке методов LBP и HOG, построению полностью воспроизводимого программного конвейера и содержательной интерпретации ошибок автоматической классификации. На основе полученных эмпирических данных модель HOG в связке с линейным классификатором SVM признана целесообразной для лабораторных задач с фиксированным составом испытуемых, тогда как применение LBP в аналогичной комбинации оправдано в качестве компонента гибридных архитектур со сверточными или рекуррентными нейронными сетями. В прикладной плоскости выводы применимы при проектировании современных систем распознавания эмоциональных состояний для медицинских интерфейсов и систем мониторинга психофизиологического состояния водителя. Вместе с тем существенными ограничениями исследования являются малый объем набора данных JAFFE и строго лабораторные условия съёмки. Преодоление данных факторов в дальнейших изысканиях предполагает переход к более сложному протоколу с полным исключением субъекта из обучающей выборки и проведение сопоставления с актуальными моделями глубокого обучения.
Original Empirical Research
A Study of Human Emotion Recognition Methods Based on Digital Image Analysis
Sergey A. Filichkin H , Sergey V. Vologdin ©
Kalashnikov Izhevsk State Technical University, Izhevsk, Russian Federation,
Introduction. The recognition of basic emotions from facial images is increasingly required in driver monitoring systems, medical user interfaces, and educational learning analytics. As of July 2024, such systems have been mandated by EU regulations. Among the methodological approaches in this area, neural-network architectures reach high accuracy but require large training samples and remain opaque, which is critical in safety applications . Classical descriptors LBP and HOG, in contrast, are computationally efficient and interpretable. However, their performance under comparable conditions remains underexplored: there are still questions regarding the stability of their metrics under cross-validation on compact datasets, as well as the nature of confusions between visually similar emotions. In this context, it was assumed that the near-perfect accuracy of HOG observed in such protocols reflected leakage of subject identities between the training and test sets, thereby overestimating the generalization ability of the descriptor. The objective of the study was to evaluate LBP and HOG on the JAFFE dataset in a single, reproducible pipeline, and determine the limits of their applicability.
Materials and Methods. To address the stated tasks, the study was organized as a comparative empirical evaluation of two classical descriptors within a single reproducible protocol. The open JAFFE dataset (Lyons et al., 1998; 213 grayscale images of ten subjects with seven basic emotions) served as the experimental basis, with quality assessed under stratified five-fold cross-validation. The images underwent intensity normalization (histogram equalization) and geometric alignment by facial landmarks. Then, on the prepared frames, the LBP (texture) and HOG (contour geometry) descriptors were extracted, with specific parameters reported in the body of the article. The resulting features were fed to a linear SVM (support vector machine), with the regularization parameter tuned using a grid search over {0.01, 0.1, 1, 10} via internal three-fold cross-validation. Quality was assessed as the mean ± standard deviation of Accuracy and Macro-F1 metrics across five outer folds. The software implementation of the entire pipeline was done in Python 3.10 (using the scikit-learn 1.3 and scikit-image 0.21 libraries).
Results. In the experiment, HOG combined with linear SVM provided complete separation of the seven emotional classes on the JAFFE dataset within the selected stratified protocol. Under the same algorithmic order, LBP showed significantly lower accuracy and revealed a specific structure of systematic confusion errors: the pairs “fear — surprise” and “sadness — neutral” provided consistently indistinguishable, while the category-wise distribution of metrics quantified the fundamental differences between contour and texture feature representations.
Discussion. The results obtained indicate the decisive impact of the data splitting protocol on the final assessment of classical descriptors. Specifically, the perfect separability of HOG features is explained by preservation of subject identities across training and test sets, and is fully consistent with the known sensitivity of the gradient profile to individual facial features. With respect to LBP, the observed values fall within the range known from the reference work by Shan, Gong, and McOwan. However, the pattern of false positives documented in the present study is the first to be interpreted in detail through FACS description of overlapping sets of active facial muscles, which has previously been absent from published comparative reviews.
Conclusion. The work has successfully solved the problems of comparative evaluation of LBP and HOG methods, construction of a fully reproducible software pipeline, and meaningful interpretation of automatic classification errors. Based on the data obtained, the HOG model combined with a linear SVM is suitable for laboratory tasks with a fixed set of subjects, whereas LBP in the same combination is justified as a component of hybrid architectures with convolutional or recurrent networks. In applied terms, the results can be used in the design of emotion recognition systems for medical interfaces and driver-monitoring systems. At the same time, the limitations of the work include the compact JAFFE dataset and the laboratory imaging conditions. Addressing these limitations, future work will involve moving to a more demanding protocol with full subject-out exclusion from the training set, as well as a comparative evaluation against current deep learning models.
Введение. Распознавание базовых эмоций по изображению лица относится к числу востребованных задач компьютерного зрения, имеющих как исследовательское, так и нормативное значение. С июля 2024 года новые транспортные средства категорий M (легковые) и N (грузовые) в ЕС обязаны оснащаться системами мониторинга состояния водителя согласно Regulation (EU) 2019/2144 1 . Именно поэтому методы компьютерного зрения с анализом мимики, направления взгляда и положения головы применяются в системах распознавания отвлечения (ADDW, Advanced Driver Distraction Warning) и Euro NCAP DMS. Параллельно те же методы анализа выражений лица востребованы в медицинской диагностике, мониторинге операторов на транспорте и образовательной аналитике. В этих сферах автоматический анализ обеспечивает более высокую воспроизводимость по сравнению с опросами и субъективным наблюдением.
Информатика, вычислительная техника и управление
Прикладной интерес к таким системам опирается на достаточно устойчивый теоретический фундамент. В частности, мимические реакции человека разнообразны и возникают спонтанно, что усложняет их интерпретацию, однако, несмотря на культурные и индивидуальные различия, стандартные выражения лица признаются в литературе устойчивыми индикаторами эмоционального состояния [1] . Именно универсальность таких выражений легла в основу систем кодирования лицевой активности и обеспечила теоретическую базу для алгоритмов автоматического распознавания. Параллельно развиваются мультимодальные подходы, использующие физиологические сигналы для объективной оценки эмоциональных реакций; они служат дополнением визуальных методов и расширяют возможности интегральной оценки состояния человека.
На методическом уровне современное состояние области распознавания лиц обобщено в обзорных работах [1] . Среди классических признаковых представлений лица особое место занимают локальные бинарные шаблоны (LBP), описывающие текстурные неоднородности лица и инвариантные к монотонным изменениям освещения [2] , а также гистограммы ориентированных градиентов (HOG), характеризующие контурную геометрию через локальные распределения градиентов [3] . Историческую преемственность с ними образуют каскадные детекторы Виолы-Джонса на Haar-подобных признаках с алгоритмом AdaBoost, обеспечившие внедрение детекции лиц в потребительские камеры, а также дескриптор SIFT, детектирующий масштабно-инвариантные особые точки в окрестности лицевых ориентиров.
Прикладная зрелость направления подтверждается обзорами современных методов автоматического анализа мимики [4] , клиническими работами по распознаванию эмоций [5] и зрелыми коммерческими системами анализа эмоций: объективная оценка состояния по лицу уже востребована на практике. Однако сами по себе коммерческие комплексы не отвечают на методический вопрос — их алгоритмы закрыты и не позволяют оценить, какой вклад в точность вносит отдельный классический дескриптор; опубликованные же сравнения LBP и HOG получены в разнородных условиях и плохо сопоставимы между собой. Это, в свою очередь, поднимает вопрос о том, как ведут себя классические дескрипторы в строго единых условиях оценки.
Параллельно методы анализа изображений отрабатываются в смежных областях компьютерного зрения — программных системах видеонаблюдения [6] , мониторинге состояния водителей [7] , трёхмерном захвате движения [8] , идентификации параметров оптического потока [9] и распознавании автомобильных номерных знаков [10] . Опыт этих работ показывает, что точная локализация признаков и устойчивая классификация остаются критическими требованиями независимо от целевой задачи.
На фоне этих общих требований распознавание эмоций по-прежнему остаётся открытой задачей даже для свёрточных нейронных сетей (CNN), широко внедряемых в компьютерном зрении. В сводном анализе [11] отмечается, что глубокие модели прежде всего сталкиваются с переобучением из-за ограниченной доступности обучающих данных и с не связанными с выражением лица вариациями — освещения, поворота головы, разрешения изображения и смещения идентичности. Помимо этого, создание набора данных с разметкой эмоций трудоёмко и дорого, а в транспортной и медицинской безопасности дополнительно требуется объяснимость решений, ограничивающая применение «чёрного ящика». Отдельной проблемой остаётся запоминание моделью конкретных субъектов, особенно заметное на небольших наборах данных [12] .
Обобщая сказанное, можно выделить устойчивую закономерность: для распознавания выражений лица единичный классический дескриптор уступает обучаемому представлению. LBP обеспечивает более устойчивые показатели в условиях переменного освещения благодаря инвариантности к монотонным преобразованиям яркости [2] ; HOG, напротив, лучше описывает контурную геометрию лица и сохраняет лидерство на лабораторных наборах данных [3] . Вместе с тем оба метода в одиночном варианте уступают сверточным нейронным сетям на крупных наборах данных [4] . Сравнительно высокая точность достигается при объединении LBP-признаков с обучаемыми представлениями на основе CNN или LSTM (long short-term memory, рекуррентные сети с долгой краткосрочной памятью) [7] ; близкие выводы обобщает сводный анализ современных методов распознавания выражений лица [11] . При этом каскадные детекторы Виолы-Джонса и их развитие по-прежнему обеспечивают приемлемое качество локализации лиц при низких вычислительных затратах, что подтверждается современными системами аутентификации по лицу на основе классических признаков [13] . Сопоставление условий применения, размеров обучающих выборок и протоколов проверки в разных источниках затруднено их методической разнородностью.
Из перечисленного видно, что для классических дескрипторов LBP и HOG в задаче распознавания эмоций недостаточно описаны несколько аспектов: устойчивость метрик при стратифицированной кросс-валидации на небольших наборах данных; природа систематических ошибок между визуально близкими эмоциями; границы применимости в режимах с переменным освещением и неконтролируемым ракурсом. Без этих сведений невозможно осмысленно встраивать классические признаки в гибридные схемы распознавания, поэтому возникает потребность в их прямом сопоставлении в единых и воспроизводимых условиях.
Поэтому цель настоящей работы — определить пределы применимости классических дескрипторов LBP и HOG в задаче распознавания семи базовых эмоций на наборе JAFFE и характеристика наблюдаемых ошибок классификации.
Для достижения поставленной цели в исследовании решены пять задач:
-
1) сопоставление теоретических свойств LBP и HOG применительно к распознаванию выражений лица — устойчивости к освещению, чувствительности к идентичности субъекта, размерности признакового представления;
-
2) реализация единого конвейера предобработки изображений и извлечения признаков LBP и HOG для набора JAFFE, обеспечивающего воспроизводимость результата;
-
3) классификация семи базовых эмоций методом опорных векторов с линейным ядром при пятикратной стратифицированной кросс-валидации;
-
4) интерпретация матриц ошибок и метрик Accuracy и Macro-F1 с привязкой к психофизиологическому объяснению систематических смешений эмоциональных классов;
-
5) формулировка рекомендаций по применению LBP и HOG для типичных сценариев, условий съёмки и путей встраивания классических признаков в гибридные архитектуры.
Методология настоящего исследования опирается на канон классической цифровой обработки изображений [14] — нормализацию яркости, гистограммное выравнивание, выделение признаков локальных текстур и градиентов.
Материалы и методы. Набор данных. В качестве экспериментальной базы использован открытый исследовательский набор данных JAFFE (Japanese Female Facial Expression, «японское женское выражение лица», Lyons et al., 1998; университет Kyushu, Япония), распространяемый для научных целей. Набор содержит 213 полутоновых изображений десяти испытуемых-японок с семью базовыми эмоциями: гнев, отвращение, страх, счастье, нейтральное выражение, грусть, удивление; классы распределены практически равномерно — от 29 до 32 изображений на эмоцию. Изображения получены в лабораторных условиях при одинаковом освещении и фронтальном ракурсе с постановочными выражениями, что обеспечивает однородность съёмки, но ограничивает прямой перенос результатов на полевые сценарии. Входные изображения JAFFE приводили к полутоновой палитре с разрешением 256 × 256 пикселей. Для нормализации яркости применяли гистограммное выравнивание. Лица выравнивали по координатам глаз, полученным с помощью детектора ориентиров на базе библиотеки Dlib (модель shape_predictor_68_face_landmarks).
Извлечение признаков. На подготовленных таким образом изображениях вычисляли два взаимодополняющих классических дескриптора. Локальные бинарные шаблоны (LBP) рассчитывали в uniform-кодировке (равномерной) с радиусом R = 1 и числом соседей P = 8; гистограммы строили по непересекающимся блокам 16 × 16 пикселей и объединяли в общий вектор признаков размерностью 15 104. Гистограммы ориентированных градиентов (HOG) формировали с ячейками 8 × 8 пикселей, блоками 2 × 2 ячейки, девятью ориентационными бинами и блочной нормализацией L2-Hys (значение по умолчанию в scikit-image).
Классификация и оценка качества. Полученные признаковые векторы подавали на классификатор методом опорных векторов с линейным ядром (SVM). Параметр регуляризации C перебирали по сетке {0,01; 0,1; 1; 10} с выбором значения по внутренней трёхкратной кросс-валидации, вложенной во внешний цикл стратифицированной пятикратной кросс-валидации. Качество оценивали по среднему и стандартному отклонению Accuracy и Macro-F1 по пяти внешним фолдам. Дополнительно были построены матрицы ошибок (confusion matrices), а также проанализировано распределение метрик точности (precision), полноты (recall) и F1-меры для каждого из семи классов.
Программная реализация. Конвейер реализован в среде Python 3.10 с использованием библиотек scikit-learn 1.3 (SVM, кросс-валидация) и scikit-image 0.21 (LBP, HOG). Начальное значение генератора псевдослучайных чисел было зафиксировано (random_state = 42), что обеспечивает воспроизводимость разбиения выборки на фолды и повторяемость выбора гиперпараметров.
Результаты исследования. Метод HOG в сочетании с линейным SVM достиг полной разделимости семи эмоциональных классов: Accuracy = 1,000 ± 0,000 и Macro-F1 = 1,000 ± 0,000 (среднее ± стандартное отклонение по пяти внешним фолдам; таблица 1, рис. 1). Для всех семи классов метрики precision, recall и F1 приняли значение 1,00; межклассовых пересечений на матрице ошибок не выявлено. Размерность итогового признакового вектора HOG составила 34 596 элементов; во всех пяти внешних фолдах внутренняя кросс-валидация выбрала значение параметра регуляризации C = 1. Среднее время извлечения признаков на одно изображение составило около 0,018 с, обучения классификатора на тренировочном фолде — 0,42 с, предсказания на одно изображение — 0,003 с.
Таблица 1
Результаты классификации эмоций на наборе JAFFE
|
Метод |
Accuracy (точность) |
Макро-F1 (макро-усредненная F1-оценка) |
|
LBP |
0,30 |
0,20 |
|
HOG |
1,00 |
1,00 |
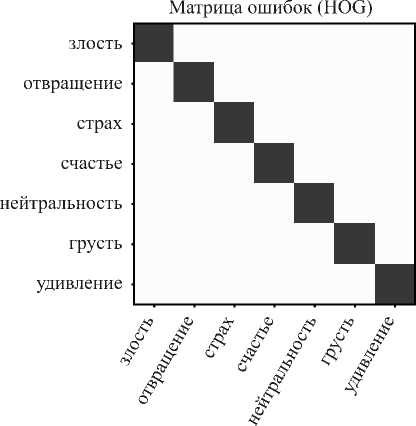
Рис. 1. Матрица ошибок метода HOG
Информатика, вычислительная техника и управление
Метод LBP в том же протоколе показал Accuracy = 0,300 ± 0,041 и Macro-F1 = 0,202 ± 0,038 (таблица 1). По пяти внешним фолдам значения Accuracy составили 0,256; 0,310; 0,310; 0,357 и 0,267. Размерность итогового признакового вектора LBP составила 15 104 элемента; внутренняя кросс-валидация выбрала значение C = 0,1 в трёх внешних фолдах и C = 1 в двух остальных. Среднее время извлечения признаков на одно изображение составило около 0,009 с; обучения классификатора — 0,18 с; предсказания — 0,002 с.
Распределение значений precision, recall и F1 по семи классам JAFFE для метода LBP оказалось неравномерным (таблица 2). Максимальные значения F1 наблюдались для классов «отвращение» (0,33) и «счастье» (0,30); минимальные значения — у классов «страх» (0,11), «грусть» (0,14) и «нейтральное» (0,14). Минимальные значения precision зафиксированы у классов «нейтральное» (0,12), «страх» (0,13) и «удивление» (0,14); минимальные значения recall — у классов «страх» (0,10), «грусть» (0,11) и «нейтральное» (0,17). У классов «удивление» и «нейтральное» recall превысил precision более чем на 0,05; у класса «грусть» precision превысил recall на 0,07.
Таблица 2
Precision, recall и F1-мера метода LBP по семи классам набора JAFFE
|
Класс |
Precision |
Recall |
F1 |
|
Гнев |
0,20 |
0,24 |
0,22 |
|
Отвращение |
0,35 |
0,31 |
0,33 |
|
Страх |
0,13 |
0,10 |
0,11 |
|
Счастье |
0,32 |
0,28 |
0,30 |
|
Нейтральное |
0,12 |
0,17 |
0,14 |
|
Грусть |
0,18 |
0,11 |
0,14 |
|
Удивление |
0,14 |
0,25 |
0,18 |
|
Макро-среднее |
0,21 |
0,21 |
0,20 |
На матрице ошибок LBP (рис. 2) класс «страх» был отнесён к «удивлению» в 24,1 % случаев, к «гневу» — в 14,8 % и к «нейтральному» — в 11,1 %. Класс «грусть» был отнесён к «нейтральному» в 27,6 % случаев и к «гневу» — в 10,3 %. Класс «нейтральное» был отнесён к «грусти» в 16,7 % случаев. Наибольшие диагональные значения матрицы ошибок зафиксированы у классов «отвращение» и «счастье» — около 33 % и 30 % соответственно.
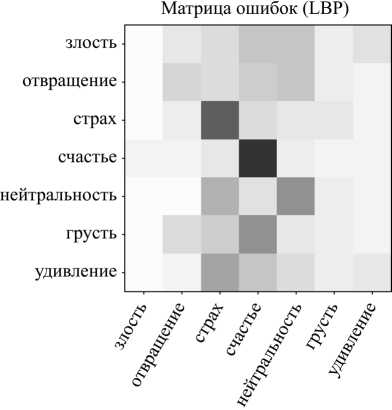
Рис. 2. Матрица ошибок метода LBP
Обсуждение. Сравнение результатов проведённых исследований с другими работами по распознаванию выражений лица показывает, что прямое сопоставление количественных значений требует оговорки об условиях эксперимента. В работе Shan, Gong, McOwan [15] на JAFFE использованы тщательно подобранные параметры LBP: радиус R = 2, разбиение на 42 субрегиона 18 × 21 пикселя, uniform-кодировка. При таком наборе и линейном SVM показатели Accuracy выше, чем у конвейеров с типовыми настройками. Настоящая работа опирается на другую конфигурацию: радиус R = 1, непересекающиеся блоки 16 × 16 пикселей на изображении 256 × 256, итоговый вектор признаков размерностью 15 104. Это типовое представление LBP с дескрипторной реализацией «из коробки»; конфигурация подбиралась под задачу проверить поведение метода в стандартных условиях, а воспроизведение количественных значений [15] в задачу настоящего исследования не входило. Расхождение результатов с эталонной работой подтверждает известную чувствительность LBP к выбору радиуса и схемы разбиения.
Помимо проведения непосредственного сопоставления, существенным ориентиром выступают гибридные архитектуры: применение LBP на входных уровнях свёрточных или рекуррентных нейронных сетей способно обеспечить значительно более высокие качественные показатели в сравнении с изолированным классификатором [12] . В данном контексте результаты, полученные для метода HOG в рамках настоящего протокола, следует интерпретировать не как свидетельство универсального превосходства указанного дескриптора, а как маркер высокой чувствительности градиентного профиля к сохранению идентичности субъектов в обучающей и тестовой выборках; при этом качество кодирования эмоциональных состояний при подобном разделении данных оказывалось вторичным фактором.
Для более корректной оценки обобщающей способности алгоритмов целесообразно использовать экспериментальный протокол с исключением субъекта (LOSO, leave-one-subject-out), при реализации которого обучающая и тестовая выборки не содержат изображений одних и тех же лиц. Примененная в работе пятикратная стратифицированная кросс-валидация допускает присутствие идентичностей в обоих подмножествах, что приводит к искусственному завышению метрик для HOG; в таких условиях сравнительная диагностика методов характеризуется систематическим смещением.
Анализ структуры детекции ошибок показывает, что смешения классов, зафиксированные в матрице ошибок для LBP, имеют под собой четкое психофизиологическое обоснование. Так, пары «страх – удивление» и «грусть – нейтральное выражение» отличаются наличием перекрывающихся групп активных лицевых мышц согласно системе FACS — в первом случае наблюдается подъем бровей и расширение глаз, во втором — слабовы-раженная амплитуда специфических действий, характерных для грустного выражения (AU1 + AU4 + AU15), на статичных снимках. Текстурные признаки LBP фиксируют локальные неоднородности и неизбежно отражают данное визуальное сходство; таким образом, регистрируемая погрешность детерминирована ограничениями признакового пространства, тогда как сам классификатор функционирует корректно.
Совокупность представленных наблюдений демонстрирует, что стандартная пятикратная кросс-валидация обладает ограниченной эффективностью при оценке методов распознавания мимики на компактных наборах данных. Даже при строгом соблюдении существующих методологических требований итоговые результаты склонны переоценивать качество обобщения на новых персонах. Переход к протоколу LOSO, вовлечение более масштабных баз данных с вариативными условиями регистрации и жесткий контроль отсутствия пересекающихся идентичностей между выборками являются обязательными условиями для получения объективной оценки.
Сформулированные выводы получены в условиях, накладывающих определенные ограничения на возможность широкого обобщения:
-
- использованный набор данных JAFFE характеризуется относительно малым объемом (213 изображений десяти испытуемых) и этнической однородностью, что не позволяет экстраполировать числовые показатели на популяции с иными антропометрическими параметрами;
-
- снимки выполнены в лабораторной среде при стабильном освещении и фронтальном ракурсе с имитацией выражений, в то время как полевые сценарии предполагают наличие динамического освещения, произвольных ракурсов и спонтанных реакций;
Информатика, вычислительная техника и управление
-
- процедура классификации реализована единственным типом алгоритма — линейным SVM — без проведения сопоставления с ядрами иных типов или глубокими обучаемыми архитектурами;
-
- объектом анализа выступали исключительно статические изображения без учета временной динамики мимических сокращений, доступной в видеопотоке.
С учетом указанных факторов полученные результаты подтверждают целесообразность эксплуатации методов LBP и HOG в специфических условиях, детерминированных физической природой каждого дескриптора. Применение HOG показано в рамках лабораторных задач с фиксированным составом участников и контролируемой инсоляцией, где допустима идентификационно-связанная разделимость классов. Метод LBP уступает по точности как самостоятельный инструмент, однако обеспечивает более устойчивую оценку в условиях нестабильного освещения и неконтролируемых ракурсов, что делает его эффективным элементом признакового описания в составе гибридных систем с обучаемыми моделями.
Заключение. В ходе исследования были решены поставленные задачи: сопоставлены свойства LBP и HOG применительно к распознаванию выражений лица, реализован единый воспроизводимый конвейер предобработки и извлечения признаков, проведена классификация семи базовых эмоций линейным SVM, построены матрицы ошибок и сформулированы рекомендации по применению дескрипторов. В едином протоколе на JAFFE метод HOG с линейным SVM достиг Accuracy = 1,000 ± 0,000, что объясняется утечкой идентичности субъекта при стратифицированной кросс-валидации; LBP при том же протоколе дал Accuracy = 0,300 ± 0,041 и устойчивые систематические смешения пар «страх – удивление» и «грусть – нейтральное выражение», согласующиеся с FACS-описанием перекрывающихся наборов лицевых мышц.
С позиции практического внедрения, модель на основе HOG и линейного SVM применима для решения локальных лабораторных задач с постоянным составом испытуемых, например, на исследовательских стендах или в пилотных версиях медицинских интерфейсов. Использование LBP совместно с линейным SVM в изолированном виде менее эффективно по точности, однако обосновано в роли компонента гибридных архитектур (включающих сверточные и рекуррентные сети) ввиду высокой вычислительной экономичности и инвариантности к монотонным флуктуациям освещенности. Полученные результаты могут быть востребованы при проектировании систем мониторинга состояния водителя, соответствующих требованиям Regulation (EU) 2019/2144, а также для методологического обоснования выбора протоколов оценки качества на малых выборках. С учетом выявленных ограничений приоритетным направлением дальнейших изысканий видится переход к протоколам с исключением субъектов и расширение экспериментального материала за счет данных, полученных в неконтролируемой среде.
