
Математическая модель гибридных архитектур CNN–GAN для автоматизированной диагностики в условиях ограниченного объёма данных
Журнал: Инфокоммуникационные технологии @ikt-psuti
Рубрика: Новые информационные технологии
Статья в выпуске: 1 (93) т.24, 2026 года.
Бесплатный доступ
В работе рассматривается задача автоматизированной диагностики редких онкологических заболеваний по медицинским изображениям с использованием гибридных архитектур, объединяющих сверточные нейронные сети и генеративно-состязательные сети. Основное внимание уделяется строгой математической формализации процесса, включая описание структуры данных, процедуры стратификации, методов препроцессинга и генерации синтетических изображений для увеличения обучающих выборок. Предлагается подход, в котором для каждого реального положительного примера создаются дополнительные синтетические изображения, что позволяет компенсировать дисбаланс классов и улучшить качество классификации при ограниченном объёме исходных данных. Приведённая модель исключает неоднозначность, характерную для вербальных описаний, обеспечивает воспроизводимость результатов и создаёт основу для последующей оптимизации архитектур в сценариях с малым количеством примеров. Перспективы работы связаны с интеграцией гибридных моделей в клиническую практику, исследованием влияния параметров генерации на точность диагностики и адаптацией подхода к различным видам редких патологий.
Короткий адрес: https://sciup.org/140316415
IDS: 140316415 | УДК: 004.94 | DOI: 10.18469/ikt.2026.24.1.06
A mathematical model of hybrid CNN–GAN architectures for automated diagnostics under data limited conditions
This paper addresses the problem of automated diagnosis of rare oncological diseases using medical imaging data with hybrid architectures combining Convolutional Neural Networks and Generative Adversarial Networks. The study focuses on a rigorous mathematical formalization of the entire pipeline, including data structure description, stratification procedures, preprocessing methods, and synthetic image generation to augment training datasets. The proposed approach generates additional synthetic images for each real positive example, thus compensating for class imbalance and improving classification accuracy under limited data conditions. The presented framework eliminates the ambiguity typical of purely verbal problem formulations, ensures reproducibility of results, and provides a foundation for optimizing hybrid architectures in few-shot learning scenarios. Future research directions include integrating the proposed approach into clinical workflows, investigating the impact of synthetic data parameters on diagnostic performance, and adapting the methodology to various types of rare pathologies.
Текст научной статьи Математическая модель гибридных архитектур CNN–GAN для автоматизированной диагностики в условиях ограниченного объёма данных
Проблема автоматизированной диагностики на основе медицинских изображений активно исследуется с использованием методов глубокого обучения. Применение глубокого обучения в медицинской визуализации началось с адаптации архитектур сверточных нейронных сетей (CNN), таких как LeNet-5 [1]. CNN являются основным инструментом для классификации, сегментации и детекции патологий на КТ и МРТ-снимках благодаря их способности извлекать иерархические признаки напрямую из данных. Ограничением для широкого применения CNN является их высокая требовательность к объему и репрезентативности обучающих выборок. Для компенсации этого рассматривают генеративно-состязательные сети (GAN). Работы [2, 3] продемонстрировали потенциал GAN для синтеза фотореалистичных медицинских изображений, включая КТ-снимки, с целью аугментации датасетов. GAN модели стали стандартным подходом для борьбы с дефицитом данных и моделирования многообразия патологий [4, 5]. Исследования [2, 6] показали, что архитектуры, в которых GAN-модуль генерирует дополнительные обучающие примеры для CNN-классификатора, способны повысить точность и устойчивость диагностических систем, особенно в условиях ограниченного количества исходных данных.
На сегодняшний день накоплен опыт применения CNN и GAN в медицинской диагностике, а также существуют первые реализации их гибридов. Тем не менее, существует пробел, состоящий в том, что большинство решений сфокусировано на общих задачах и относительно распространенных патологиях. Вопросы адаптации гибридных моделей для диагностики редких онкологических нозологий, оптимизации процесса генерации для малопредставленных классов, а также исследование их эффективности в сценариях с критически малым числом примеров остаются недостаточно изученными.
Часто модель решаемой задачи задается в вербальном виде. Так, в [7] постановка задачи классификации редкого вида злокачественных опухолей надпочечников и предлагаемая методика решения этой задачи на примере задачи классификации редкого вида злокачественных опухолей надпочечников осуществляется вербальным способом. Такая постановка характерна для подобных задач. Вербальное описание исследуемого процесса, применяемое на начальных этапах научного анализа, играет важную роль для интуитивного понимания проблемы и постановки общих задач. Однако при работе с высокотехнологичными системами, такими как CNN– GAN-архитектуры, вербальные формулировки имеют принципиальные ограничения. Словес-
ные описания характеризуются неоднозначностью: одни и те же термины или качественные характеристики могут по-разному трактоваться, что снижает воспроизводимость результатов. Отсутствует строгий механизм количественной верификации. Невозможно формально определить, насколько корректны утверждения. Словесная форма не позволяет анализировать влияние параметров и факторов на результат, что критично для задач, требующих оценки устойчивости и надёжности диагностических решений. Словесные описания плохо масштабируются. При добавлении новых условий или параметров они становятся громоздкими и практически не поддаются автоматизации.
Построение математической модели позволяет устранить указанные недостатки. Переход от словесного описания к математической модели является необходимым условием для построения строгой, воспроизводимой и оптимизируемой методологии. В контексте задач автоматизированной диагностики редких онкологических заболеваний он обеспечивает возможность формальной постановки проблемы, объективной оценки предлагаемых решений и их интеграции в клиническую практику. В статье приводится математическое описание данных, которое описывает единицу наблюдения, иерархию индексов (пациент → срез), источники (коллекции TCIA), метки и ROI-маски, препроцессинг, стратификацию по пациентам.
Единица наблюдения и индексация
Пусть P – множество пациентов, | P | = k . Для каждого пациента p е P имеется набор аксиальных срезов т p = {1,..., T p } . Единица наблюдения -одиночный двумерный срез КТ/МРТ после препроцессинга 224 × 224 – один 2D-кадр из объёма КТ/МРТ, который пропущен через конвейер предобработки и приведён к фиксированному размеру 224 пикселей по высоте × 224 пикселей по ширине:
хр е RHXW, H = W = 224, p,t
где H × W – это размер матрицы изображения: H (число строк), W (число столбцов) с бинарной меткой yp t е { 0,1 } (1 — «опухоль», 0 - «норма») и, где доступно, бинарной ROI-маской (покадровая разметка, указывающая, какие пиксели/вок-сели принадлежат целевой области: опухоли, органу, очагу и т.п.) m p t е { 0,1 } H х W . Класс «норма» формируется из срезов тех же пациентов, где по разметке опухоль отсутствует.
В качестве источника данных используют шесть публичных, де-идентифицированных кол- лекций из The Cancer Imaging Archive (TCIA) [8] – открытого архива онкологических изображений с доступом к данным по коллекциям с первичным форматом – DICOM.: ADRENAL-ACC-Ki67-Seg, Osteosarcoma-Tumor-Assessment, TCGA-KICH, Head-Neck-PET-CT, CPTAC-PDA и LIDC-IDRI – референс-корпуса лёгочных узлов (1018 КТ-кейсов с консенсусной аннотацией четырёх радиологов). Суммарные объёмы после фильтрации и препроцессинга: 27 086 срезов «опухоль» и 32 198 «норма» (всего 59 284) [9].
Задав c как ID коллекции из множества C= { ADRENAL, OSTEO, TCGA-KICH, HN-PET-CT, "CPTAC-PDA, LIDC-IDRI } можем записать x p , t ~ p ( xc ) .
При выполнении стратификации по пациентам пациенты разбиваются детерминированно:
P = P an U P val U P est ,
с долями 60%/20%/20% . Ни один пациент не встречается в двух разных частях. Срезы попадают в соответствующую часть по пациенту:
D rain = { x pt , y p , t , m p , t : p е P an , t е Tan } . (3)
Аналогично выполняется для валидационной и тестовой выборок. Стратификация по пациентам исключает попадание срезов одного и того же пациента в разные выборки.
Препроцессинг данных
Перед подачей медицинских изображений в модель CNN–GAN проводится предобработка данных. Основные цели препроцессинга: устранение шумов и артефактов; приведение данных к единому формату по размеру, глубине цвета и разрешению; сегментация и выделение зон интереса (ROI) для уменьшения влияния фоновых областей; нормализация и стандартизация интенсивностей для стабильного обучения нейронных сетей; балансировка данных и аугментация, чтобы минимизировать дисбаланс классов и переобучение.
Исходные серии поставляются в стандарте DICOM – доминирующем формате клинической визуализации. В конвейере препроцессинга DICOM-кадры переводятся в 8-битные PNG для унификации ввода в нейросети.
Применяется стандартизованный конвейер, представляющий препроцессинг как композицию операторов:
T = Tcrop ° Tstd ° TCLAHE ° TPNG , (4) где TPNG :DICOM ^ PNG (8-бит); tclahe :CLAHE для выравнивания локального контраста. CLAHE (Contrast-Limited Adaptive Histogram Equaliza- tion) – классический приём для усиления локальных деталей в медицинских изображениях [10]; Tstd : стандартизация интенсивностей по train (x H (x - у)/о); Tcrop : обрезка центральной части изображения до 224 × 224. Операция выполняется справа налево. В результате получаем препроцессированный срез:
x p,t = T ( x DIICOM ) . (5)
Маски и «неполнота» разметки
Для части наборов доступны пиксельные ROI-маски опухоли (ADRENAL-ACC-Ki67-Seg, Osteosarcoma). Для остальных наборов доступна только метка наличия/отсутствия опухоли на срезе. Фильтрация данных позволяет отбрасывать маски, чья площадь меньше порога, чтобы не учитывать шум. Пусть индикатор доступности rp , t e { 0,1 } . Для срезов без разметки ROI полагаем r p , t _ 0 и используем mp , t = 0 в тех местах, где требуется маска. Площади маски характеризуют количественную характеристику ROI на изображении. Площадь маски позволяет оценить размеры опухоли, т.е. позволяет измерить, как изменяется область поражения с течением времени. Также можно оценить качество сегментации, т.к. метрики Dice или IoU учитывают пересечение масок и их площади. Площадь маски, определяющую долю опухоли в кадре, определяем по формуле:
a p,t _ hW E m p,t [ i , j HM . (6)
Распределение данных означает, как исходные медицинские изображения разделяются и структурируются для обучения, валидации и тестирования CNN–GAN модели. Это ключевой этап, потому что корректное распределение данных обеспечивает объективную оценку качества модели и предотвращает утечку информации между выборками.
Целью распределения данных является балансировка классов, чтобы модель видела: сопоставимое число примеров «опухоль» и «норма»; избегание утечки данных, состоящее в том, чтобы пациентские данные не повторялись в разных выборках; подготовка репрезентативных наборов для того, чтобы тестовое множество отражало реальные сценарии применения модели.
Эмпирическое распределение в обучающей выборке – это способ формально описать, как данные и их метки распределены внутри обучающегося набора. Эмпирическое распределение записывается как эмпирическая мера:
pr ( x , y , m ) _
S ( ( x , y , m )- ( x p ,t , y p,t , m p , t ) ) .
- E
( P ■ t ) eT rain„
Синтетические данные и смешивание
В рассматриваемом [7] подходе предложено к одному реальному положительному кадру генерировать два синтетических кадра (для множеств «опухоль») для обучения классификатора. Обозначим через G генератор, а через z ~ pz ( z ) - латентный вектор. Тогда генератор может выдать синтетический образец для положительного класса
X g _ G ( z , y _ 1, m ) , (8) в результате чего можем сформировать множество синтетических примеров. И на каждый ( x , y ) _ 1 формируется два x . Тогда расширенная обучающая выборка будет состоять из Nt t o r t ain элементов:
N train n train । n train । 2 n train
где N 1 train – число положительных реальных срезов в обучающей выборке, N 0 train – число отрицательных срезов в обучающей выборке. На рис. 1
показана итоговая схема структуры коллекции, где показана связь между реальными данными, масками, синтетикой, препроцессингом и финальными выборками.
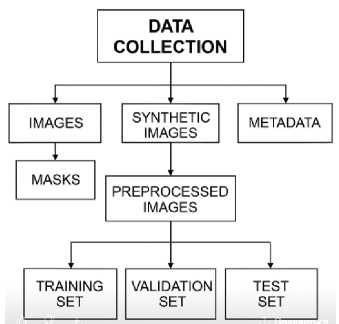
Рисунок 1. Схема структуры коллекции
Использование синтетических изображений, полученных с помощью GAN, связано с риском появления специфических артефактов генерации. Такие артефакты могут быть незаметны визуально, однако способны приводить к смещению обучения классификатора, при котором модель опирается не на признаки патологии, а на особенности синтетических данных. В связи с этим оценка качества синтезированных изображений не может основываться исключительно на численных метриках сходства. В работе используется комбинированный подход, включающий:
-
1. Количественную оценку, основанную на сравнении распределений реальных и синтетических изображений с применением стандартных метрик.
-
2. Качественную экспертную оценку на основе правил визуального анализа, принятых в медицинской диагностике.
Оценка вычислительной сложности и требований к ресурсам
Предлагаемый подход основан на использовании вычислительно затратных архитектур. Практическая реализация модели требует значительных аппаратных ресурсов, особенно на этапе обучения. В частности, обучение CNN-классификатора и GAN-модели для генерации изображений предполагает использование GPU с поддержкой параллельных вычислений. Для воспроизводимости экспериментов достаточно одного GPU уровня NVIDIA RTX 2080 / RTX 3060 с объемом видеопамяти не менее 8–12 ГБ. Время обучения генеративной модели составляет несколько часов. На этапе инференса вычислительная нагрузка существенно снижается, что позволяет использовать обученный классификатор в клинических системах в режиме, близком к реальному времени. Несмотря на высокую ресурсоемкость этапа обучения, практическое использование модели является технически реализуемым в условиях медицинских организаций, располагающих стандартными GPU-ресурсами.
Заключение
В статье рассмотрена гибридная CNN–GAN архитектура для диагностики редких онкологических заболеваний с акцентом на строгое математическое описание данных, включая индексацию, стратификацию, препроцессинг и синтез изображений. Разработанный формализм обеспечивает воспроизводимость экспериментов и исключает неоднозначность, свойственную вербальным описаниям исследуемых процессов. Он открывает возможности для оптимизации архитектур и их адаптации к сценариям с малым количеством примеров, что особенно важно для диагностики редких патологий.
Перспективы дальнейших исследований связаны с интеграцией предложенного подхода в клинические рабочие процессы, изучением влияния различных типов синтетических данных на качество классификации и разработкой методов автоматической подстройки архитектуры гибридных моделей под особенности конкретных нозологий.
