
Методологический подход к верификации и применению вероятностных моделей связи «биомаркеры экспозиции – биомаркеры эффекта» на основе KL-дивергенции: пилотное исследование
Журнал: Анализ риска здоровью @journal-fcrisk
Рубрика: Медико-биологические аспекты оценки воздействия факторов риска
Статья в выпуске: 3 (54), 2026 года.
Бесплатный доступ
Линейные регрессионные модели, традиционно используемые для оценки связи между химической экспозицией и биомаркерами, обладают существенными ограничениями: они не учитывают гетерогенность популяции, неадекватно описывают нелинейные зависимости и неэффективны при коррелированных предикторах. Разработан методологический подход к верификации и использованию вероятностных моделей связи «биомаркеры экспозиции – биомаркеры эффекта» на основе дивергенции Кульбака – Лейблера (KL) как интегральной меры качества, позволяющей объективно сравнивать линейные и нелинейные модели. На пилотной выборке построены модели: линейная и ридж-регрессии, полиномиальная 2-й степени, GAM, Random Forest (случайный лес) и XGBoost. Для каждой рассчитана KL-дивергенция между фактическим и предсказанным совместным распределением трех показателей крови: нейтрофилы, эозинофилы, кортизол. Линейная регрессия показала крайне высокую KL-дивергенцию, XGBoost продемонстрировал наилучший результат. Q–Q (квантиль-квантиль) графики выявили расхождения в хвостах распределений, указывающие на гетерогенность выборки и необходимость стратификации. Предложенный подход позволяет объективно сравнивать модели и выбирать наиболее адекватную структуру связи. На основе полученных моделей разработана система обратного сигнала с тремя сценариями (желтый, оранжевый, красный) для автоматического информирования служб контроля качества объектов среды обитания при выявлении значимых отклонений биомаркеров у населения. Ключевое преимущество – метод легко масштабируется на любое количество анализов (биохимических, иммунологических, генетических) и любой набор загрязнителей без изменения базовой логики, что делает его универсальным инструментом для системы социальногигиенического мониторинга.
Короткий адрес: https://sciup.org/142248735
IDS: 142248735 | УДК: 614.2:519.226:57.088 | DOI: 10.21668/health.risk/2026.3.13
Methodological approach to verifying and using probabilistic models of the biomarkers of exposure – biomarkers of effect relationship based on KL-divergence: pilot study
Linear regression models are traditionally used to estimate the relationship between chemical exposures and biomarkers. Still, they have several considerable limitations: they fail to consider heterogeneity of a population, do not adequately describe non-linear dependences and are not effective when correlated predictors are used. The aim of this study was to develop a methodological approach to verifying and using probabilistic models that describe the ‘biomarkers of exposure – biomarkers of effect’ relationship based on Kullback – Leibler (KL) divergence. This is an integral quality measure, which makes it possible to objective compare linear and non-linear models. A\pilot sample was used to build several models: a linear model, ridge-regression, second-degree polynomial model, GAM, Random Forest, and XGBoost. KL-divergence was calculated for each model between the actual and predicted distribution of three blood indicators: neutrophils, eosinophils, and cortisol. The linear regression showed extremely high KL-divergence and the XGBoost yielded the best result. Q–Q (quantile-quantile) graphs revealed some discrepancies in distribution tails, which indicated that the sample was heterogeneous and stratification was necessary. The suggested approach makes it possible to objectively compare models and select the most adequate structure of the relationship. A feedback signal system was developed based on the built models; it used three scenarios (yellow, orange, and red) for automatic communication with services responsible for controlling quality of environmental objects in case serious deviations from safe standards were found in biomarkers in the population. The key advantage is that the method is easily scaled to cover any number of tests (biochemical, immunological, or genetic) and any set of pollutants without any changes in its basic logic. This makes the method a universal instrument for the system for social and hygienic monitoring.
Текст научной статьи Методологический подход к верификации и применению вероятностных моделей связи «биомаркеры экспозиции – биомаркеры эффекта» на основе KL-дивергенции: пилотное исследование
Савочкина Анна Александровна – кандидат физико-математических наук, доцент кафедры «Высшая математика» (e-mail: ; тел.: 8 (342) 236-16-97; ORCID: .
Землянова Марина Александровна – доктор медицинских наук, профессор, заведующий отделом биохимических и цитогенетических методов диагностики (e-mail: ; тел.: 8 (342) 236-39-30; ORCID: .
В современной гигиенической науке и в практике социально-гигиенического мониторинга все большую актуальность приобретает установление объективной количественной связи между уровнями экспозиции человека химическими загрязнителями в биосредах и функциональными показателями организма, отражающими состояние гомеостаза [1–4]. Традиционные линейные регрессионные модели, широко применяемые в эпидемиологических исследованиях, часто не позволяют адекватно описать сложные, нелинейные и многомерные отношения между экспозицией и биомаркерами, что ограничивает возможности прогнозирования и ранней диагностики донозологических изменений для принятия управленческих решений.
Традиционно в эпидемиологических исследованиях для оценки связи между воздействием химических факторов и биомаркерами в крови применялись линейные регрессионные модели. В основе этого подхода лежит предположение о том, что вся популяция однородно чувствительна к воздействию, а ответная реакция организма линейно зависит от дозы. В отсутствие биологически обоснованных моделей механизмов воздействия линейная беспороговая модель часто принималась по умолчанию. Однако многочисленные исследования показали, что реальные зависимости «доза – эффект» значительно сложнее, и линейные модели имеют ряд фундаментальных ограничений. Во-первых, стандартная линейная регрессия оказывается нечувствительной к гетерогенности популяции и практически неспособна обнаружить эффект в чувствительных подгруппах. Как показано в работе [5] на примере метилртути, если чувствительная подгруппа составляет всего 5–10 % популяции, линейная регрессия не обнаруживает достоверной связи там, где она объективно существует. Более того, оцененный для всей популяции наклон дозовой зависимости систематически занижает истинный эффект в чувствительной подгруппе примерно на порядок. Это особенно критично для гигиенических исследований, где уязвимые группы (дети, лица с генетическими особенностями или сопутствующими заболеваниями) часто составляют меньшинство, но именно они формируют основной риск. Во-вторых, линейные модели неспособны адекватно описывать нелинейные зависимости, которые широко распространены в биологических системах. В токсикологии и гигиене накоплены убедительные доказательства существования пороговых эффектов, горметических (двухфазных) и других нелинейных кривых «доза – эффект». Игнорирование этой нелинейности и использование линейной аппроксимации может приводить к систематическим ошибкам: в одних случаях линейная модель недооценивает риски в области низких доз, в других – переоценивает их. В-третьих, при работе с многокомпонентными воздействиями линейные методы сталкиваются с проблемой коррелиро-ванности предикторов. Сравнительное исследова- ние [6] показало, что линейные регрессионные методы обладают крайне ограниченной способностью отличать истинные предикторы от коррелированных с ними переменных: при реалистичной структуре корреляций доля ложных открытий может достигать 86 %. Это означает, что значительная часть статистически значимых ассоциаций, выявленных с помощью линейных моделей, может быть артефактом корреляционной структуры данных.
В качестве альтернативы линейным моделям часто использовалось логарифмическое преобразование данных, предполагающее, что биомаркеры и концентрации загрязнителей имеют логнормальное распределение. Однако и этот подход имеет серьезные ограничения. Авторы [7] показали, что мультипликативная логнормальная модель может приводить к существенным смещениям даже при небольших отклонениях от истинного распределения биомаркера, а логнормальный метод максимального правдоподобия демонстрирует крайне плохие свойства на малых выборках даже в условиях, когда модель верна. Таким образом, традиционные подходы – линейная регрессия и логнормальные модели – не обеспечивают надежной и адекватной оценки связи между химическими загрязнителями и биомаркерами, особенно в условиях гетерогенности популяции, нелинейности биологических ответов и многокомпонентного воздействия.
В качестве интегральной меры качества модели используется дивергенция Кульбака – Лейблера (KL) – фундаментальная информационно-теоретическая метрика, широко применяемая для оценки степени различия между двумя распределениями вероятностей. В общем виде KL-дивергенция между фактическим (эмпирическим) распределением p ( x ) и модельным (предсказанным) q ( x ) определяется как:
'- ( p ( x ) ^
DKL ( P II Q )= fp ( x )ln |—r| dx
J I q (x))
-от и интерпретируется как количество информации, теряемой при использовании распределения Q для аппроксимации истинного распределения P. Чем меньше значение KL-дивергенции, тем ближе сравниваемые распределения друг к другу, то есть тем меньше информационная потеря при замене одного распределения другим. В отличие от традиционных критериев качества, оценивающих точность точечных предсказаний, KL-дивергенция позволяет оценить, насколько хорошо модель воспроизводит совместное распределение всех анализируемых показателей – их средние значения, дисперсии и корреляционную структуру. Это принципиально важно в задачах, где интерес представляет не столько прогноз отдельных значений, сколько адекватное описание многомерной структуры данных [8].
Принципиальным преимуществом KL-дивергенции является ее универсальность: она опреде- лена для любых распределений вероятностей, что позволяет в последующих исследованиях при необходимости перейти к непараметрическим оценкам плотности (например, ядерным оценкам) либо использовать другие параметрические семейства, если проверка гипотезы о виде распределения (например, тест Mardia) укажет на их бóльшую адекватность.
В последние годы KL-дивергенция активно внедряется в практику статистического моделирования в эпидемиологии, экологии и смежных областях [9]. Метод применяется для байесовской диагностики моделей, своевременного обнаружения аномалий в эпидемиологических данных, оценки качества прогностических распределений в QSAR-моделировании и верификации байесовских моделей при анализе вирусной нагрузки. KL-дивергенция лежит в основе таких широко известных критериев выбора моделей, как информационный критерий Акаике [10], где она выступает теоретическим фундаментом для оценки потери информации при использовании аппроксимирующей моде-ли1. В контексте оценки связи «экспозиция – биологический ответ» данный подход предлагает объективный и интерпретируемый критерий сравнения моделей разной сложности – от линейной регрессии до нелинейных ансамблевых методов, позволяя обоснованно выбирать наиболее адекватную структуру зависимости. Таким образом, KL-дивергенция представляет собой один из наиболее актуальных и методологически обоснованных инструментов для верификации статистических моделей в исследованиях влияния факторов окружающей среды на здоровье человека.
Для моделирования нелинейных зависимостей между информативными показателями и прогноза широко используется ансамблевый метод XGBoost (eXtreme Gradient Boosting). Данный алгоритм представляет собой одну из наиболее эффективных и масштабируемых реализаций градиентного бустинга на деревьях решений [11]. В основе XGBoost лежит последовательное построение деревьев, где каждое новое дерево обучается на остатках (ошибках) предыдущих, что позволяет компенсировать их недостатки и постепенно улучшать качество прогноза. Ключевыми преимуществами XGBoost перед классическими реализациями градиентного бустинга являются: (1) встроенная L1- и L2-регуляризация в целевой функции, предотвращающая переобучение и повышающая обобщающую способность модели; (2) автоматическая обработка пропущенных значений без необходимости предварительной импутации; (3) параллельная обработка при построении деревьев, обеспечивающая высокую вычислительную эффек- тивность; (4) возможность оценки важности признаков, что позволяет интерпретировать вклад каждого предиктора в модель. Благодаря этим свойствам XGBoost устойчиво работает с табличными данными малого и среднего размера, часто превосходя по точности как линейные модели, так и более сложные архитектуры, включая нейронные сети. В последние годы метод активно применяется в экологическом моделировании и эпидемиологических исследованиях для прогнозирования рисков, связанных с загрязнением окружающей среды [12–19].
В связи с этим актуальной задачей является разработка методологии, позволяющей не только выявлять статистически значимые ассоциации, но и объективно оценивать, насколько выбранная модель воспроизводит совместное распределение, например, биохимических показателей крови при изменении концентраций содержащихся в ней поллютантов.
В настоящей работе на примере данных по содержанию меди и никеля в крови детской популяции и соответствующих лабораторных маркеров (нейтрофилы, эозинофилы, кортизол) [1–4] продемонстрировано применение XGBoost и KL-дивергенции как интегральной меры качества модели, позволяющей обоснованно сравнивать линейные и нелинейные подходы и выбирать наиболее адекватную структуру связи «биомаркеры экспозиции – биомаркеры эффекта». Кроме того, показано, как построенные модели могут быть использованы для организации системы обратного сигнала, обеспечивающей оперативное реагирование на ухудшение здоровья населения, ассоциированное с промышленными выбросами.
Цель исследования – разработка и апробация методологического подхода к оценке, верификации и обоснованию возможности применения моделей связи «концентрация химических веществ в биосредах – показатели крови» с использованием KL-дивергенции в качестве интегральной меры качества.
Материалы и методы. В отличие от классических регрессионных методов, ориентированных на точность точечного прогноза, предложен методологический подход, позволяющий количественно оценить, насколько выбранная модель воспроизводит совместное многомерное распределение биомаркеров, что критически важно при анализе сложных многокомпонентных воздействий. Описана методика поэтапного построения моделей – от линейной регрессии до нелинейных ансамблевых алгоритмов, а также процедура вычисления KL-дивергенции между фактическим и предсказанным распределениями показателей крови. На ограниченной пилотной выборке, включающей данные о содержании меди, ни- келя и трех биохимических маркеров (нейтрофилы, эозинофилы, кортизол), продемонстрирована работоспособность метода, выполнена сравнительная оценка различных моделей и интерпретация полученных значений KL-дивергенции. Для вычисления KL-дивергенции использована параметрическая аппроксимация совместного распределения трех показателей крови (нейтрофилы, эозинофилы, кортизол) многомерным нормальным законом. Для каждой обученной модели по предсказанным для каждого наблюдения значениям трех показателей сформирован трехмерный вектор прогнозов; по совокупности таких векторов выполнена оценка выборочных средних и ковариационной матрицы, которые задают многомерное нормальное распределение, используемое для расчета KL-дивергенции с фактическим распределением, построенным аналогичным образом по реальным данным. Это допущение вводится как вспомогательная рабочая гипотеза на этапе отработки методологического подхода и не является ограничением предлагаемой процедуры верификации в целом. Иллюстрация представленного методологического подхода подтвердила возможность его масштабирования на более обширные массивы данных и использования в исследованиях влияния факторов окружающей среды на здоровье человека. Дополнительно показана возможность интеграции построенных моделей в систему мониторинга для формирования управленческих сигналов.
Результаты и их обсуждение. На первом этапе анализа в модель в качестве биомаркеров аэрогенной экспозиции были включены три предиктора: бенз(а)-пирен, медь и никель. В дальнейшем бенз(а)пирен был исключен из-за крайне низкой вариативности концентраций (более 99 % нулевых значений). Для оставшихся двух предикторов (медь и никель) построены и сравнены модели различной сложности для трех откликов: нейтрофилы, эозинофилы, кортизол. Линейная регрессия, как и ожидалось, продемонстрировала крайне высокую KL-дивергенцию (порядка 107), что свидетельствует о полной неспособности линейной модели воспроизвести совместное распределение трех биохимических маркеров. Полиномиальная регрессия второй степени и GAM [20] также показали большие значения KL (230,6 и 36,5 соответственно), что указывает на недостаточность простых нелинейных аддитивных аппроксимаций2. Наилучшие результаты были достигнуты с использованием ансамблевых методов: Random Forest позволил снизить KL до 2,01, а XGBoost до 1,73, что является наименьшим значением среди всех рассмотренных моделей. Полное сравнение KL-дивергенции для всех моделей представлено в табл. 1 (значения идентичны ранее полученным, но относятся к новым откликам).
Таблица 1
Сравнение KL-дивергенции для различных моделей
|
Модель |
KL-дивергенция |
|
Линейная регрессия |
2,32·10⁸ |
|
Ридж-регрессия |
8,83·10⁹ |
|
Полиномиальная (степень 2) |
4,36·10⁷ |
|
GAM |
36,49 |
|
Random Forest |
2,01 |
|
XGBoost |
1,73 |
|
Линейная (лог-преобр. y) |
2,17·10⁶ |
|
Линейная (стандартизация) |
3,76·10⁷ |
Важно отметить, что традиционные метрики точности прогноза, такие как R2, для всех рассмотренных моделей оказались отрицательными (в диапазоне от -0,01 до -0,39), что типично для данных с низким отношением «сигнал / шум». Однако в контексте решаемой задачи основное внимание уделяется способности модели воспроизводить совместное многомерное распределение откликов, оцениваемое через KL-дивергенцию. Именно поэтому XGBoost, несмотря на отрицательный R 2, признан лучшим по информационному критерию.
Анализ значимости признаков для XGBoost (рис. 1) показал, что вклад меди и никеля не может быть разделен – в использованной пилотной выборке концентрации этих металлов оказались практически линейно зависимыми (коэффициент корреляции Пирсона r = 0,9999).
Это привело к тому, что XGBoost использовал только один из двух признаков (медь), а важность никеля стала равна нулю. Это не означает, что никель не оказывает влияния – напротив, в реальных промышленных выбросах эти металлы поступают совместно, и их раздельный вклад можно оценить только при наличии данных с существенно различающимися соотношениями (например, из разных территорий или в разные сезоны). Поэтому для целей управления качеством среды целесообразно рассматривать общую концентрацию меди и никеля (или их сумму) как интегральный показатель металлической нагрузки. Такой подход не только обходит проблему мультиколлинеарности, но и упрощает внедрение системы обратного сигнала, так как позволяет использовать один пороговый уровень для всего комплекса металлов. При расширении базы данных (включение других городов, периодов, индивидуальных измерений) модель сможет разделить вклады каждого металла, но уже сейчас можно утверждать, что именно металлическая нагрузка является драйвером изменений содержания нейтрофилов, эозинофилов и кортизола, а не какой-то один отдельный элемент.
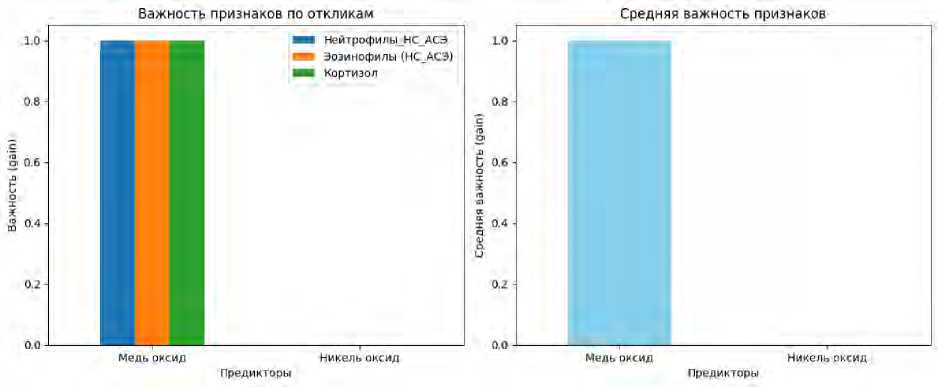
б
а
Рис. 1. Важность признаков для XGBoost-моделей: а – важность (gain) для каждого отклика. Из-за сильной корреляции между медью и никелем ( r ≈ 1,0) модель использует только один предиктор – медь; важность никеля равна нулю;
б – средняя важность по трем откликам
На рис. 2 представлены гистограммы сравнения фактического и предсказанного распределений для каждого нового биохимического маркера, наглядно иллюстрирующие степень соответствия моделей.
Для дополнительной визуальной диагностики качества воспроизведения распределений были построены Q–Q (квантиль – квантиль) графики (рис. 3). На всех графиках точки в центральной области хорошо ложатся на диагональ, однако в области нижних и верхних квантилей наблюдается систематическое отклонение: предсказанные значения оказываются ближе к медиане, чем фактические, что указывает на сохраняющуюся гетерогенность выборки и необходимость стратификации по чувствительным подгруппам.
Важным практическим результатом разработанного подхода является возможность использования построенных моделей для автоматической генерации управленческих сигналов в системе мониторинга качества объектов среды обитания. Идея заключается в том, чтобы по результатам лабораторного обследования в рамках гигиенических исследований, расследований экспертиз населения (например, по содержанию металлов в крови и биохимическим маркерам и др.) оперативно оценивать, превышают ли наблюдаемые отклонения допустимые пороги, и, если наблюдается превышение, то инициировать проверку источников загрязнения. Для этого предложена система из трех сценариев, различающихся по степени серьезности и рекомендуемым действиям. Сценарии основаны на популяционных индикаторах, которые легко вычисляются из индивидуальных данных с использованием шкалы уровней категорий риска, определенной в нормативной базе. Каждому показателю (медь, никель, содержание нейтрофилов, эозинофилов и кортизола) в зависимости от возраста и пола сопоставлены пять уровней риска (от пренебрежимо малого до очень высокого), что позволяет для каждого обследованного определить, находится ли его значение в зоне риска.
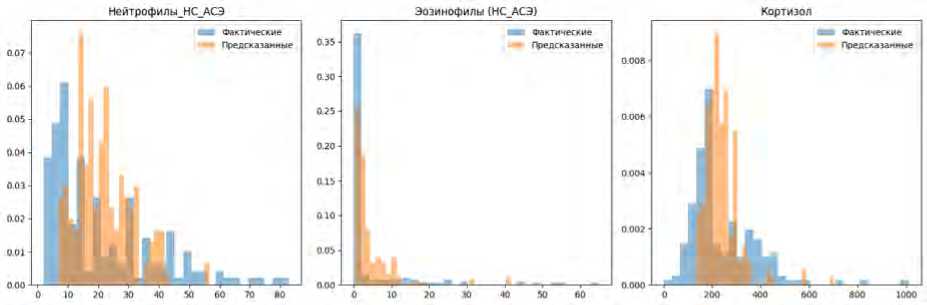
Рис. 2. Гистограммы сравнения фактического и предсказанного распределений для каждого биохимического маркера
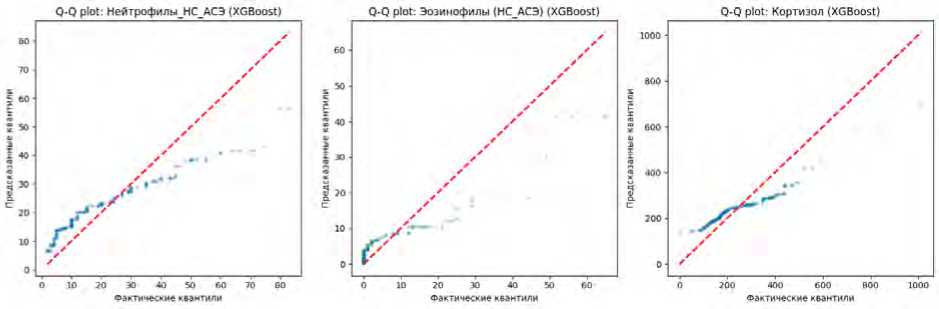
Рис. 3. Q–Q графики (квантиль – квантиль) для сравнения квантилей фактических и предсказанных значений
Первый сценарий («жёлтый» – умеренное отклонение, категория 3) активируется, когда доля лиц с риском категории ≥ 3 по металлам ≥ 20 %, и у ≥ 20 % из них отклонение хотя бы одного из трех маркеров (нейтрофилы > 7,0·109/л, эозинофилы > 0,5·109/л, кортизол > 536 нмоль/л) на 10–30 % выше нормы. Такой сигнал указывает на необходимость усиления лабораторного контроля, запроса у предприятий оперативных данных о выбросах и проведения внеплановых замеров атмосферного воздуха.
Второй сценарий («оранжевый» – значительное отклонение) предполагает, что доля лиц с уровнем риска категории 4 или выше по меди или никелю достигает 40 %, частота случаев с нейтрофилами или кортизолом больше полутора норм и в 2 раза или более выше среднего фонового значения (рассчитанного за предшествующий период). В этой ситуации рекомендуется ввести временные ограничения на выбросы для конкретных производств, организовать медицинское обследование групп риска и информирование.
Третий сценарий («красный» – критическое состояние) фиксируется, если у 5–10 % обследованных одновременно наблюдаются: уровень риска категории 5 по меди или никелю и эозинофилы > 1,0·109/л, кортизол > 900 нмоль/л, нейтрофилы > 14·109/л. Это требует немедленного приостановления работы источника загрязнения (или снижения выбросов не менее чем на 50 %) до выяснения причин, а также экстренных медицинских мероприятий для экспонированных лиц.
Расчет этих сценариев легко автоматизировать: после каждого массового обследования достаточно применить к данным обученную модель XGBoost (или, в упрощенном варианте, непосредственно правила, основанные на уровнях риска) и вычислить доли населения, попадающего под каждый критерий. Преимущество использования XGBoost заключается в том, что он дает не только точечные предсказания биомаркеров, но и позволяет оценить совместное распределение, что повышает надежность обнаружения отклонений. Однако даже без модели, на основе только референтных интервалов, можно получить достаточно надежные сигналы, если шкала риска валидирована. В пилотном исследовании выполнена проверка работоспособности такого подхода на примере данных Норильска. Применение описанных правил к выборке из более чем 500 человек позволило выявить зоны, где доля детей с критическими отклонениями превышала 5 %, что может служить основанием для внеплановых проверок. Следовательно, предложенная система обратного сигнала переводит результаты лабораторного мониторинга в действенный инструмент управления качеством среды, обеспечивая раннее предупреждение нарушений здоровья, обусловленных аэрогенным воздействием компонентов промышленных выбросов.
Ключевой вопрос при формировании предписаний для предприятий – в отношении каких конкретно веществ требуются первоочередные ограничения. В условиях сильной корреляции между концентрациями меди и никеля ( r ≈ 1,0) раздельная оценка их вклада в изменение биомаркеров невозможна.
В пилотной выборке доля лиц с превышением порога 3 категории риска по общей нагрузке (сумма нормированных концентраций) составила 34 %, что указывает на значительное распространение эффекта. Для контроля рекомендуется использовать этот интегральный показатель в качестве основы для всех трех сценариев обратного сигнала.
Если в анализ включены другие металлы (алюминий, хром, марганец), алгоритм остается неизменным: для каждого металла вычисляется важность и доля превышений, затем они ранжируются. Однако при сильной корреляции между ними также следует переходить к суммарным показателям. Это позволяет формировать адресные предписания с указанием конкретных веществ и желаемого процента сокращения выбросов.
Для перехода от статистических показателей к управленческим решениям мы предлагаем четырехуровневую шкалу срочности, которая интегрирует данные о превышениях металлов и отклонениях биомаркеров. Шкала построена так, чтобы обеспечить градацию ответных мер – от усиленного мониторинга до экстренного сокращения выбросов (табл. 2).
Таблица 2
Четырехуровневая шкала срочности принятия управленческих решений
|
Уровень |
Название |
Критерии (популяционные) |
Срочность принятия решений |
Действия |
|
Зеленый |
Благополучный |
Доля с риском категории ≥ 3 < 10 % и отклонения маркеров < 5 % |
Плановая |
Мониторинг |
|
Желтый |
Умеренное отклонение |
Доля с риском категории ≥ 3 ≥ 20 % и у ≥ 20 % из них отклонение маркеров > 10 % |
1–2 недели |
Усиленный контроль |
|
Оранжевый |
Значительное отклонение |
Доля с риском категории ≥ 4 ≥ 40 % и доля с нейтрофилами / кортизолом > 1,5 × физ.нормы в ≥ 2 раза выше фона |
3–5 дней |
Ограничения выбросов, профосмотры |
|
Красный |
Критическое состояние |
У ≥ 5 % обследованных сочетание риска категории 5 по металлам и эозинофилы > 1,0 и кортизол > 900 и нейтрофилы > 14 |
Немедленно |
Приостановка источника, экстренные меры |
Пороговые значения долей (20; 40; 5 %) выбраны на основе эпидемиологических рекомендаций и практики социально-гигиенического мониторинга. Они соответствуют уровням, при которых начинают регистрироваться статистически значимые изменения в популяционных показателях здоровья. При необходимости пороги могут быть скорректированы с учетом местных особенностей (размер выборки, чувствительность групп).
Алгоритм автоматического присвоения уровня предусматривает после каждого массового обследования запуск скрипта, который:
– для каждого человека определяет уровень риска по каждому металлу;
– вычисляет доли населения, попадающие под каждый критерий;
– сравнивает их с порогами и присваивает территории один из четырех уровней;
– генерирует формализованное заключение с указанием: приоритетных металлов (по описанному выше ранжированию), процента населения с превышениями, рекомендуемых мер и сроков их выполнения.
Это позволяет перевести данные лабораторного мониторинга в четкие, измеримые и своевременные управленческие воздействия, что является конечной целью предлагаемого подхода.
Выводы. Полученные результаты убедительно демонстрируют, что предложенная методология на основе KL-дивергенции позволяет объективно сравнивать модели и выбирать наиболее адекватную структуру связи, а также подтверждает необходимость использования нелинейных подходов при анализе зависимости «маркеры экспозиции – маркеры эффекта». Снижение KL-дивергенции с 107 (линейная модель) до 1,73 (XGBoost) свидетельствует о существенном улучшении воспроизведения совместного распределения показателей крови при учете нелиней- ностей и взаимодействий. Особо важно подчеркнуть, что разработанный подход не привязан к конкретному набору биомаркеров или загрязнителей. Он легко масштабируется на любое количество анализов (биохимических, иммунологических, генетических, гормональных) и любой спектр поллютантов – достаточно лишь подать соответствующие данные на вход моделей. Это открывает возможности для создания универсальных систем раннего предупреждения, которые могут адаптироваться под изменяющиеся условия окружающей среды и новые приоритетные вещества без перестройки методологической базы. Внедрение таких систем в практику социальногигиенического мониторинга позволит оперативно и обоснованно переходить от лабораторных данных к управленческим решениям, минимизируя время реакции на экологически обусловленные угрозы здоровью населения.
Несмотря на указанные ограничения (необходимость актуальных референтных интервалов, проверка переносимости на другие регионы), представленный подход уже на пилотных данных показывает свою работоспособность и может быть рекомендован для более масштабных гигиенических и эпидемиологических исследований, где требуется объективная верификация моделей и сравнение альтернативных статистических стратегий. В перспективе планируется расширить набор предикторов (включить другие металлы, органические загрязнители) и откликов (добавить иммунологические и генетические маркеры), а также внедрить динамическое обновление моделей по мере поступления новых данных.
Финансирование. Исследование не имело спонсорской поддержки.
