
Методы кластеризации для сегментации товаров в задачах розничной аналитики
Журнал: Сетевое научное издание «Системный анализ в науке и образовании» @journal-sanse
Рубрика: Моделирование и анализ данных
Статья в выпуске: 3, 2026 года.
Бесплатный доступ
Статья посвящена обзору и сравнительному анализу методов кластеризации, применяемых для сегментации товарного ассортимента в сфере розничной торговли. Актуальность исследования обусловлена необходимостью автоматизации процессов анализа больших объемов транзакционных данных и перехода от субъективных экспертных оценок к объективным моделям управления ассортиментом и ценообразованием. В работе рассматриваются классические и современные подходы к кластеризации, включая иерархические методы, алгоритмы разделения, методы на основе плотности, а также модели на основе гауссовых смесей. Особое внимание уделяется вопросам предобработки данных, выбора оптимального числа кластеров с использованием метрик оценки качества и интерпретации полученных сегментов в контексте ценовых категорий и паттернов потребительского спроса. Проводится сравнительная оценка методов по критериям масштабируемости, устойчивости к выбросам и интерпретируемости результатов. Результаты работы могут быть использованы при построении автоматизированных аналитических систем поддержки принятия решений в розничной торговле.
Короткий адрес: https://sciup.org/14139474
IDS: 14139474 | УДК: 004.8
Clustering methods for product segmentation in retail analytics problems
This article provides a review and comparative analysis of clustering methods used for product assortment segmentation in retail. The relevance of the study stems from the need to automate the analysis of large volumes of transactional data and the transition from subjective expert assessments to objective models of assortment and pricing management. The paper examines classical and modern approaches to clustering, including hierarchical methods, partitioning algorithms, density-based methods, and Gaussian mixture models. Particular attention is paid to data preprocessing, selecting the optimal number of clusters using validation metrics, and interpreting the resulting segments in the context of price categories and consumer demand patterns. A comparative evaluation of the methods is conducted based on scalability, robustness to outliers, and interpretability of results. The results of the study can be used in the development of automated analytical decision support systems in retail.
Текст научной статьи Методы кластеризации для сегментации товаров в задачах розничной аналитики
Методы кластеризации для сегментации товаров в задачах розничной аналитики / М. В. Алексюк, Д. А. Терешкин, А. А. Шабуров [и др.]// Системный анализ в науке и образовании. 2026. № 3. С. 95-105. EDN: GFEMPB. URL:
4.0)
Aleksiuk M.V., et al. Clustering methods for product segmentation in retail analytics problems. System analysis in science and education, 2026;(3):95–105 (in Russ). EDN: GFEMPB. URL:
В современной розничной торговле управление ассортиментом, ценообразованием и прогнозированием спроса сопровождается необходимостью анализа значительных объемов структурированных и динамических данных. Это могут быть исторические данные о продажах и ценах, информация о товарных категориях и брендах, а также внешние факторы, такие как сезонность и экономические циклы. Такие данные часто характеризуются сложными взаимосвязями,
Сетевое научное издание «Системный анализ в науке и образовании» Выпуск №3, 2026 год нелинейными зависимостями и скрытыми паттернами, что создает серьезные трудности для их ручного анализа и интерпретации. Особую сложность представляет задача динамической сегментации товаров, требующая регулярного пересмотра границ ценовых кластеров [1].
Традиционный подход - ручное назначение границ сегментов категорийным менеджером -обладает рядом недостатков: субъективностью, высокой трудоемкостью при пересмотре границ в динамике и невозможностью учета статистической структуры данных. Методы автоматической кластеризации позволяют преодолеть эти ограничения. В работе рассматриваются различные методы, которые охватывают все основные семейства алгоритмов кластеризации, для решения задачи сегментации товаров из набора исходных данных.
-
1. Методы кластеризации
-
1.1. Статистическое правило: ABC-анализ
-
Методы на основе статистических правил представляют собой наиболее простую и традиционную группу подходов к сегментации товарного ассортимента. Их суть заключается в применении заранее определенных эмпирических правил и пороговых значений, основанных на накопленном опыте и статистических закономерностях распределения данных (в первую очередь, по выручке или цене), без использования процедур обучения модели. Главными преимуществами таких методов являются высокая интерпретируемость, детерминированность результатов, минимальные вычислительные затраты и понятность для бизнес-пользователей. Они не требуют нормализации данных, подбора гиперпараметров или значительных вычислительных ресурсов, что делает их удобным инструментом для быстрой первичной сегментации [2].
Наиболее известным и широко применяемым представителем этой группы является ABC -анализ. Алгоритм реализует принцип Парето, на основе которого товары разделяются на категории:
-
- категория A - примерно 20% товаров, дающих 80% выручки;
-
- категория B - 30% товаров, дающих 15% выручки;
-
- категория C - 50% товаров, дающих 5% выручки.
В модифицированном варианте, использованном в работе, после присвоения категорий A / B / C по выручке вычисляются ценовые пороги перехода между категориями, которые затем служат границами ценовых сегментов. К достоинствам метода относятся детерминированность, отсутствие необходимости в обучении, масштабируемость и прозрачность для бизнеса, тогда как недостатками выступают фиксированное число сегментов и чувствительность к выбросам.
Методы разбиения - это одна из наиболее распространенных групп алгоритмов кластеризации. Их суть заключается в разбиении набора объектов на заранее заданное число кластеров путем оптимизации выбранной целевой функции. Основная особенность данных методов состоит в итеративном поиске оптимального расположения центров кластеров и перераспределении объектов между ними. Они отличаются высокой скоростью работы, простотой реализации и хорошей масштабируемостью, однако обычно требуют предварительного задания количества кластеров и чувствительны к инициализации и форме распределения данных [3, 4].
K - means - наиболее популярный и широко распространенный алгоритм среди методов разбиения. Центроидом каждого кластера выступает среднее арифметическое всех точек, входящих в этот кластер. Целевой функцией алгоритма является внутрикластерная дисперсия (сумма квадратов расстояний от точек до центроидов). Оптимизация (минимизация) этой функции осуществляется итеративно: на каждом шаге пересчитываются положения центроидов как среднее арифметическое точек, входящих в кластер, после чего точки перераспределяются к ближайшему центроиду. Алгоритм обеспечивает высокую масштабируемость и эффективно работает с данными, имеющими примерно сферическую форму кластеров [3].
-
1.3. Иерархический метод: Agglomerative Clustering
Иерархические методы кластеризации объединяют объекты в кластеры путем последовательного объединения или разделения, формируя древовидную структуру. Их ключевая особенность заключается в построении дендрограммы - наглядного иерархического представления взаимосвязей между объектами, которое позволяет визуально оценивать структуру данных на разных уровнях детализации. В отличие от методов разбиения, иерархические алгоритмы не требуют предварительного задания числа кластеров и дают возможность аналитику выбрать оптимальный уровень разбиения уже после построения модели [5].
Наиболее распространенным представителем этой группы является агломеративная иерархическая кластеризация ( Agglomerative Clustering ). Она работает по принципу «снизу-вверх»: каждый объект изначально рассматривается как отдельный кластер. На каждом последующем шаге алгоритм объединяет два ближайших кластера до тех пор, пока все объекты не окажутся в одном кластере. Требуемое число кластеров получают путем «среза» дендрограммы на соответствующем уровне.
Среди наиболее распространенных методов связи в агломеративной кластеризации выделяют:
-
- Single linkage (ближайшего соседа) - объединяет кластеры по минимальному расстоянию между точками;
-
- Complete linkage (дальнего соседа) - по максимальному расстоянию;
-
- Average linkage - по среднему расстоянию между всеми парами точек;
-
- Ward - по критерию минимизации прироста дисперсии.
В работе используется метод связи Ward . Данный метод на каждом шаге выбирает те два кластера, объединение которых приводит к наименьшему приросту общей внутрикластерной дисперсии (суммы квадратов расстояний от точек до центроидов) [6].
Метод Ward лучше других формирует компактные, сферические и хорошо разделимые кластеры примерно сопоставимого размера. Это особенно важно для задачи ценовой сегментации, где требуется четкое разделение товаров на интерпретируемые сегменты.
-
1.4. Методы на основе плотности: DBSCAN и OPTICS
Методы на основе плотности представляют принципиально иной подход к кластеризации по сравнению с методами разбиения и иерархическими алгоритмами. Их основная идея заключается в том, что кластеры определяются как области высокой плотности объектов, разделенные областями низкой плотности или разреженными пространствами. Ключевыми особенностями этой группы методов являются способность выявлять кластеры произвольной формы, автоматическое определение числа кластеров, а также встроенная устойчивость к шуму и выбросам, которые помечаются как отдельный класс «шум». Эти методы не требуют предварительного задания количества кластеров и хорошо работают с данными неэллиптической структуры [7].
DBSCAN ( Density - Based Spatial Clustering of Applications with Noise ) - базовый и наиболее известный алгоритм плотностной кластеризации. Он выделяет кластеры на основе двух параметров: радиуса окрестности и минимального числа точек в этой окрестности. Точки, для которых в окрестности недостаточно других точек, считаются шумом. Алгоритм эффективен при относительно равномерной плотности данных [7].
OPTICS ( Ordering Points To Identify the Clustering Structure ) является развитием идей метода DBSCAN . Вместо построения конечных кластеров алгоритм создает упорядоченную последовательность точек по плотности, что позволяет анализировать структуру данных на разных уровнях масштаба. Благодаря этому OPTICS лучше справляется с данными переменной плотности и значительно упрощает задачу подбора параметров по сравнению с DBSCAN [7].
К преимуществам плотностных методов для решения задачи сегментации товаров относятся высокая устойчивость к выбросам и возможность обнаружения нестандартных ценовых ниш. Основным ограничением является чувствительность к выбору параметров и более высокая вычислительная сложность на очень больших выборках [7].
-
1.5. Вероятностная модель: Gaussian Mixture Models (GMM)
-
2. Вычислительный эксперимент
2.1. Исходные данные и методика эксперимента
В исследовании использовались реальные транзакционные данные крупной розничной сети по формату магазинов «Гипермаркеты» за период 2022-2024 гг. с помесячной детализацией. Исходный набор данных включает следующие поля:
Вероятностные методы кластеризации рассматривают данные как результат генерации из некоторой вероятностной модели. В отличие от предыдущих методов, где каждый объект однозначно относится только к одному кластеру, вероятностные подходы реализуют алгоритм, где объекты получают вероятность принадлежности к каждому из кластеров, причем сумма этих вероятностей равна единице. Основная суть таких методов заключается в оценке параметров вероятностной модели, которая наиболее правдоподобно описывает наблюдаемые данные. Ключевыми преимуществами вероятностных моделей являются гибкость, возможность учета неопределенности, богатая статистическая интерпретация результатов и способность моделировать кластеры различной формы, размера и ориентации [8].
Наиболее популярной и эффективной реализацией вероятностного подхода является метод Gaussian Mixture Models ( GMM) - модель гауссовых смесей. Модель предполагает, что все данные генерируются из смеси конечного числа многомерных нормальных (гауссовых) распределений. Каждый кластер описывается тремя параметрами: вектором математического ожидания (центром), ковариационной матрицей (определяющей форму и ориентацию кластера) и весом смеси (априорной вероятностью кластера). Важным аналитическим преимуществом GMM в задачах ценовой сегментации является возможность выявления товаров, находящихся на границе между сегментами. Если вероятности принадлежности товара к двум соседним сегментам являются сопоставимыми, это означает, что товар обладает переходными характеристиками и может быть чувствителен к небольшим изменениям цены [8].
-
- sku - уникальный идентификатор товара;
-
- art - артикул;
-
- brand - бренд;
-
- format - формат магазина (гипермаркеты, супермаркеты, магазины у дома, минимаркеты, хард-дискаунтеры, e-commerce );
-
- year, month - год и месяц продаж;
-
- price - цена единицы товара в рублях;
-
- RUB - выручка в рублях;
-
- PACKS - количество проданных упаковок;
-
- KG - вес в килограммах;
-
- FLAVOUR / INGREDIENTS - вкус/состав;
-
- ITEM WEIGHT ACTUAL , WEIGHT 2 - весовые характеристики.
Исходная выборка содержит 5773 уникальных товара. Единицей анализа выступает уникальный SKU в разрезе выбранного формата магазина, года и месяца (или в агрегации по всем периодам). Для каждого SKU рассчитываются два ключевых признака: средняя цена и медианная цена. Именно эти два признака используются в качестве основных характеристик для последующей кластеризации и определения ценовых сегментов («Эконом», «Средний-», «Средний», «Средний+», «Премиум»).
Все расчеты проводились на языке программирования Python 3. Для реализации основных этапов исследования использовался следующие технологии:
Для оценки качества кластеризации используются три общепризнанные внутренние метрики [9], не требующие внешней разметки данных.
Коэффициент силуэта измеряет, насколько хорошо каждый объект размещен в своем кластере по сравнению с ближайшим соседним кластером. Значение коэффициента находится в диапазоне от -1 до 1. Чем ближе значение к 1, тем лучше объект размещен в своем кластере, а кластеры хорошо отделены друг от друга. Коэффициент рассчитывается по формуле (1):
5 G [-1,1] S =
b — а тах(а, b) ’
где a - среднее расстояние от товара до всех остальных товаров в его же кластере;
-
b - среднее расстояние от товара до всех товаров ближайшего соседнего кластера.
Индекс Калински-Харабаса оценивает качество кластеризации через отношение дисперсии между кластерами к дисперсии внутри кластеров. Более высокие значения индекса указывают на компактные и хорошо разделимые кластеры. Индекс рассчитывается по формуле (2):
СН =
о
Г SSW 1 L п — к\ где SSB - сумма квадратов расстояний от центра каждого кластера до общего центра всех данных, взвешенная на размер кластера;
SSW - сумма квадратов расстояний от каждой точки до центра ее кластера;
k - число кластеров;
n - общее число товаров.
Индекс Дэвиса-Болдина рассчитывается как среднее соотношение внутрикластерного разброса к расстоянию между центрами кластеров. Чем ниже значение индекса, тем лучше качество кластеризации, поскольку это свидетельствует о компактных кластерах и значительном расстоянии между ними. Индекс рассчитывается по формуле (3):
DB =
к
iymax(S£S\ к^ ‘^ \ Mij /
где S i - средний разброс внутри кластера i ;
S j - средний разброс внутри кластера j ;
M ij - расстояние между центрами кластеров i и j ; k - число кластеров (5).
2.3. Результаты эксперимента
На рисунке 1 представлен результат применения модифицированного (количество конечных сегментов расширено до 5) ABC -анализа к исходным данным. График демонстрирует распределение товаров в пространстве «медианная цена – средняя цена». Вертикальные пунктирные линии соответствуют автоматически рассчитанным ценовым порогам перехода между сегментами. Хорошо видно, как ABC -анализ формирует относительно линейное разделение, однако в верхнем диапазоне цен (сегмент «Премиум») наблюдается значительный разброс, а некоторые товары с высокой средней ценой попадают в категорию «Шум/Выбросы».
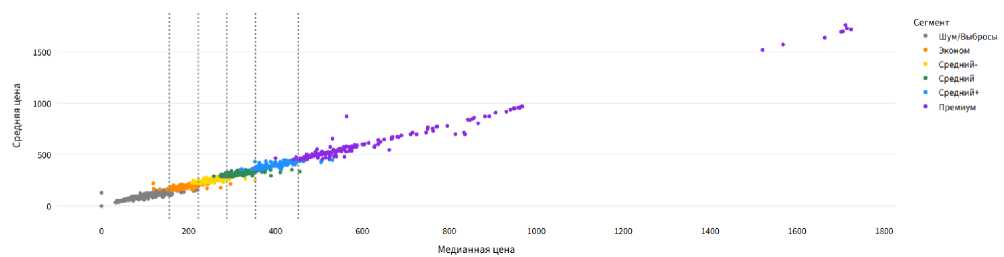
Рис. 1. Пример применения метода ABC-анализа к исходным данным
На рисунке 2 представлен результат кластеризации с помощью метода K - means . Алгоритм четко разделил товары на пять ценовых сегментов. Видно, что сформированы достаточно компактные и линейно разделимые кластеры, особенно в диапазоне низких и средних цен. В премиум-сегменте наблюдается небольшое количество точек с высокой дисперсией, что характерно для товаров высокой ценовой категории.
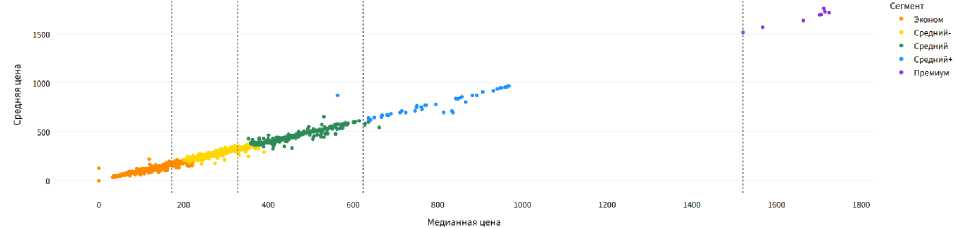
Рис. 2. Пример применения метода K-means к исходным данным
На рисунке 4 представлен результат работы агломеративной иерархической кластеризации с методом связи Ward . Алгоритм последовательно объединял наиболее похожие объекты, формируя иерархическую структуру. Благодаря использованию метода Ward сегменты получились компактными и хорошо сбалансированными. Особенно хорошо видна четкая граница между средними и высокими ценовыми категориями. Распределение точек в сегменте «Премиум» выглядит структурированным и однородным. Агломеративная кластеризация с методом Ward показала одно из лучших визуальных разделений.
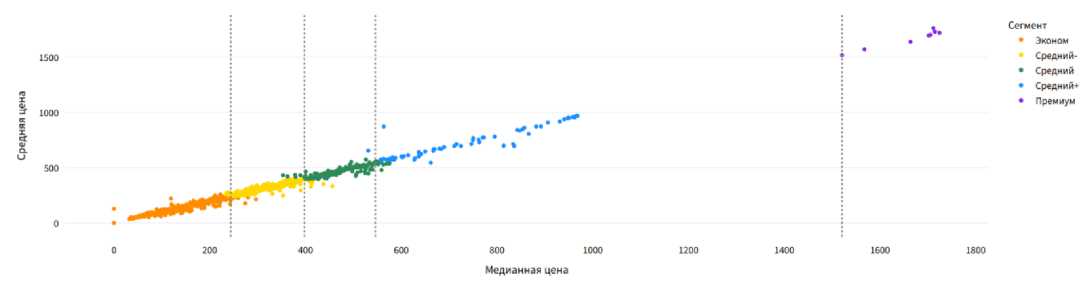
Рис. 4. Пример применения агломеративной кластеризации к исходным данным
На рисунке 5 представлен результат кластеризации с помощью алгоритма DBSCAN . На графике видно характерное для этого алгоритма поведение: основной массив SKU (преимущественно средний ценовой диапазон) был объединен в один крупный кластер. Кластеры «Эконом» и «Средний-» включают относительно небольшое количество SKU . Самым большим по численности оказался сегмент «Средний», что отражает реальную структуру ассортимента – преобладание товаров массового спроса в средней ценовой категории. В сегменты «Премиум» и особенно «Средний+» попало всего несколько SKU . Такое распределение демонстрирует способность DBSCAN выявлять плотностные структуры данных, но также подчеркивает его склонность объединять большую часть товаров в один доминирующий кластер при наличии выраженной основной плотности. Выбросы и редкие высокодоходные товары были выделены в отдельные небольшие кластеры.
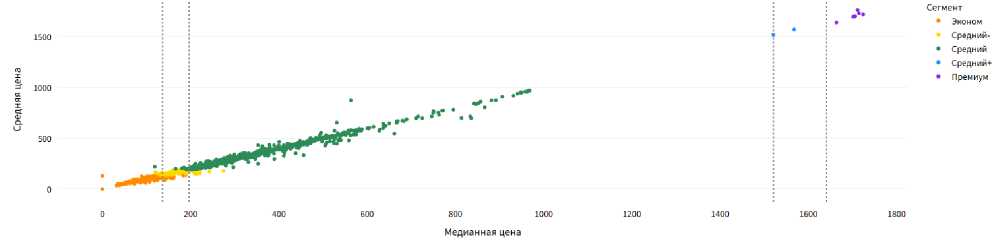
Рис. 5. Пример применения метода DBSCAN к исходным данным
На рисунке 6 представлен результат кластеризации с помощью метода OPTICS . На графике видно более сбалансированное и детальное разделение товаров по сравнению с результатом применения метода DBSCAN . Однако результат оказался достаточно необычным: сегмент «Премиум» стал самым многочисленным. Большая часть товаров была отнесена именно к высокой ценовой категории. При этом сегменты «Эконом» и «Средний-» получились относительно небольшими, а «Средний» и «Средний+» заняли промежуточное положение. Такое распределение может быть связано с особенностями внутренней структуры данных и выбранными параметрами алгоритма, которые привели к тому, что метод объединил значительную часть товаров в один крупный плотный кластер в верхнем ценовом диапазоне.
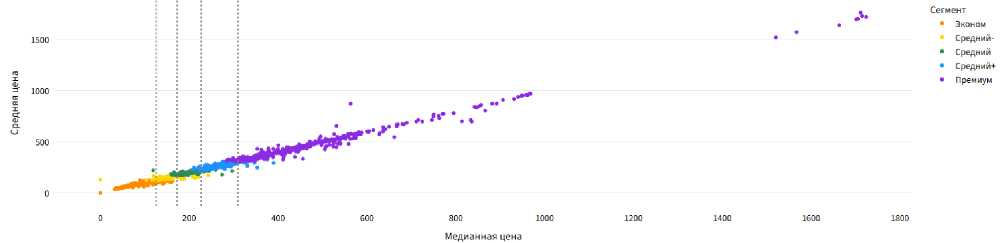
Рис. 6. Пример применения метода OPTICS к исходным данным
На рисунке 7 представлен результат кластеризации с помощью вероятностной модели Gaussian Mixture Models ( GMM ). Алгоритм GMM реализовал «мягкую» кластеризацию, однако характерной особенностью данного разбиения стало крайне малое количество товаров в низких ценовых сегментах: «Эконом» и «Средний-» практически отсутствуют. Основная масса товаров сконцентрировалась в сегментах «Средний», «Средний+» и «Премиум». Это может указывать на относительно низкую пригодность данного метода для жесткой ценовой сегментации в условиях сильной асимметрии распределения цен в данных.
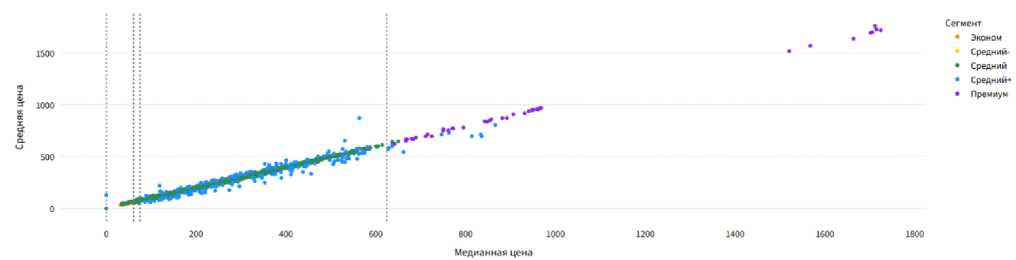
Рис. 7. Пример применения GMM к исходным данным
Результаты оценки качества проведенной кластеризации товаров из исходных данных представлены в таблице 1.
Примечание: для ABC -анализа и GMM метрики внутренней валидации не применимы по определению.
Табл. 1. Метрики оценки методов кластеризации по результатам эксперимента
2.4. Интерпретация результатов
Метод K - means продемонстрировал наилучшие результаты по всем трем метрикам. Высокий коэффициент силуэта (0,573) указывает на достаточно хорошую отделимость кластеров, а максимальный индекс Калински–Харабаса (почти 7 000) подтверждает компактность кластеров при сильной межкластерной дифференциации. Низкий индекс Дэвиса–Болдина (0,449) также свидетельствует в пользу качества. Основное объяснение - ценовые данные после стандартизации приобретают форму, близкую к сферическим кластерам, для которых применение метода K - means является оптимальным.
Agglomerative clustering с методом связи ward показал практически идентичный с методом K - means результат (силуэт 0,568 против 0,573). Это важно, поскольку агломеративный метод детерминирован и не зависит от случайной инициализации центроидов. При достаточных вычислительных ресурсах он может быть рекомендован как альтернатива метода K - means .
Алгоритмы DBSCAN и OPTICS показали более низкие значения метрик, что объясняется принципиальным несоответствием между формой кластеров, выделяемых плотностными методами, и геометрическими предположениями, заложенными в метриках. Однако это не означает, что плотностные методы хуже: они эффективно выявляют нестандартные ценовые ниши и маркируют выбросы. В эксперименте DBSCAN идентифицировал 47 SKU как шум (~1% выборки), что имеет самостоятельную аналитическую ценность.
Метод GMM не сравнивался напрямую по метрикам, поскольку его вероятностная природа предполагает иные критерии оценки.
Метод ABC -анализ формально не оценивался метриками кластеризации, однако его практическая полезность для быстрой первичной сегментации остается высокой.
Заключение
В работе проведен сравнительный анализ методов кластеризации применительно к задаче сегментации товаров по ценам в розничной торговле. На основе вычислительного эксперимента на реальных данных и теоретического анализа свойств алгоритмов сформулированы следующие основные выводы:
Результаты исследования могут быть использованы при построении автоматизированных аналитических систем поддержки принятия решений в розничной торговле для прогнозирования цен и продаж товаров с учетом сезонности спроса.
