
Применение Real-ESRGAN для повышения качества изображений, получаемых радаром с синтезированной апертурой
Журнал: Труды Московского физико-технического института @trudy-mipt
Рубрика: Информатика и управление
Статья в выпуске: 3 (71) т.18, 2026 года.
Бесплатный доступ
Получаемые с помощью радара с синтезированной апертурой изображения всегда содержат спекл-шум, что затрудняет их анализ. Существующие методы фильтрации такого шума не позволяют подавить его без полного отсутствия побочных эффектов: ухудшение детализации, структурные искажения и т. п. В этой работе предложен новый подход к созданию методов фильтрации спекл-шума на основе моделей повышения разрешения. Данная методика продемонстрирована на Real-ESRGAN. Проведен сравнительный анализ полученных результатов относительно популярных алгоритмов: TransSAR, FANS и SAR-BM3D. При тестировании использовались показатели качества ENL, SSIM и LPIPS, а также оценка эффективности распознавания целевых объектов на обработанных изображениях по AP50. Полученные результаты свидетельствуют о том, что разработанный по предложенной методике метод реализует высококачественное подавление спекл-шума при практически полном сохранении детализации входного изображения, значительно превосходя по качеству обработки существующие алгоритмы.
Короткий адрес: https://sciup.org/142248879
IDS: 142248879 | УДК: 004.932.4
Application of the Real-ESRGAN to SAR images quality enhancement
Synthetic aperture radar images are inherently corrupted by speckle noise, which hinders their exploitation. Existing despeckling methods suffer from detrimental side effects, such as detail degradation and structural artifacts. This study proposes a novel approach to the design of speckle filtering methods that leverage super-resolution models by building upon them. The presented methodology is demonstrated using Real-ESRGAN. A comparative evaluation was conducted against established despeckling algorithms: TransSAR, FANS, and SAR-BM3D. Performance was assessed by utilizing ENL, SSIM, and LPIPS image quality metrics, alongside AP50 for evaluation of target recognition accuracy on the filtered images. Obtained results indicate that the method developed by following the proposed methodology achieves excellent speckle noise suppression performance while nearly perfectly preserving the input image details, significantly exceeding existing algorithms in terms of output quality.
Текст научной статьи Применение Real-ESRGAN для повышения качества изображений, получаемых радаром с синтезированной апертурой
Являясь всепогодным и не зависящим от времени суток средством дистанционного зондирования Земли (ДЗЗ), радиолокатор с синтезированной апертурой (РСА) применяется для решения широкого спектра задач [1], включая, например, детекцию целевых объектов [2] и классификацию подстилающей поверхности [3]. Эффективность анализа зависит от качества обрабатываемых снимков. Зашумленность изображения, его недостаточное разрешение и структурные искажения («артефакты») препятствуют извлечению полезной информации. При этом радиолокационные изображения (РЛИ) всегда покрыты спекл-шумом — мультипликативным шумом, имеющим интерференционную природу [4]. Соответственно подавление спекл-шума при как можно большем сохранении исходного разрешения и структурной целостности снимка является одной из важнейших задач обработки РЛИ.
Спектр существующих способов борьбы со спекл-шумом широк [4, 5] и предлагает богатый выбор. Например, инструментарий классических подходов охватывает решения от простейших некогерентных накоплений [6] и гомоморфных алгоритмов [7] до нелокальных негомоморфных [8-10] и мультиспектральных методов [11]. Однако сопутствующие негативные эффекты, такие как ухудшение разрешения, появление шумовых ореолов в области границ объектов на снимке и волнообразные искажения однородных областей РЛИ, обусловили необходимость разработки более совершенных алгоритмов. Вкупе со стремительным развитием методов машинного обучения в последние годы это привело к созданию ряда подходов на основе искусственных нейронных сетей (ИНС). Они представлены как моделями, разработанными в рамках парадигмы обучения с учителем (supervised learning), включая генеративно-состязательные [12] и трансформерные [13] ИНС, так и более современными методами, обучение которых не требует прямого доступа к эталонным снимкам [14, 15], что соответствует подходу self-supervised learning (SSL). Из-за отсутствия способа получения эталонного РЛИ с одновременно нулевым уровнем спекл-шума и максимальным разрешением разработка алгоритмов supervised-класса сопряжена с определенными трудностями процедуры создания набора данных, что в итоге приводит к пониженному качеству работы таких методов на реальных снимках относительно эффективности, достигаемой на синтетических [5]. В свою очередь, SSL-модели хоть и приближаются к supervised-методам по качеству реконструкции РЛИ без шума, в некоторых случаях даже превосходя их, в общем случае не могут предложить эталонный уровень эффективности, так как в результатах все равно будут присутствовать структурные искажения одних областей и чрезмерное сглаживание других. Наконец, разрабатываются гибридные подходы к фильтрации спекл-шума, в которых объединяются идеи глубокого обучения и классических алгоритмов [16]. Однако и такие методы не способны полностью подавить спекл-шум, сохранив все мельчайшие структурные особенности изображения. Таким образом, практика применения показывает, что любой предлагаемый метод будет в определенной степени размывать изображения, негативно влияя на их разрешение, и может внести структурные искажения на РЛИ. Подобные эффекты ухудшают детализацию, а потому затрудняют анализ обработанного снимка. Из-за этого требуется дальнейшая разработка комплексных подходов, направленная на повышение качества подавления спекл-шума при одновременном снижении влияния негативных эффектов обработки.
В то же время активно разрабатываются методы повышения разрешения РЛИ, задача которых заключается в улучшении детализации поступающих на вход изображений. В этой области тоже можно выделить две подгруппы алгоритмов: классические [17] и нейросетевые. Первые, как правило, характеризуются высокой чувствительностью к входным данным, включая параметры, регулирующие работу, поэтому для получения даже ограниченного улучшения входного РЛИ требуется тонкая настройка под каждый конкретный случай. Эта особенность побудила исследователей продолжить разработки в поисках более универсальных подходов. В результате развитие получили методы на основе ИНС, среди которых особенно высокой эффективностью отличаются генеративно-состязательные [18] и диффузионные [19] модели. Дальнейшее повышение качества обработки может быть до- стигнуто, например, путем использования тандемных [20] моделей, а также повышения стабильности и уменьшения ресурсоемкости за счет применения разделимых по глубине сверток и механизма покоординатного внимания [21]. Особый интерес представляют методы, объединяющие информацию из нескольких источников, так как в данном случае за счет синтеза признаков удается добиться более качественных результатов относительно подходов, использующих лишь одно входное изображение. Например, в исследовании [22] применялись совмещенные пары снимков радиолокационного и оптического спектров, а в статье [23] изучался подход, в рамках которого модель работала с серией снимков одной и той же территории, разнесенных по времени. Однако принцип действия, обеспечивающий сильные стороны такого класса алгоритмов, также порождает и слабые: для использования подобных методов необходимы дополнительные данные, помимо РЛИ, что обеспечивается не во всех случаях. Важно, что разработчики методов повышения разрешения РЛИ отмечают зависимость конечного результата от уровня шума на входном изображении: качество итогового снимка тем хуже, чем выше уровень шума [24]. При этом природа всех РЛИ такова, что они всегда покрыты спекл-шумом [4]. Это обстоятельство затрудняет улучшение детализации исходных снимков.
Соответственно возможным решением является последовательное применение алгоритмов подавления спекл-шума и повышения разрешения, что в итоге позволило бы одновременно подавить шум и сохранить детализацию. Однако в случае использования такого подхода методы будут работать без согласования между собой, что может негативно повлиять на результаты. В данном исследовании рассматривается иной подход, в рамках которого предлагается применение изначально созданного для повышения разрешения метода в качестве алгоритма подавления спекл-шума. В таком случае задачи по убиранию шума и сохранению детализации решаются согласованно, так как это происходит в результате работы одной и той же модели, запускаемой один раз. Дополнительным преимуществом здесь является сокращение временных затрат на получение результата, ведь вместо цепочки методов применяется лишь один.
Для использования предлагаемого подхода модель повышения разрешения требуется обучить классическим образом — на парах изображений с низким и высоким разрешением. Разница относительно традиционной процедуры лишь в том, что целевые РЛИ необходимо предварительно обработать каким-либо методом подавления шума. Полученный в результате такого обучения алгоритм переводит входные изображения размера Н х W в промежуточные размера N •Н х N •W, осуществляя фильтрацию спекл-шума с улучшенным сохранением детализации за счет устранения размытия и добавления высокочастотной компоненты. При этом промежуточное изображение может содержать структурные искажения, характерные как для методов повышения разрешения, так и для алгоритмов подавления шума. Однако подавляющая часть этих «артефактов» содержится в новых Н •W • (N2 — 1) пикселях. Переход от промежуточного снимка размера N • Н х N •W к финальному размера Н х W позволяет устранить большую часть искусственных искажений. В итоге обработанное РЛИ отфильтровано от спекл-шума, при этом детализация сохранена на уровне, соответствующем изображению Н х W с заданным разрешением в метрах на пиксель, а «артефакты» сведены к минимуму. При этом качество подавления шума предложенным методом может превысить таковое относительно алгоритма, использованного в ходе предварительной обработки целевых РЛИ, так как решается задача аппроксимации по всей обучающей выборке, а не интерполяции, что позволяет найти более оптимальное с точки зрения используемой функции потерь решение. Данный аспект аналогичен, например, моделям повышения разрешения в оптическом диапазоне, обученным на данных, которые подготовлены с использованием бикубической интерполяции [25].
В статье рассмотрено применение модели повышения разрешения оптических снимков Real-ESRGAN [26] в рамках предлагаемой методики фильтрации спекл-шума на РЛИ с улучшенным сохранением детализации и пониженным числом искажений результирующего изображения. Выбор Real-ESRGAN обусловлен тем, что эта модель, являясь популяр- ным представителем своего класса, обеспечивает низкое число «артефактов» и высокую устойчивость для широкого спектра сцен и сюжетов. Такие выгодные свойства повышают вероятность успешного дообучения на домене РЛИ. В работе приведен сравнительный анализ полученных результатов с одними из наиболее эффективных методов подавления спекл-шума [8, 9, 13]. Также описана разработанная авторами методика создания набора данных из комплексных РЛИ для обучения, валидации и тестирования модифицированного варианта Real-ESRGAN, работающего с амплитудными изображениями. Важно отметить, что несмотря на использование в данном исследовании модели Real-ESRGAN, предлагаемый подход универсален по своей формулировке и не имеет принципиальных ограничений на применение с другими нейросетевыми инструментами повышения разрешения. Таким образом, вклад данной работы состоит в следующем: 1) разработана и продемонстрирована методика применения модели повышения разрешения к задаче подавления спекл-шума на РЛИ; 2) выработан и применен на практике метод создания по комплексным РЛИ датасета из амплитудных изображений для такой модели; и 3) предложенный подход протестирован по метрикам ENL [27], LPIPS [28] и SSIM [29], а также по качеству работы модели распознавания Rol-Transformer [30] на изображениях до и после обработки.
В разделе «Методы» описаны предлагаемый подход к повышению качества РЛИ, процедура подготовки данных и методика тестирования, а также приведены технические детали архитектуры модели, эксперимента и используемой функции потерь. Раздел «Результаты» демонстрирует примеры работы алгоритмов, а также содержит их качественный и количественный анализ. Статья заканчивается разделом «Заключение», где приводятся выводы о проделанной работе и предлагаются направления для дальнейших исследований.
2. Методы2.1. Общее описание предлагаемого подхода
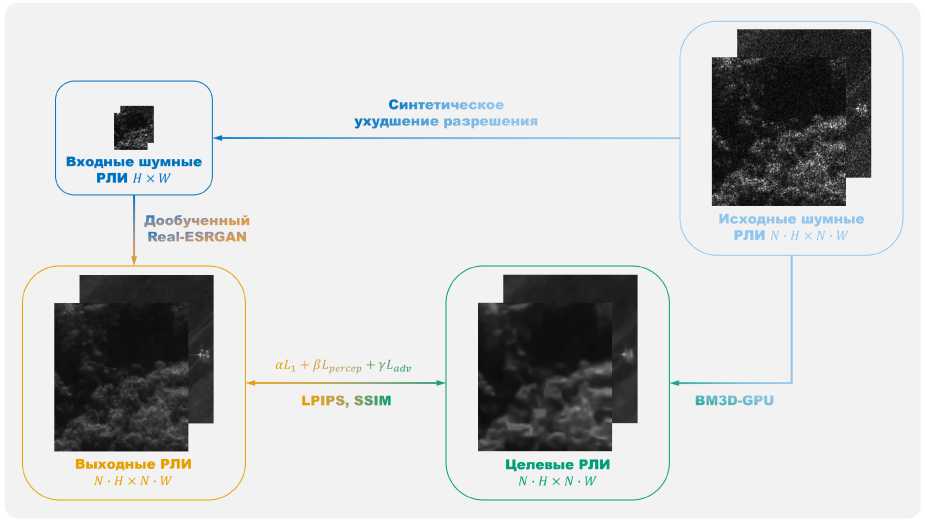
Рис. 1. Принципиальная схема фаз обучения и валидации
Принципиальная схема фаз обучения и валидации показана на рис. 1. Обучение модели осуществляется на амплитудных (вещественных) РЛИ, прошедших через синтетическое ухудшение разрешения, проводимое над комплексными снимками в соответствии с процедурой, описанной в подразделе 2.2. Такие входные РЛИ содержат спекл-шум и обладают пониженным уровнем детализации относительно исходных. При этом целевые РЛИ, являющиеся эталонными для модели, получаются путем обработки исходных снимков классическим методом подавления спекл-шума. В данном исследовании для этой цели использовался метод BM3D-GPU [31]. В качестве стартовой точки используются веса модели, полученные при обучении на наборе данных оптического диапазона. Функция потерь вычисляется на парах выходных и целевых РЛИ. Кроме того, для этих пар рассчитываются значения метрик LPIPS и SSIM. Исходные изображения, а также целевые и выходные снимки имеют одинаковый размер в пикселях, в то время как входные уменьшены в N раз по каждой координате.
Как показано на изображениях (рис. 1), обучение на целевых РЛИ, полученных классическим методом подавления спекл-шума, не обязано приводить к модели, результаты которой будут совпадать по своим ключевым особенностям с эталонными изображениями. Этот эффект достигается за счет того, что ИНС лишь аппроксимирует, а не интерполирует отображение из входных изображений в целевые в соответствии с конкретной функцией потерь. Кроме того, имеет решающее значение и принципиальная разница выполняемых задач: классический алгоритм осуществляет преобразование в пространстве снимков размера N • Н х N • W, в то время как модель является отображением из Н х W в N • Н х N • W. Подобная особенность проявляется и в обучении моделей повышения разрешения на фотографиях оптического диапазона, когда в качестве входных снимков используются синтетически ухудшенные бикубической интерполяцией [25] или более сложной функцией деградации [26, 32] изображения, при этом результаты модели отличаются как от эталонных фотографий, которые часто совпадают с исходными, так и от результатов применения к входным снимкам операции, аналогичной использованной функции ухудшения (например, бикубическая интерполяция для обратного увеличения картинки до исходного размера). В зависимости от итогового сочетания функции ухудшения входных изображений, метода подготовки целевых фотографий и функции потерь, результаты модели могут обладать, например, повышенной резкостью и/или уникальным портретом искажений, что будет в значительной степени отличать их от исходных и эталонных снимков.
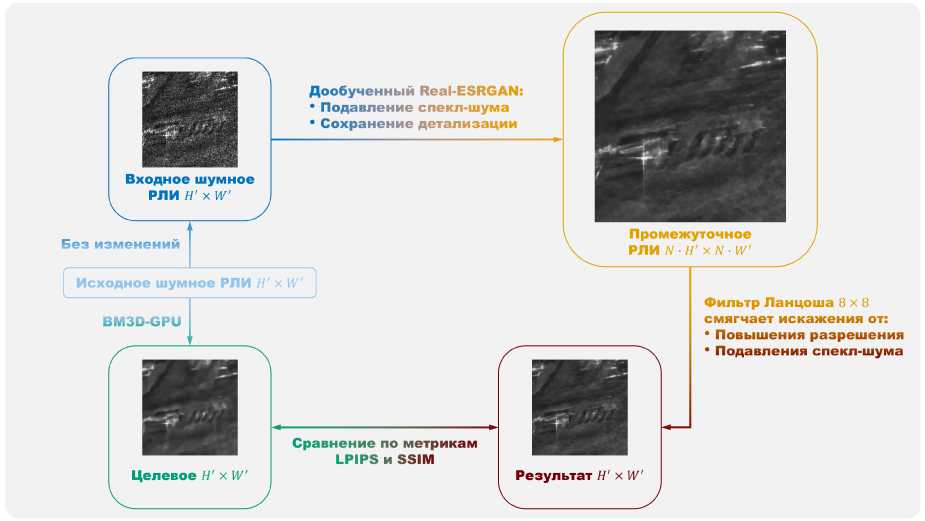
Рис. 2. Принципиальная схема фазы тестирования
Фаза тестирования (рис. 2): сначала полученная в результате дообучения по предлагаемой методике модель используется для одновременного подавления спекл-шума и повышения разрешения. Второе производится с целью более эффективного сохранения детализа- ции. Затем результат приводится к исходному размеру, что позволяет смягчить структурные искажения, большая часть которых содержится в добавленных на предыдущем шаге пикселях. В данной работе для этого использовался фильтр Ланцоша [33] размером 8 х 8. Такой выбор обусловлен хорошей способностью этого метода к сохранению границ объектов на изображении, что оказывает дополнительное благотворное влияние на детализацию результирующего РЛИ. При этом возможность возникновения «артефактов», связанных с данной особенностью алгоритма, снижается за счет того, что входное изображение на предыдущем шаге проходит обработку методом шумоподавления, который имеет естественный для своего класса эффект сглаживания. Как и в случае с фазой валидации, для сравнения с целевым изображением используются метрики LPIPS и SSIM.
В этой работе при обучении и валидации размеры входных изображений Н = W = 256 (см. рис. 1), а коэффициент N = 4. При тестировании Н‘ = W‘ = 1024, N = 4 (см. рис. 2). Также важно отметить, что уже полностью дообученная модель на стадии тестирования в качестве входных РЛИ получает исходные амплитудные снимки, а не синтетически ухудшенные.
2.2. Подготовка данных
Набор данных для обучения, валидации и тестирования создан на основе свободно распространяемого «Umbra Open Data Catalog» [34]. Использовались случайно выбранные информационные продукты SICD (Sensor Independent Complex Data) в формате NITF (National Imagery Transmission Format). Общее количество сцен составило 121. Их географическое распределение показано на рис. 3, где зеленым выделены сцены тестовой выборки, а обучающей и валидационной — красным. Разрешение снимков варьировалось от 0.16 до 2.0 м на пиксель. Высокая вариативность результирующего набора данных обеспечивает покрытие типичных видов подстилающих поверхностей (горная местность, лесные массивы, водная поверхность и т. п.) и объектов (здания, мосты, автомобили и т. и.).
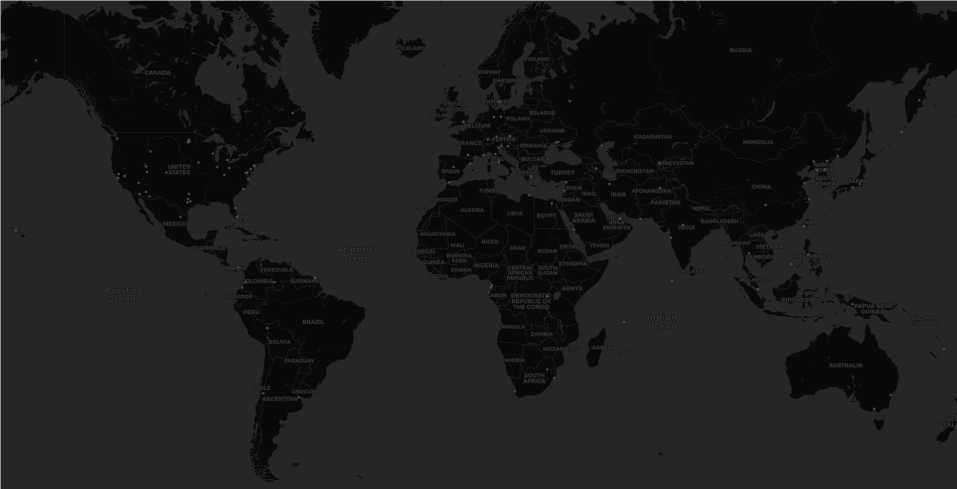
Рис. 3. Географическое распределение сцен, из которых собран общий набор данных. Зеленым выделены локации для тестовой выборки, а красным — для обучающей и валидационной
Для формирования пар входных и эталонных выходных изображений обучающей и валидационной выборок применялась оригинальная схема предобработки. В качестве входных использовались снимки пониженного разрешения, ухудшенные синтетическим путем. Эталонные изображения имели исходное разрешение. Для понижения разрешения использовалось суммирование значений соседних пикселей комплексного снимка в скользящем окне размера 4 х 4, при этом области обработки не пересекались.
После этого полученные из одной сцены пары изображений подвергались одинаковой предобработке. Сначала комплексные снимки переводились в амплитудные. Затем полученные РЛИ очищались от выбросов путем приведения значений пикселей к диапазону от минимального по всей сцене до числа, превышающего среднее в 6 раз. Полученные изображения делились на равные квадратные части размера 1024 х 1024 пикселей в случае эталонных РЛИ и 256 х 256 в случае входных. Наконец, совместная предобработка завершалась нормализацией путем приведения значений пикселей к отрезку целочисленных величин от 0 до 255. Описанный подход позволяет получить пары входных и целевых РЛИ, имеющих схожий динамический диапазон.
Финальным этапом подготовки пар входных и целевых изображений является подавление шума на эталонном снимке исходного разрешения. Для этого использовался метод BM3D-GPU [31], обеспечивающий оптимальный баланс между качеством и скоростью подготовки набора данных. Последнее достигается за счет вычислений на графическом процессоре. На рисунке 4 показаны примеры итоговых пар изображений. Важно, что BM3D-GPU изначально разработан для снимков оптического диапазона, содержащих аддитивный гауссовский шум, поэтому для обработки РЛИ применялся гомоморфный подход, заключающийся в предобработке логарифмированием и постобработке потенцированием.
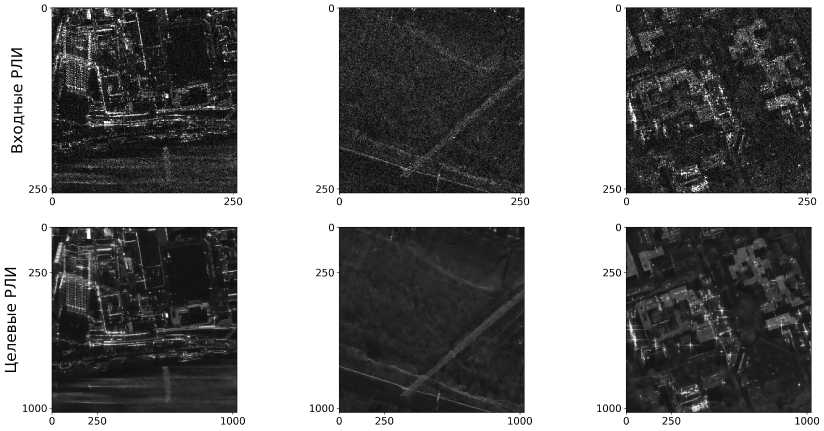
Рис. 4. Примеры пар входных и целевых изображений из обучающей выборки. Здесь и далее по осям указаны отсчеты в пикселях
Обучающая и валидационная выборки собраны на основе одинаковых сцен, выделенных красным (рис. 3). Это означает, что изображение из обучающего датасета может являться соседним по отношению к некоторому изображению из валидационной части данных. Однако в случае с тестовой выборкой использовались отдельные сцены, выделенные на указанном рисунке зеленым. Кроме того, в случае тестового датасета входные изображения не подвергались синтетическому ухудшению разрешения, так как основная задача разрабатываемого метода — подавление шума, а сохранение детализации является побочным требованием.
Итоговый набор данных состоит из 7344 пар в обучающей выборке, 1835 в валидационной и 1888 в тестовой.
2.3. Модель, функция потерь и детали экспериментов
В качестве стартовой точки для дообучения использовались веса модели Real-ESRGAN+, полученные авторами оригинальной работы [26] для снимков оптического диапазона, причем изображения в обучающей выборке не являлись продуктами ДЗЗ. Отличие «+»-версии от базовой заключалось в применении нерезкого маскирования к целевым изоб- ражениям при обучении, что позволило дополнительно повысить резкость результирующих снимков без повышения уровня искажений. С архитектурной точки зрения обе версии идентичны.
Использование выбранной архитектуры позволяет начать дообучение на другой домен с модели, уже обладающей выгодными характеристиками: пониженное относительно других аналогов количество «артефактов», высокие показатели генерализации и общего качества результатов, улучшенная стабильность обучения и усиленная функция потерь. Такой набор увеличивает шансы на получение ИНС, основанной на модели повышения разрешения и успешно решающей на широком спектре сцен задачу подавления спекл-шума на РЛИ с минимально возможным количеством искажений.
Использовалась стандартная для Real-ESRGAN трехкомпонентная функция потерь [26], состоящая из попиксельной средней абсолютной ошибки Li, а также структурносмысловой Lpercep и состязательной Ladv частей:
£ — aL1 + f3Lpercep + 7 Ladv . (1)
Применялся оптимизатор Adam [35]. Шаг градиентного спуска lr был равен 10-4, а число примеров batch_size, использующихся для очередного обновления параметров модели, составляло 16. Коэффициенты а, ^ и 7 из уравнения (1) имели значения 1, 1 и 0.1 соответственно. Многоуровневые модели деградации, использованные авторами Real-ESRGAN при подготовке ИНС для снимков оптического диапазона, в данной работе не применялись. Дообучение проводилось на протяжении 85 000 итераций (185 полных эпох). Однако наилучшая комбинация метрик SSIM и LPIPS на валидационной выборке была достигнута на итерации 5000. Визуальный анализ показал, что дальнейшее дообучение приводит к вырождению решения вследствие возникновения нежелательных искажений, поэтому в качестве итоговой модели были взяты веса с 5000-й итерации.
2.4. Особенности методики тестирования
Для количественной оценки результатов в этой работе использовались стандартные для задач улучшения изображений показатели качества: ENL (Equivalent Number of Looks [27]), SSIM (Structural Similarity Index Measure [29]) и LPIPS (Learned Perceptual Image Patch Similarity [28]). Попиксельные меры сходства, такие как средняя абсолютная и средняя квадратичная ошибки, PSNR (Peak Signal-to-Noise Ratio) и т. д., не применялись из-за высокой чувствительности к смещениям изображений друг относительно друга, а также невысокой способности к оценке структурно-смысловых изменений.
Вычисление ENL проводится на гомогенном участке яркостного изображения, выбранном вручную. Как правило, в качестве такой равномерной области выступает поле или луг. Яркостное РЛИ может быть получено из амплитудного путем возведения последнего в квадрат. Итоговое значение получается следующим образом:
ENL — , (2) ст2
где ц — среднее значение пикселей по области, а ст2 — их дисперсия. Чем выше ENL, тем более равномерным является выбранный участок РЛИ, что говорит о более высоком качестве подавления шума. Данный показатель качества вычисляется по одному изображению, а не по паре результат-эталон, что является выгодной особенностью.
SSIM используется для оценки структурного сходства двух изображений и вычисляется следующим образом:
SSIM (ж, у) — -г^^±^!^±^2> , (3) № + Цу + C1) Н + °у + ^2)
где ж и у — результирующее и эталонное изображения, цж и ц^ — соответствующие средние, с2 и с2 — соответствующие дисперсии, аху — ковариация ж и у, a Ci и С2 — константы:
Ci = (kiD)2 и С2 = (k2D)2 (здесь ki = 0.01, к2 = 0.03, a D = 256 — динамический диапазон сравниваемых РЛИ). В этом исследовании использовалась стандартная процедура: локальные значения SSIM вычислялись в скользящем окне размера 11 х 11, а затем усреднялись для получения окончательного результата. Чем ближе SSIM к 1, тем более схожи хну.
С помощью LPIPS оценивается структурно-смысловое сходство пары изображений. Этот показатель качества основан на промежуточных представлениях глубоких нейронных сетей, обученных на различных задачах компьютерного зрения. Для вычисления значения, интерпретируемого как расстояние от одного изображения до другого, оба снимка сначала проходят через предобученную ИНС, после чего полученные скрытые представления нормализуются, масштабируются и между ними вычисляется £2-норма. Двухэтапное усреднение по слоям и всей глубине нейросети дает финальный результат. Как было показано авторами LPIPS в их оригинальной работе [28], такой подход позволяет получить более устойчивые к различным искажениям оценки близости изображений относительно более простых мер сходства. Кроме того, эксперименты свидетельствуют о том, что результаты LPIPS очень хорошо согласуются с человеческим восприятием «близости» снимков. В этом исследовании для получения скрытых представлений использовались веса предобученной авторами LPIPS нейронной сети, имеющей архитектуру AlexNet [36].
Важно отметить, что в данной работе SSIM и LPIPS использовались для сравнения результата с целевым РЛИ, а не с некоторым изображением, которое действительно можно было бы считать эталоном, так как последнего не существует, ибо исходный незашумлен-ный сигнал неизвестен, а любой метод восстановления не может гарантировать получение идеального решения некорректно поставленной задачи, каковой является фильтрация спекл-шума. Поэтому оба применяемых показателя сходства в данном случае оценивают качество восстановления с общей точки зрения и не обязаны строго стремиться к эталонным значениям (1 в случае SSIM и 0 в случае LPIPS). Здесь близость к целевым РЛИ позволяет говорить о сохранении локальной и глобальной структуры на уровне, не уступающем гомоморфному варианту BM3D-GPU.
Таким образом, с помощью ENL осуществлялся контроль качества подавления спекл-шума, в то время как SSIM и LPIPS использовались для оценки сохранения структурной составляющей РЛИ. Применение двух схожих по своим характеристикам мер близости повышает достоверность результатов, так как они дополняют друг друга. Одновременная количественная оценка фильтрации шума и структурного качества выходных изображений позволяет сбалансированно проконтролировать эффективность полученного метода.
Для визуальной оценки уровня нежелательных искажений выходных РЛИ в статье представлены примеры работы предлагаемого метода. Также для сравнения для тестовых изображений показаны результаты алгоритмов подавления спекл-шума TransSAR [13], FANS [9] и SAR-BM3D [8]. Первый основан на ИНС, а два других относятся к классическим подходам. Выбор TransSAR обусловлен тем, что данный метод на сегодняшний день является одним из лучших в своем классе как с точки зрения качества выходных РЛИ, так и скорости работы. Алгоритм FANS также выделяется в своей нише, предоставляя отличный баланс между временем получения конечного результата и его качеством. SAR-BM3D, напротив, является одним из наиболее вычислительно затратных, но в то же время в большом числе случаев позволяет получить одни из наилучших результатов по совокупности объективных метрик и субъективных оценок экспертов через визуальное восприятие. Кроме того, немаловажным фактором при выборе для сравнения именно этих методов являлась их доступность: все три алгоритма выложены в открытый доступ в виде, достаточном для успешного запуска сторонним разработчиком.
Наконец, в работе приведены результаты алгоритма обнаружения объектов на снимках до и после обработки. Изменение точности детекции может рассматриваться как косвенная мера качества подавления спекл-шума, причем в случае, если метод фильтрации вносит слишком много побочных искажений при работе, эффективность обнаружения может упасть, а не вырасти. Кроме того, как правило, конечной целью обработки изображе- ний ДЗЗ является извлечение из них полезной информации. Например, местонахождений и классов це.левв1х объектов. Поэтому такая оценка эффективности алгоритма повышения качества РЛИ, основанная на результатах детектора, фактически является наиболее приближенной к практическому применению. Использовался набор данных RSAR [37], в котором представлены объекты б различных классов, а аннотации их положений не ориентированы строго параллельно сторонам изображений. Второе свойство особенно подходит для задач ДЗЗ, так как здесь целевые объекты часто обладают большим разнообразием с точки зрения угловой ориентации. Для оценки применялся детектор на основе Rol-Transformer [30], предоставленный авторами RSAR. Качество обнаружения оценивалось по AP50. Выбор Rol-Transformer обусловлен тем, что эта модель показывает наилучшие совокупные результаты относительно других подходов, рассмотренных в работе [37].
3. Результаты
Созданная модель является продуктом дообучения исходного Real-ESRGAN на целевых РЛИ, полученных с помощью гомоморфной версии BM3D-GPU. Поэтому перед переходом к сравнению разработанного алгоритма с другими методами необходимо оценить его отличия от тех подходов, которые использовались при подготовке. Эта модель превосходит по качеству реконструкции оба метода (рис. 5). Нулевая итерация дообучения — исходный Real-ESRGAN не готов к работе с РЛИ, что выражается в практически полном сохранении шума на одних участках при существенном размытии соседних подобластей снимка. BM3D-GPU в гомоморфной реализации способен подавить спекл-шум, однако ухудшение резкости изображения и структурные искажения снижают детализацию и общее качество результата. Все входные фрагменты РЛИ взяты из тестовой части набора данных и имеют размер 200 х 200 пикселей (см. рис. 5). Учитывая продемонстрированные на указанном рисунке примеры, дальнейшее рассмотрение следует посвятить только созданной модели: она показывает наилучшие результаты.
Далее для визуальной оценки представлены результаты работы созданного метода и других алгоритмов, выбранных для сравнения (рис. 6-7). Красным выделены равномерные области, использованные при подсчете значений ENL (2), указанных под изображениями.
Показаны фрагменты сцен тестовой части набора данных. Соответственно эти РЛИ аналогичны тем, что использовались при обучении и валидации модели. Здесь размер каждого фрагмента составляет 400 х 400 пикселей. Можно увидеть различные сюжеты, содержащие антропогенные ландшафты: город, сельскохозяйственные угодья, аэродром (см. рис. 6). Такой набор позволяет продемонстрировать эффективность алгоритмов в широком диапазоне условий, значимых с практической точки зрения. Видно, что все представленные методы успешно справляются со своей прямой задачей — подавлением шума, о чем также говорят возросшие значения ENL. Однако результаты имеют ряд существенных отличий. Наибольшим размытием обладает TransSAR. FANS и SAR-BM3D вносят заметные искажения, как это особенно видно на примере из центральной строки. Причем FANS влияет на более крупномасштабную структуру, а результаты SAR-BM3D обладают мелкомасштабными волнообразными «артефактами», напоминающими рябь на воде. При этом созданный в рамках данной работы метод дает аналогичные по качеству подавления шума результаты, которые одновременно с этим обладают наименьшим уровнем размытия и практически не имеют структурных искажений. Это благотворно влияет на детализацию и общее качество выходных РЛИ, обеспечивая наилучшую резкость переходов на границах объектов и вместе с тем более равномерные текстуры в однородных областях. Количественные значения ENL отличаются от примера к примеру, однако следует отметить стабильно высокие результаты предлагаемого подхода. Кроме того, важно заметить, что слишком высокие показатели ENL могут свидетельствовать о чрезмерном уровне размытия, как это происходит в случае с TransSAR.
Исходный Гомоморфный Предлагаемый
Входное Real-ESRGAN BM3D-GPU подход
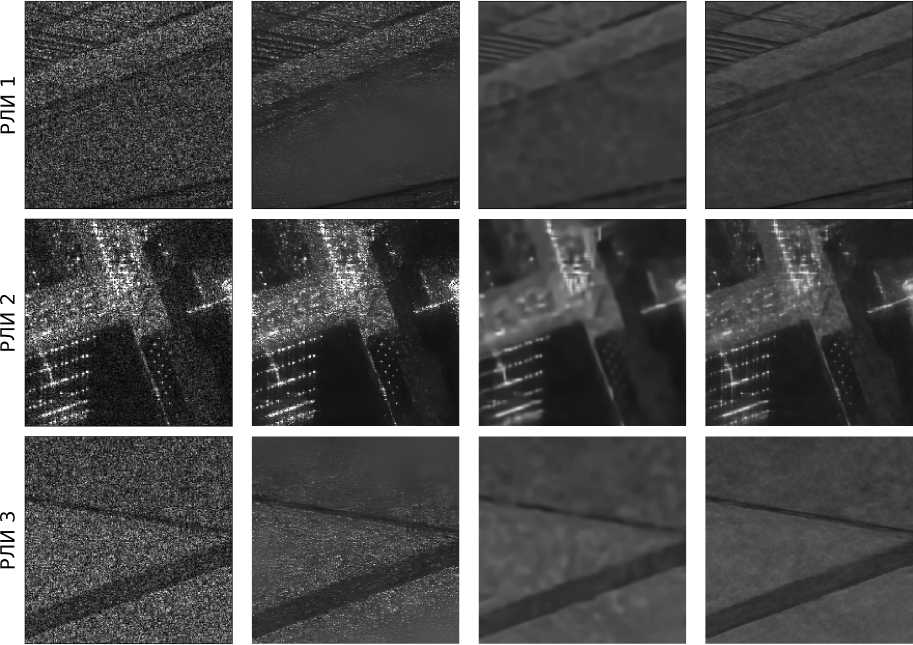
Рис. 5. Примеры результатов созданного метода и алгоритмов, применявшихся при его разработке, на изображениях тестовой выборки
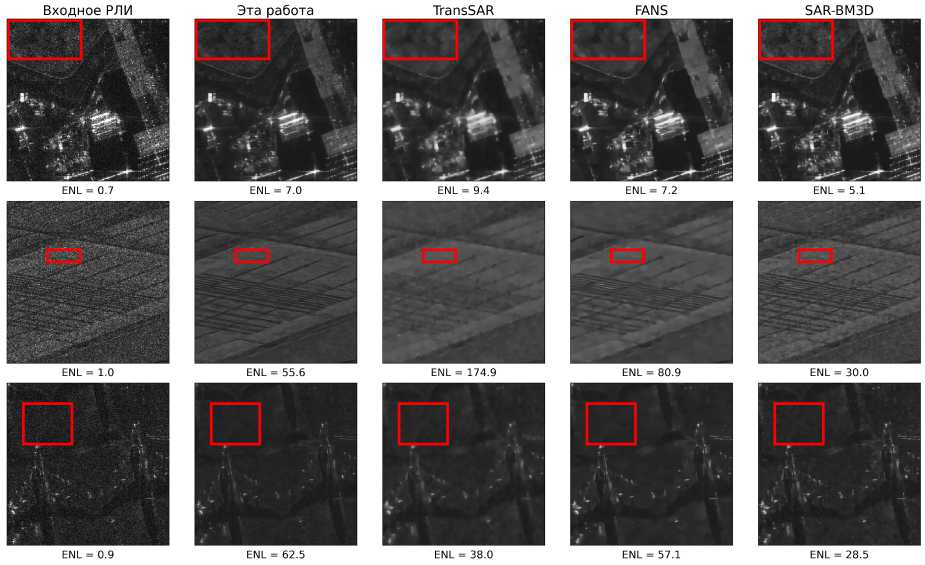
Рис. 6. Примеры результатов на РЛИ тестовой выборки
Важным вопросом применения алгоритмов на основе ИНС является их способность (или неспособность) работать на данных, которые по тем или иным параметрам существенно отличаются от примеров обучающей выборки. На рис. 7 показаны результаты рассматриваемых методов на фрагментах РЛИ аппаратов Sentinel-1. Здесь размер каждого фрагмента составляет 300 х 300 пикселей. Использовались стандартные продукты уровня LI GRD (Ground Range Detected), разрешение которых составляет 10 м на пиксель, что в разы отличается от любого изображения, встречающегося в обучающей выборке. Эти данные получены радаром С-диапазона, в то время как снимки, предоставленные компанией Umbra [34], имеют X-диапазон. Видно, что разработанный метод успешно справляется с обработкой таких РЛИ. Общие выводы, изложенные ранее при анализе рис. 6, сохраняются для рис. 7. Результаты FANS и SAR-BM3D практически не отличаются от тех, что были показаны для РЛИ Umbra. При этом уровень размытия TransSAR вырос, что говорит о недостаточной устойчивости этого метода к изменениям данных. Отдельно следует отметить удаление небольшого количества мелкомасштабных структур разработанным алгоритмом, а также наивысшие показатели его ENL при хорошей визуальной детализации изображения. Все перечисленные отличия от рис. 6 объясняются изменением характерного масштаба РЛИ, жестко связанного с его разрешением. Полученные результаты свидетельствуют о высоком уровне обобщающей способности разработанной модели.
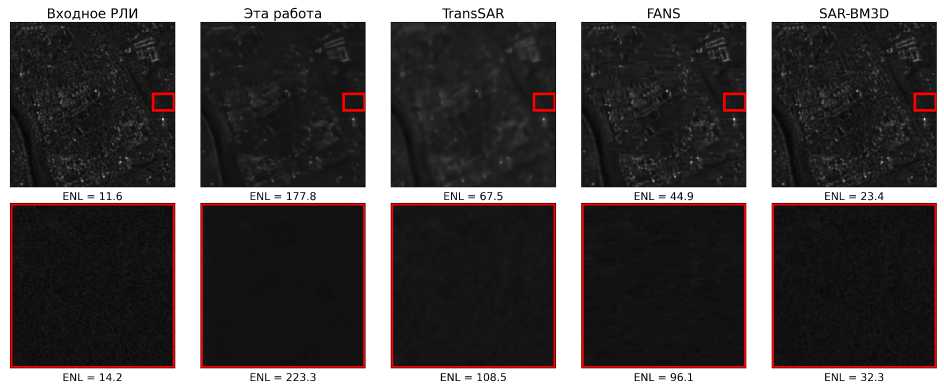
Рис. 7. Примеры результатов на РЛИ аппаратов Sentinel-1, существенно отличающихся от изображений, полученных РСА Umbra, которые использовались при обучении
На рис. 8 в левом и правом столбцах показаны распределения значений LPIPS и SSIM (3), вычисленные на парах результирующих и целевых РЛИ. В первой строке указаны данные для валидационной выборки, а во второй — для тестовой. Кривая зеленого цвета соответствует ядерной оценке плотности. В табл. 1 указаны средние и медианы распределений. Максимальные значения LPIPS не превышают 0.56, a SSIM не опускается ниже 0.81. Такие результаты говорят о том, что выходные изображения, полученные с помощью разработанного метода, сохраняют детализацию, структурную целостность и особенности входных РЛИ. Причем это утверждение справедливо для любой сцены, встречающейся в наборе данных.
Применение к обработанным изображениям детектора, обученного на исходных РЛИ со спекл-шумом, с большой вероятностью может привести к ухудшению результатов, а не их улучшению, так как подаваемые на вход снимки будут отличаться по своей картине искажений от того, что было в обучающей выборке. Например, использование модели обнаружения, предоставленной авторами RSAR [37], обученной на необработанных РЛИ и достигающей на тестовой части набора данных AP5q^ = 0.6695, для работы со снимками-результатами TransSAR и FANS приводит к снижению AP5qs^ до 0.1958 и 0.3879 соответственно. В случае с обработанными предлагаемым методом РЛИ ухудшение эф- фективности обнаружения целевых объектов также существенно: AP50sf падает до 0.4082. Другим путем может 6bitb повышение качества детекции с помощвю обучения модели на обработанных снимках, ведв такой подход позволяет понизитв степенв различия между данными обучающей выборки и теми, с которыми детектору придется работать в дальнейшем. В этом исследовании оригинальная модель обучалась с нуля на протяжении 12 эпох на обработанных РЛИ соответствующего метода подавления спекл-шума, после чего проводилось тестирование, результаты которого отображены в табл. 2. Выбранная длительность обучения обусловлена тем, что оригинальная модель (без обработки) также обучалась 12 эпох. Параметры обучения не менялись от эксперимента к эксперименту. Также на рис. 9 показан пример результатов обнаружения. Здесь размер входного РЛИ составлял 512 х 512 пикселей, но для улучшения наглядности показаны фрагменты размера 400 х 400 пикселей, содержащие все обнаружения. В выделенном цветом поле, расположенном у каждого ограничивающего прямоугольника, указаны название класса объекта и «уверенность» (confidence) предсказания, оцененная моделью самостоятельно. Приведенные результаты позволяют сделать ряд выводов: 1) существенное повышение эффективности решения задачи детекции путем предварительной фильтрации спекл-шума не всегда является оптимальным подходом; 2) разработанный метод обеспечивает подходящий баланс между подавлением спекл-шума и сохранением детализации, о чем свидетельствуют не только сохранившиеся, но даже несколько возросшие значения АР5“г; и 3) созданный алгоритм обладает высокой устойчивостью к изменению входных данных, так как РЛИ из RSAR, аналогично снимкам Sentinel-1, отличаются от изображений датасета, описанного в подразделе 2.2. этой работы, но это не является препятствием к получению выходных РЛИ высокого качества.
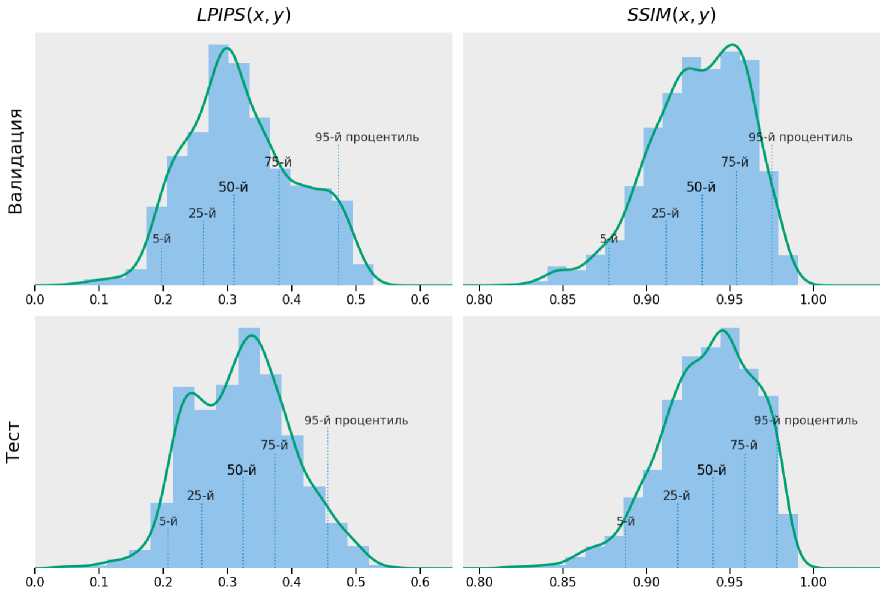
Рис. 8. Распределения значений метрик точности реконструкции изображений LPIPS и SSIM па валидациоппой и тестовой выборках. Здесь х — выходное изображение, полученное предлагаемым методом, а у — целевое РЛИ, принимаемое за эталонное
Немаловажным является вопрос о вычислительной эффективности рассматриваемых методов. В табл. 3 приведены результаты экспериментов по определению скорости обработки РЛИ указанных размеров соответствующими алгоритмами. Здесь «ЦП» означает выполнение на центральном процессоре, а «ГП» — на графическом. Использовался ПК, оснащенный центральным процессором AMD Ryzen(TM) 9 7900Х и графическим процессором NVIDIA RTX 4090. Результаты по эффективности работы FANS и SAR-BM3D на ГП отсутствуют, так как их открытые реализации выложены в виде, не поддерживающем этот тип вычислений. Скорость работы замерялась путем усреднения времени обработки 10 РЛИ соответствующих размеров. Для повышения надежности оценки эта процедура повторялась 3 раза, после чего второе усреднение давало финальный результат. Видно, что созданный в рамках этой работы алгоритм не является наиболее вычислительно эффективным, значительно уступая TransSAR. Кроме того, при условии работы на ЦП алгоритм FANS также оказывается быстрее. Однако наименее скоростным следует считать SAR-BM3D. Если принимать значения FANS за границу, определяющую практическую применимость, то при наличии ГП разработанный метод показывает приемлемые результаты. Также необходимо отметить, что потребление видеопамяти предлагаемым алгоритмом находится на аналогичном TransSAR уровне: при обработке изображений по подобластям размера 512 х 512 обоим методам требуется около 3 ГБ.
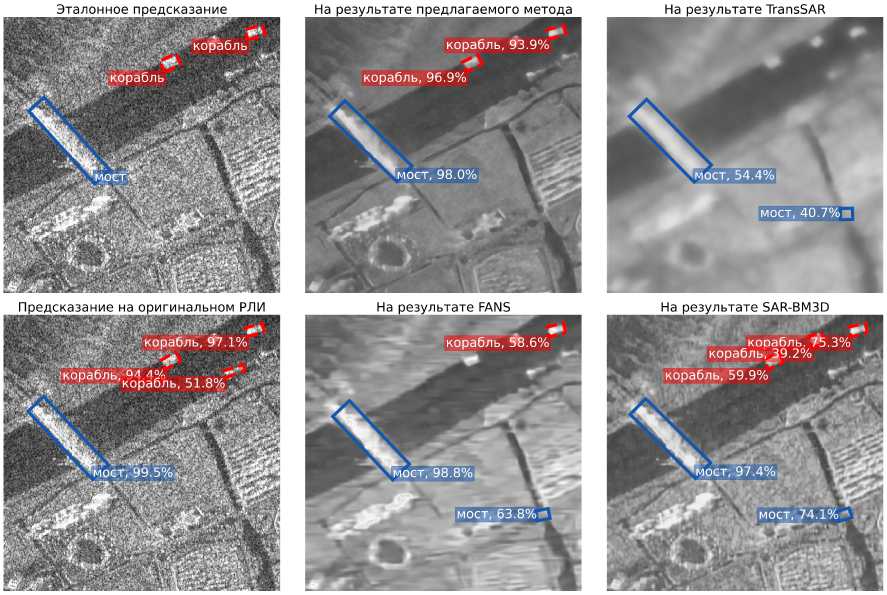
Таблица 1
Параметры распределений LPIPS и SSIM на валидационной и тестовой выборках
|
Выборка |
LPIPS |
SSIM |
||
|
Среднее |
Медиана |
Среднее |
Медиана |
|
|
Валидация |
0.322 |
0.310 |
0.931 |
0.934 |
|
Тест |
0.322 |
0.324 |
0.937 |
0.940 |
Таблица 2
Результаты обнаружения целевых объектов на тестовой части набора данных RSAR различными детекторами, обучение и инференс которых проводились на РЛИ, обработанных указанными методами
|
Обнаружение целевых объектов |
Без обработки |
Предлагаемый метод |
TransSAR |
FANS |
SAR-BM3D |
|
test AP50 |
0.6695 |
0.6742 |
0.4218 |
0.5848 |
0.6491 |
Таблица 3
Скорость обработки рассматриваемых методов для РЛИ различающихся размеров
|
Метод |
РЛИ размера 1024 х 1024, с |
РЛИ размера 3000 х 3000, с |
|
|
Эта работа |
ГП |
4.4 |
37.9 |
|
ЦП |
85.5 |
734.3 |
|
|
TransSAR |
ГП |
0.2 |
1.0 |
|
ЦП |
5.3 |
29.0 |
|
|
FANS |
ЦП |
16.3 |
148.1 |
|
SAR-BM3D |
ЦП |
462.4 |
3960.0 |
4. Заключение
В статье предложен метод повышения качества РЛИ, осуществляющий подавление спекл-шума с высоким уровнем сохранения исходной детализации. Описан оригинальный подход к созданию алгоритма фильтрации шума на основе предобученной модели повышения разрешения, а также сформулирован способ создания набора данных для ее дообучения на новую задачу. Представленная методика продемонстрирована на Real-ESRGAN, но в то же время не содержит в своей формулировке каких-либо принципиальных ограничений на используемую модель. Обучающая и валидационная выборки были сформированы на основе «Umbra Open Data Catalog». Созданный метод протестирован на нескольких наборах данных, полученных различными РСА. Кроме того, проведен сравнительный анализ результатов и вычислительной эффективности с другими популярными алгоритмами подавления спекл-шума на РЛИ.
Полученные результаты свидетельствуют о высокой устойчивости созданного метода к изменению входных данных. Разработанная модель сохраняет баланс между эффективностью подавления спекл-шума, аналогичной другим алгоритмам, и сохранением максимального числа структурных особенностей входного изображения, внося минимальное число искажений. Такие выводы подтверждаются как количественным анализом по ENL, LPIPS, SSIM и АР на задаче обнаружения объектов, так и качественной оценкой результатов. При этом вычислительная эффективность предложенного метода находится на уровне, допускающем практическое применение в потоковой обработке больших объемов данных.
Главным недостатком созданной модели является сравнительно невысокая скорость работы, что особенно актуально в случае сценариев с отсутствием высокопроизводительного аппаратного обеспечения. Решение этой проблемы может быть осуществлено путем использования различных методов ускорения нейронных сетей [38]. Кроме того, важно отметить наличие пространства для улучшений разработанной модели с точки зрения повышения качества обнаружения объектов на обработанных РЛИ, так как полученный прирост является удовлетворительным, но не максимальным. Также интерес представляет применение предложенной методики к другим нейросетевым моделям повышения разрешения. Эти вопросы будут рассмотрены авторами в следующих работах.
