Программный конвейер для формирования шаблонов онтологий из текстов на естественном языке
Журнал: Онтология проектирования @ontology-of-designing
Рубрика: Инжиниринг онтологий
Статья в выпуске: 3 (61) т.16, 2026 года.
Бесплатный доступ
Рассматривается задача извлечения и связывания фактов из русскоязычных юридических текстов и конвейерный способ еѐ решения для формирования базы знаний в виде иерархического словаря, как шаблона онтологии предметной области. Предлагаемый программный конвейер включает этапы нормализации входных данных, лексический анализ с извлечением именованных сущностей, синтаксический анализ с построением абстрактного синтаксического дерева и отображение полученного словаря в RDF/OWL-представление. В лексическом анализе использован гибридный модуль извлечения сущностей, сочетающий модели на основе машинного обучения и правила, заданные грамматиками и шаблонами. Проведена экспериментальная оценка качества анализа на специализированном корпусе решений региональных подразделений Федеральной антимонопольной службы России: показано, что добавление правил к обученным моделям приводит к приросту интегральных метрик извлечения сущностей около 5%. На этапе синтаксического анализа предложена конфигурируемая грамматика, позволяющая отделять разные дела в одном юридическом документе и связывать извлечѐнные сущности в структурированный словарь. Такой словарь может быть отображѐн в онтологический граф и использован как слой онтологизации для хранения в графовой базе знаний и сопоставления с подходами на основе больших языковых моделей.
Короткий адрес: https://sciup.org/170213738
IDS: 170213738 | УДК: 004.82 | DOI: 10.18287/2223-9537-2026-16-3-502-514
Software pipeline for generating ontology templates from natural language texts
This paper examines the problem of extracting and linking facts from Russian-language legal texts and presents a pipeline- based approach to solving it for the construction of a knowledge base represented as a hierarchical dictionary serving as an ontology template for the subject domain. The proposed software pipeline comprises input data normalization, lexical analysis with named entity extraction, syntactic analysis with the construction of an abstract syntax tree, and mapping of the resulting dictionary to an RDF/OWL representation. The lexical analysis stage employs a hybrid entity extraction module that combines machine-learning-based models with rules defined by grammars and templates. The quality of the analysis was experimentally evaluated using a specialized corpus of decisions issued by regional divisions of the Federal Antimonopoly Service of Russia. The results demonstrate that augmenting the trained models with rulebased components improves the aggregate entity extraction metrics of approximately 5%. At the syntactic analysis stage, a configurable grammar is proposed that makes it possible to distinguish separate cases contained within a single legal document and link the extracted entities into a structured dictionary. Such a dictionary can be mapped to an ontological graph and used as an ontologization layer for storage in a graph-based knowledge and for comparison with approaches based on large language models.
Текст научной статьи Программный конвейер для формирования шаблонов онтологий из текстов на естественном языке
Большой объём текстовой информации в Интернете доступен для автоматизированной обработки с целью извлечения новых полезных знаний и моделирования предметных областей (ПрО). Извлечение фактов при этом является основой для построения онтологий, семантического поиска и систем поддержки принятия решений [1].
Цель статьи – разработка программного конвейера (ПрК), обеспечивающего извлечение упорядоченных наборов данных из слабоструктурированных документов, позволяющего повысить точность извлечения данных и снизить ресурсоёмкость процесса обработки. ПрК должен обеспечивать сбор и нормализацию текстовых данных, извлечение именованных сущностей, выделение отношений между ними и формирование иерархических словарей, которые могут рассматриваться как шаблоны онтологий ПрО.
Для достижения поставленной цели необходимо:
-
■ проанализировать подходы к извлечению фактов из текстов на естественном языке (ЕЯ);
-
■ спроектировать архитектуру ПрК, включающего этапы сбора и нормализации данных, лексического и синтаксического анализа;
-
■ разработать модуль извлечения именованных сущностей и связей на основе сочетания методов машинного обучения (ММО) и правил, заданных грамматиками и шаблонами;
-
■ сформировать иерархические словари в машиночитаемом формате на основе выделенных сущностей и отношений, определить правила их отображения средствами RDF/OWL -представления в шаблоны онтологического описания ПрО;
-
■ провести оценку качества извлечения фактов на специализированном наборе данных.
1 Программный конвейер обработки текстов
Процесс обработки текстов на ЕЯ можно осуществить посредством ПрК. На первом этапе проводится извлечение и нормализация данных, очистка их от артефактов вёрстки, обработка кодировок и сегментация текста на предложения. На этапе лексического анализа текста осуществляется семантическая разметка текста. После того, как лексемы найдены, определяются логические связи между ними, превращая изолированные термины в факты. Для каждой пары сущностей в одном логическом блоке проверяется наличие семантической связи. На заключительном этапе осуществляется перевод полученных результатов в машиночитаемый формат. Данные упаковываются в иерархическую структуру (например, JSON -объект), и полученный объект экспортируется в требуемый формат (см. рисунок 1).
Программный конвейер^
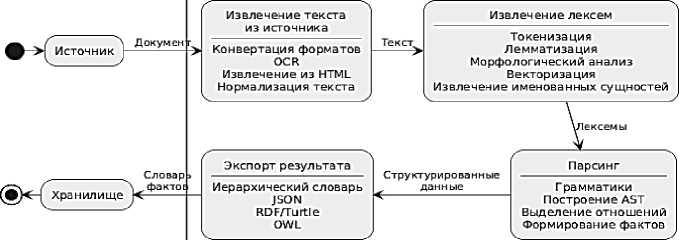
Рисунок 1 – Схема программного конвейера обработки текстов
В ПрК реализованы конверторы для следующих форматов: текстовых ( DOC, RTF, DOCX, ODT, PDF ); табличных ( XLS, XLSX, ODS ); графических ( JPEG, TIFF и т.п.). Для графических форматов требуется применение оптического распознавания ( Optical Character Recognition , OCR ). Задача ПрК – независимо от исходного формата входного файла сформировать текстовый выход в кодировке UTF -8 с сохранением логической структуры документа.
2 Лексический анализ текста
Исходный текст преобразуется в формализованное представление потока лексем, пригодное для анализа и извлечения информации. Каждая лексическая единица снабжается набором атрибутов: позиция в тексте; словоформа; нормальная форма; часть речи; морфологические характеристики; признаки, характеризующие контекст употребления. Задача извле- чения именованных сущностей (Named Entity Recognition, NER) рассматривается как задача классификации [2].
Ранние методы автоматизированного извлечения фактов из текстов на ЕЯ базировались на явном кодировании лингвистических и логических правил, а также на использовании шаблонов. В методах, основанных на правилах, знания специалиста ПрО формализуются в виде набора инструкций, которые применяют к тексту для извлечения фактов [3]. Способ прописать правила для извлечения фактов, используя регулярные выражения, эффективен в случаях, когда в тексте есть подстроки, о которых можно сделать вывод о принадлежности строки, её части или соседнего фрагмента к какому-либо классу [4].
В методе концептуального моделирования строится граф, в вершинах которого находятся понятия, а на рёбрах задаются связи между понятиями. Метод включает построение множества концептуальных графов, которые агрегируются, и на этой основе выделяются формальные понятия, между которыми можно выстраивать связи [5].
Распространённым методом извлечения фактов из текстовой информации являются правила, построенные на основе контекстно-свободных грамматик (КС-грамматик) [6]. Шаблоны, написанные с применением КС-грамматик, можно применить для текстов на ЕЯ.
В онтологическом подходе для каждой категории фактов разрабатывается набор шаблонов извлечения, которые обобщают имеющиеся в тексте субъекты, объекты и отношения [7].
На первом этапе работы ПрК текст разбивается на отдельные слова, слоги, знаки препинания, отступы. Это лингвистический процесс, основанный на правилах и регулярных выражениях. Далее текстовые токены преобразуются в векторы из чисел. ПрК анализирует полученные векторы признаков, определяет границы сущностей и их типы (см. рисунок 2).
Извлечение именованных сущностей

Рисунок 2 – Схема извлечения именованных сущностей
Системы на базе ММО обладают устойчивостью к вариативности языка, их качество зависит от качества обучающей выборки, результаты сложнее интерпретировать. В гибридном подходе одна часть задачи решается с помощью правил, другая – с помощью ММО. Многие сущности могут быть описаны шаблонами, общими для разных текстов, например: номера телефонов, адреса электронной почты, признаки различных документов. Такие сущности удобно извлекать с помощью регулярных выражений. Наименования, которые не меняются в тестах, такие как топонимы, можно искать с помощью словарей. Другие сущности, не обладающие таким постоянством (имена, фамилии, названия организаций и др.), распознаются с помощью обученной модели. Такой подход применён в библиотеке SpaCy 1 , где для извлечения именованных сущностей используется языковая модель.
Если существует метка, которая моделью не распознаётся, и дообучение не даёт приемлемого результата, то можно прописать набор правил, который будет использоваться совместно с моделью SpaCy . Для подтверждения данной гипотезы проведён ряд экспериментов. В SpaCy есть набор предобученных моделей, в том числе три для работы с текстами на русском языке: ru_core_news_sm, ru_core_news_md и ru_core_news_lg . Все три модели обучены на одном корпусе данных – Nerus , и содержат одинаковый набор компонентов: токенизатор, морфологию, синтаксический анализатор и NER . Различие между моделями состоит в наличии и размере статических векторных представлений слов, что влияет на точность, вес моде-
1 SpaCy – открытая библиотека Python для продвинутой обработки ЕЯ.
ли и её возможности. В маленькой модели ( sm ) нет статических векторов, в средней ( md ) – около 50000 векторов, в большой ( lg ) – 500000 векторов.
Для проверки предложенного подхода использован размеченный набор данных slm-ct/fas_ad_practice_dataset 2, который представляет собой коллекцию текстов решений региональных подразделений Федеральной антимонопольной службы (ФАС), подвергнутую предварительной подготовке. Анализ набора данных позволил составить список меток, приве-
|
дённый в таблице 1. Полученный набор данных содержит 4332 |
Таблица 1 – Список извлекаемых сущностей |
||
|
записи с 45305 размеченными метками. Обучающая выборка содержит 3118 записей, ва-лидационная – 780, тестовая – 434. Для проверки обученных моделей используются стандартные классификационные метрики. Точность ( precision ) показывает, какая доля ответов спрогнозирована верно. Метрика характеризует способность отличать класс от других. Полнота ( recall ) показывает долю верно спрогнозированных объектов метки из общего объёма метки. Эти метрики не зависят от соотношения классов и применимы в условиях несбалансированных выборок. На их основе выводится единый критерий – гармоническое среднее точности и полноты. |
Метка |
Описание |
Количество |
|
PER |
ФИО людей |
13049 |
|
|
LOC |
Локация (страна, область, город и т.д.) |
10380 |
|
|
ORG |
Название организации |
9562 |
|
|
DATE |
Дата |
5766 |
|
|
URL |
Адрес в Интернете |
178 |
|
|
|
Электронная почта |
1725 |
|
|
PHONE |
Номер телефона |
1739 |
|
|
LAW |
Закон |
1792 |
|
|
CRIME |
Правонарушение |
663 |
|
|
PUNISH |
Решение по делу |
451 |
|
Известны различные подходы к расчёту метрик [8].
Для извлечения сущностей EMAIL, URL, PHONE и LAW написаны правила. В SpaCy правила легко встраиваются с помощью класса EntityRuler в общий конвейер обработки. Сравнение оценки моделей на тестовой выборке приведены в таблице 2. Добавление правил улучшило работу моделей, прирост метрик составил от 2 до 6%.
Таблица 2 – Результаты оценки моделей
|
Модель |
Обучение |
Обучение + правила |
||||||||
|
Micro _p |
Micro _r |
Micro _F1 |
Macro _F1 |
Weighted _F1 |
Micro _p |
Micro _r |
Micro _F1 |
Macro _F1 |
Weighted _F1 |
|
|
SpaCy sm |
0,78 |
0,71 |
0,74 |
0,65 |
0,73 |
0,81 |
0,71 |
0,76 |
0,70 |
0,75 |
|
SpaCy md |
0,78 |
0,73 |
0,76 |
0,66 |
0,74 |
0,78 |
0,74 |
0,76 |
0,72 |
0,77 |
|
SpaCy lg |
0,78 |
0,73 |
0,75 |
0,66 |
0,74 |
0,79 |
0,75 |
0,77 |
0,73 |
0,78 |
Для задач извлечения структуры из текстов на ЕЯ применяются большие языковые модели (БЯМ), способные выделять сущности, отношения и формировать JSON -подобные представления без дообучения. БЯМ целесообразно рассматривать как дополнительный семантический модуль, применяемый для обработки неоднозначных фрагментов, редких конструкций и сложных ссылок.
При выборе подхода для извлечения структуры из русскоязычных юридических документов необходимо учитывать не только качество выделения сущностей и связей, но и ре-сурсоёмкость решения, включая требования к локальному оборудованию, стоимость эксплуатации и зависимость от внешней вычислительной инфраструктуры.
3 Извлечение отношений
Для консолидации разрозненных сущностей в связные факты необходимо решить задачу выявление отношений между парами сущностей в неструктурированных текстовых данных.
Автоматическое распознавание связей востребовано при анализе документов, справочников и новостных лент [9].
Известны два подхода к решению задачи извлечения отношений. Первый - синтаксический анализ: осуществляется процесс сопоставления линейной последовательности лексем некоторой формальной грамматике. Другой подход связан с применением ММО, в котором используются нейронные сети с архитектурой seq2seq , предназначенные для преобразования последовательностей из одной области в последовательности другой области [10]. Нейронные сети рассматривают извлечение отношений как задачу машинного перевода, что делает невозможной интерпретацию результатов. По этим причинам применяют методы на основе грамматик или совместно с ММО [11].
Для связывания лексем, полученных на этапе извлечения именованных сущностей инструментом синтаксического анализа является абстрактное синтаксическое дерево (АСД) [12]. В настоящей работе под АСД понимается дерево, вершины которого соответствуют нормализованным фактам и их компонентам (предикатам и аргументам), а листья - выде- ленным именованным сущностям и ключевым лексическим единицам, непосредственно участвующим в формировании факта. При построении АСД опускаются вспомогательные грамматические узлы (служебные части речи, промежуточные нетерминалы, знаки пунктуации) и свёртываются сложные синтаксические конструкции в узлы «нормализованного дей-ствия/факта», что позволяет рассматривать полученную структуру как промежуточное представление между деревом зависимостей и семантическим графом. Такое АСД сохраняет древовидную структуру на уровне предложения, но ориентировано на последующее извлечение и отображение фактов в иерархические словари и онтологические шаблоны.
Пусть имеется упорядоченная последовательность лексем: S=(t 1 ,t2,...,t n ). Каждая лексема t i - это кортеж из трёх элементов: c - тип лексемы; v - строковое значение лексемы; pos - позиция в исходном тексте. На основе последовательности S строится дерево T = (V, E) , где V -множество узлов, а E - связи между ними.
При обработке текста узлы дерева делятся на два непересекающихся множества: V = V int и 1 V ieaf . Внутренние узлы Vint - это узлы, у которых есть дочерние элементы. Они не существуют в исходном тексте. Это грамматические или логические конструкции, которые распознаны на основе правил. Листья Vlea f - это конечные узлы дерева. В АСД листья ссылаются на значимые лексемы из последовательности S , извлекая значение v.
АСД в ПрК - это результат функции редукции, которая удаляет синтаксический мусор. Синтаксический анализатор фильтрует лексемы и иерархизирует остаток (оставшиеся лексемы становятся листьями, подвешенными к узлам-концептам).
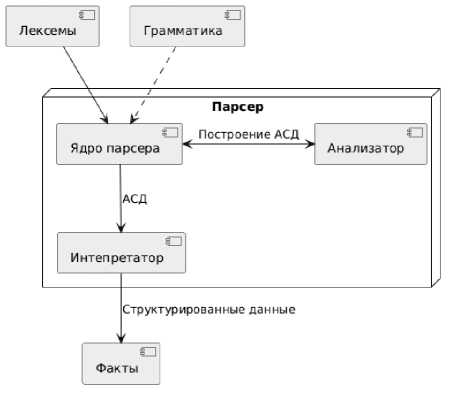
Рисунок 3 - Схема синтаксического анализатора
Схема предлагаемого синтаксического анализатора представлена на рисунке 3. На первом этапе загружается грамматика и задаются мно- жество типов ные правила, образуются в втором этапе
узлов дерева и интерпретацион-определяющие, какие узлы пре-какие поля целевой записи. На главный модуль анализатора за- гружает поток лексем, применяет грамматику и строит АСД, отражающее логическую структуру документа. На третьем этапе интерпретатор
АСД проходит по дереву и превращает узлы в элементы структурированных данных: поля, значения, записи и составные структуры. Четвёртый этап заключается в формировании итогового объекта структурированных данных. Для примера рассмотрен следующий документ3.
ПРЕДПИСАНИЕ
О ПРЕКРАЩЕНИИ НАРУШЕНИЯ ЗАКОНОДАТЕЛЬСТВА РОССИЙСКОЙ ФЕДЕРАЦИИ О РЕКЛАМЕ ПО ДЕЛУ № 076/05/18-364/2024
29 мая 2024 года город Ярославль
Комиссия Межрегионального управления Федеральной антимонопольной службы по Ярославской области и Костромской области по рассмотрению дел по признакам нарушения законодательства о рекламе в составе: председатель Комиссии – заместитель руководителя Управления Шушкова А. С., члены Комиссии – начальник отдела контроля органов власти и рекламы Семенюк А. В., главный специалист-эксперт отдела контроля органов власти и рекламы Солодяшкина С. Д., на основании своего решения от «29» мая 2024 г. по делу № 076/05/18-364/2024 о признании ненадлежащей рекламы услуг ООО «ВсеИнструменты.ру» с нарушением требований пунктов 4, 10 части 3 статьи 5, статьи 8, частей 1, 2 статьи 18 Федерального закона от 13.03.2006 г. № 38-ФЗ «О рекламе» (далее – Федеральный закон «О рекламе»), в соответствии с пунктом 2 части 1 статьи 33, частью 1 статьи 36 Федерального закона «О рекламе», пунктами 4, 30, 37-42, 44, 45, 48 Правил рассмотрения антимонопольным органом дел, возбужденных по признакам нарушения законодательства Российской Федерации о рекламе,
ПРЕДПИСЫВАЕТ…
Для рассматриваемого класса документов грамматика задаётся не для полного текста на ЕЯ, а для потока уже выделенных лексем, каждая из которых имеет тип, значение и позицию в документе. В этом случае синтаксический анализатор оперирует последовательностью терминалов вида CASE_NUMBER, DATE, LOC, PER, ORG, LAW, PHONE, EMAIL, URL . Для данного примера документа ФАС упрощённая грамматика может быть записана в BNF -нотации следующим образом:
|
|
= |
|
|
|
= |
|
|
|
= "CASE_NUMBER" |
|
|
|
= "DATE" |
|
|
|
= "LOC" |
|
|
|
= |
|
|
|
= "PER" |
|
|
|
= "PER" |
|
|
|
= "CASE_NUMBER" | "DATE" | "LOC" | "ORG" | "TEL" | "EMAIL" | "URL" | "PUNISH" |
|
|
|
= |
|
|
|
= |
|
|
|
= "DATE" | "LOC" | "PER" | "ORG" | "TEL" | "EMAIL" | "URL" | "LAW" | "PUNISH" |
|
|
|
= "ORG" |
|
|
|
: |
:= "LOC" |
|
|
= "TEL" |
|
|
|
= "EMAIL" |
|
|
|
= "URL" |
|
|
|
= "LAW" |
|
|
|
= "PUNISH" |
3Предписание №7159/24 076/05/18-364/2024 от 7 июня 2024 г. База решений и правовых актов. Федеральная Антимонопольная служба.
8e88a9605e66/?query=%E2%84%96%20076/05/18-364/2024.
Сформированные на этапе синтаксического анализа иерархические словари могут быть интерпретированы как прикладные JSON -структуры и как шаблоны онтологического описания документов. На этом уровне каждому ключевому блоку словаря сопоставляется класс ПрО, а вложенные структуры и массивы интерпретируются как связанные сущности, соединённые объектными свойствами. Схема такого отображения документов приведена на рисунке 4. Центральным элементом шаблона является класс Case, содержащий основные атрибуты дела и связываемый с экземплярами классов Commission, Organization, LegalNorm, Address и Contacts. Состав комиссии детализируется через сущности класса Person, а контактные данные представляются как связанные сущности Phone, Email и WebResource, что обеспечивает единообразное отображение результатов извлечения в RDF/OWL -представление. Такая схема позволяет сопоставить JSON -структуру и онтологический граф и может использоваться как шаблон при обработке других документов того же класса.
Структура документа представляется формальной грамматикой, которую можно записать в конфигурационный файл. Синтаксический анализатор загружает нужную конфигурацию и применяет её к текущему набору лексем. В такой записи нетерминалы верхнего уровня задают логические блоки документа, а терминальные символы соответствуют результатам этапа NER ; тем самым связывание сущностей выполняется по их принадлежности к распознанному структурному контексту документа.
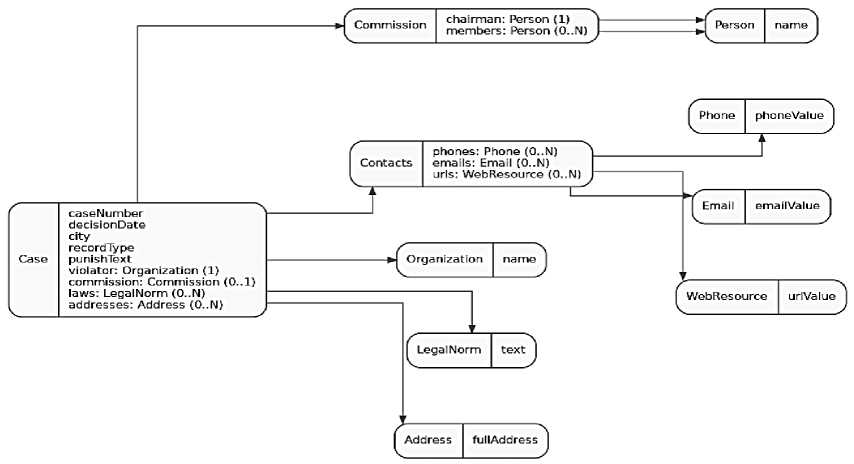
Рисунок 4 – Онтологический шаблон представления дела Федеральной антимонопольной службы
Далее документ обрабатывается лучшей моделью для извлечения именованных сущностей - дообученной ru_core_news_lg с правилами. Получается следующий набор сущностей. [
! {"label":"CASE_NUMBER","text":"№ 076/05/18-364/2024","span":{"start":92,"end":112}},
I {"label":"DATE","text":"29 мая 2024 года","span":{"start":114,"end":130}},
; {"label":"LOC","text":"город Ярославль","span":{"start":228,"end":243}}, i {"label":"PER","text":"Шушкова А. С.","span":{"start":504,"end":517}}, i {"label":"PER","text":"Семенюк А. В.","span":{"start":588,"end":601}},
I {"label":"PER","text":"Солодяшкина С. Д.","span":{"start":671,"end":688}},
; {"label":"DATE","text":"«29» мая 2024 г.","span":{"start":722,"end":738}},
! {"label":"CASE_NUMBER","text":"№ 076/05/18-364/2024","span":{"start":747,"end":767}}, i {"label":"ORG","text":"ООО «ВсеИнструменты.ру»","span":{"start":807,"end":830}},
I {"label":"LAW","text":"части 3 статьи 5, статьи 8, частей 1, 2 статьи 18 Федерального закона от 13.03.2006
; г. № 38-ФЗ «О рекламе»","span":{"start":869,"end":975}},
{"label":"LAW","text":"Федеральный закон «О рекламе»","span":{"start":985,"end":1014}}, {"label":"LAW","text":"пунктом 2 части 1 статьи 33","span":{"start":1034,"end":1061}}, {"label":"LAW","text":"частью 1 статьи 36 Федерального закона «О рекла-ме»","span":{"start":1063,"end":1113}}, {"label":"DATE","text":"37-42","span":{"start":1131,"end":1136}},
Этот набор лексем обрабатывается с помощью АСД:
[
{
"case_number": "№ 076/05/18-364/2024",
"date": "29 мая 2024 года",
"city": "город Ярославль",
"commission": {
"chairman": "Шушкова А. С.",
"members": [
"Семенюк А. В.",
"Солодяшкина С. Д."
]
},
"laws": [
"части 3 статьи 5, статьи 8, частей 1, 2 статьи 18 Федерального закона от 13.03.2006 г. № 38-ФЗ «О рекламе»",
"Федеральный закон «О рекламе»",
"пунктом 2 части 1 статьи 33",
"частью 1 статьи 36 Федерального закона «О рекламе»",
"пунктом 2.4 статьи 19.5 Кодекса Российской Федерации об административных правонарушениях",
"статьей 198 Арбитражного процессуального кодекса Российской Федерации" ], "violator": "ООО «ВсеИнструменты.ру»", "addresses": [
"109451, г. Москва, вн.тер.г. Муниципальный округ Марьино, ул. Братиславская, д. 16, корп. 1" ], "phones": [], "emails": [], "urls": [],
"punish": "наложить на граждан штраф в размере от трехсот до пятисот рублей, на должностных лиц", "type": "case"
}
]
В результате из набора лексем получен факт в виде словаря связанных сущностей, где каждый ключ означает вид связи внутри обработанного документа. Грамматика является универсальной для обработки документов из набора данных и легко изменяемой в случаях изменения структуры текста в документе. Полученное АСД способно отделять разные дела, если они описаны в одном тексте.
4 Шаблон онтологии
После формирования структурированного JSON -объекта получается удобочитаемый формат представления данных, но необходимо привести его к онтологически интерпретируемому виду. В ПрК переход к представлениям на языках RDF/OWL/Turtle можно выполнить с помощью правил, связывающих поля JSON с классами, объектами и свойствами онтологической модели. Такой подход позволяет отделить задачу извлечения и нормализации данных из текста от задачи их формализации в виде онтологических конструкций, пригодных для последующего хранения в графовой базе знаний.
Алгоритм преобразования включает следующие шаги.
-
1) для корневого JSON -объекта определяется его онтологический тип, например Case, Decision или Prescription в зависимости от класса документа.
-
2) простые поля JSON , содержащие строковые, числовые и календарные значения ( case_number, date, city, type ), отображаются в свойствах соответствующего экземпляра.
-
3) вложенные объекты и массивы ( commission, members, laws, addresses ) интерпретируются как связанные экземпляры классов Commission, Person, LegalNorm, Address и соединяются с корневым объектом через свойства объекта.
-
4) выполняется нормализация значений: даты переводятся в стандартный формат, повторяющиеся адреса дедуплицируются, а текстовые ссылки на нормы права при необходимости разлагаются на составные элементы: закон, статья, часть, пункт.
-
5) из полученного графа фактов генерируется RDF -представление, которое может быть дополнено OWL -аксиомами, а также ограничениями целостности.
Для рассматриваемого документа итоговый JSON -объект может быть интерпретирован как экземпляр класса Case , связанный с экземпляром Commission, нарушителем класса Organization, набором сущностей класса LegalNorm и адресом класса Address . Фрагмент результата в формате Turtle может быть представлен следующим образом:
@prefix ex: <>.
@prefix xsd: <>.
ex:case_076_05_18_364_2024 a ex:Case ;
ex:hasCaseNumber "076/05/18-364/2024";
ex:hasDecisionDate "2024-05-29"^^xsd:date;
ex:hasCity "Ярославль";
ex:hasCommission ex:commission_076_05_18_364_2024 ;
ex:hasViolator ex:org_vseinstrumenty ;
ex:referencesLegalNorm ex:law_1 , ex:law_2 , ex:law_3 ;
ex:hasAddress ex:address_1 ;
ex:hasRecordType "case" .
ex:commission_076_05_18_364_2024 a ex:Commission ;
ex:hasChairman ex:person_shushkova ;
ex:hasMember ex:person_semenyuk , ex:person_solodyashkina .
ex:person_shushkova a ex:Person ;
ex:hasName "Шушкова А. С.".
ex:person_semenyuk a ex:Person ;
ex:hasName "Семенюк А. В.".
ex:person_solodyashkina a ex:Person ;
ex:hasName "Солодяшкина С. Д.".
ex:org_vseinstrumenty a ex:Organization ;
ex:hasName "ООО «ВсеИнструменты.ру»".
ex:address_1 a ex:Address ;
ex:hasFullAddress "109451, г. Москва, вн.тер.г. Муниципальный округ Марьино, ул. Братиславская, д. 16, корп. 1".
ex:law_1 a ex:LegalNorm ;
ex:hasText "части 3 статьи 5, статьи 8, частей 1, 2 статьи 18 Федерального закона от 13.03.2006 г. №
38-ФЗ «О рекламе»".
ex:law_2 a ex:LegalNorm ;
ex:hasText "пунктом 2 части 1 статьи 33" .
ex:law_3 a ex:LegalNorm ;
ex:hasText "частью 1 статьи 36 Федерального закона «О рекламе»".
В таком представлении JSON -структура становится не только техническим форматом обмена данными, но и слоем онтологизации текста. Это позволяет рассматривать сформированный иерархический словарь как прикладной словарь полей документа и как шаблон онтологического описания, в котором выделены сущности ПрО, их атрибуты и отношения.
5 Сравнение программного конвейера с современными подходами
Исследования в области извлечения фактов из текстов на ЕЯ развиваются по нескольким направлениям. Первое направление составляют системы, основанные на правилах и формальных грамматиках [13]. Второе направление образуют обучаемые модели, ориентированные на совместное [14] или поэтапное [15] извлечение сущностей и отношений. Третье направление представлено нейросетевыми и нейросимвольными подходами [7, 16].
ПрК не относится полностью ни к одному из указанных классов. Место предлагаемого решения можно определить как специализированный гибридный конвейер, ориентирован- ный на извлечение и связывание фактов в документах ограниченного класса с последующим формированием иерархического словаря и его отображением в онтологически интерпретируемое представление. Адаптация предложенного ПрК к другому набору данных выполняется поэтапно и не требует полной переработки, однако её трудоёмкость зависит от конкретной прикладной задачи:
-
■ определяется новая схема целевых сущностей и их соответствие существующим меткам ( PER, ORG, DATE, LAW, PUNISH и др.);
-
■ корректируются или добавляются правила для формализуемых сущностей (номера дел, телефоны, адреса электронной почты, ссылки и правовые нормы);
-
■ дообучается NER -модель на размеченной выборке;
-
■ составляются грамматики синтаксического анализатора и интерпретационные правила, связывающие сущности в итоговую структуру JSON -представления;
-
■ JSON -документ преобразуется в шаблон онтологии в формате RDF/OWL/Turtle .
Заключение
По результатам проведённого исследования сформулированы следующие выводы.
-
■ Разработан ПрК, позволяющий осуществить сбор и нормализацию текстовых данных из различных электронных форматов, лексический анализ с извлечением именованных сущностей, синтаксический анализ с построением АСД и формирование машиночитаемого представления фактов в виде иерархических словарей.
-
■ Показано, что формирование иерархических словарей в формате JSON на основе выделенных сущностей и отношений позволяет рассматривать полученные структуры как шаблоны онтологий ПрО, пригодные для интеграции в базы знаний и системы поиска.
-
■ Оценка на специализированном наборе данных решений ФАС подтвердила работоспособность ПрК и показала возможность гибкой его конфигурации для решения задач извлечения и структурирования фактов из текстов на ЕЯ.